diff --git a/hzh/GolangStar/Go语言原理/gmp调度原理.md b/hzh/GolangStar/Go语言原理/gmp调度原理.md
index 0cd0eed..42f32fc 100644
--- a/hzh/GolangStar/Go语言原理/gmp调度原理.md
+++ b/hzh/GolangStar/Go语言原理/gmp调度原理.md
@@ -7,1511 +7,16 @@ create time: 2026-06-07 15:50
## 概述
-本文从宏观架构到微观源码,全方位解析 Go 的 GMP 调度模型。涵盖 G/M/P 三大组件的数据结构、goroutine 的创建与调度流程、主动让渡机制(yield)、以及 sysmon 线程发起的抢占式调度。这是理解 Go 并发性能的核心篇章。
-
-> [!question] ❓ 思考
-> 为什么 Go 不直接使用操作系统线程来管理并发,而要发明 GMP 这套中间层?当一个 goroutine 阻塞在 IO 上时,整个程序的其他 goroutine 还会继续执行吗?
+本文从宏观架构到微观源码,全方位解析 Go 的 GMP 调度模型。由于内容较长,已拆分为以下子文档,建议按顺序阅读。
---
-聊到Go语言,大家最津津乐道的可能就是它那"天生强大"的并发能力了。一个简单的 `go` 关键字,就能开启一个并发执行单元,这酸爽,谁用谁知道。但是,你有没有想过,这背后到底藏着什么样的魔法?为什么Go的并发可以如此轻盈、如此高效?
-
-
-答案,就藏在它核心的 **GMP调度模型**里。
-
-很多Gopher对GMP可能只是略知一二,知道有G、M、P这三个角色,但它们之间是如何协作的,一个goroutine又是如何被创建、调度、甚至是被"抢占"的,可能就有点模糊了。
-
-不怕!今天,就带着大家把GMP这块硬骨头彻底啃下来。咱们不光要搞懂理论,还要深入`v1.19`的源码,把它的底层设计看个底朝天。这篇文章会分成两大部分,从宏观到微观,带你彻底搞懂Go语言的设计精髓,GMP调度。
-
-* **第一部分:宏观视角**
-
- * **第一小节:从基础聊起**:咱们先热个身,聊聊线程、协程这些基本概念,看看Go的goroutine是如何站在巨人肩膀上的。
-
- * **第二小节:GMP设计图纸**:直接上源码,看看G、M、P这三个核心组件在底层到底长啥样。
-
-* **第二部分:微观之旅**
-
- * **第三小节:一个G的诞生与执行**:跟着一个goroutine的视角,看它是如何被创建并被调度器翻牌子执行的。
-
- * **第四小节:G的主动让贤**:看看一个正在运行的goroutine是如何主动让出CPU,把机会留给其他G的。
-
- * **第五小节:霸道的调度器**:当一个G"占着茅坑不拉屎",长期占用CPU时,我们的监控者是如何强制把它"请"下来的。
-
-## 1. 故事的开始:了解基础概念
-
-### 1.1 从线程到协程
-
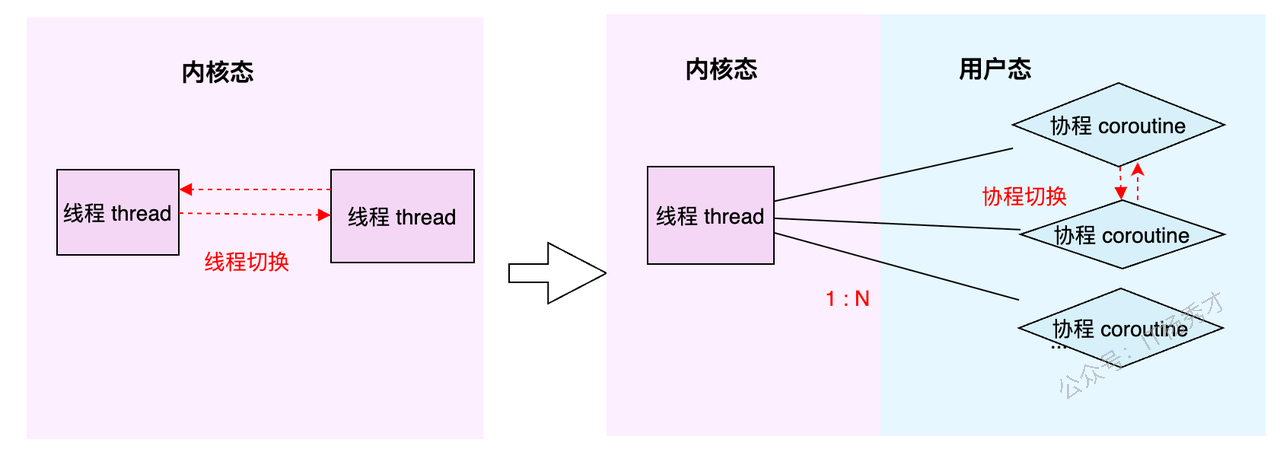
-在聊GMP之前,我们得先搞明白两个老朋友:**线程(Thread)** 和 **协程(Coroutine)**。
-
-
-
-* **线程(Thread)**:这家伙是操作系统的大内总管——内核(Kernel)眼里的最小执行单元。它的生老病死、工作调度,全得听内核的号令。你可以把它想象成一个正式工,有编制,但每次调度(切换)都得走一套复杂的流程,成本比较高。
-
-* **协程(Coroutine)**:这家伙更像是用户自己请的临时工。它活在用户态,比线程更轻量,可以理解为用户态线程。多个协程可以在一个线程上跑,它们的调度切换由用户程序自己说了算,不用去麻烦内核这个大忙人。所以,协程的切换开销极小,非常灵活。
-
-简单总结一下:线程是内核级的,重而稳;协程是用户级的,轻而快。
-
-### 1.2 Go的答案:goroutine
-
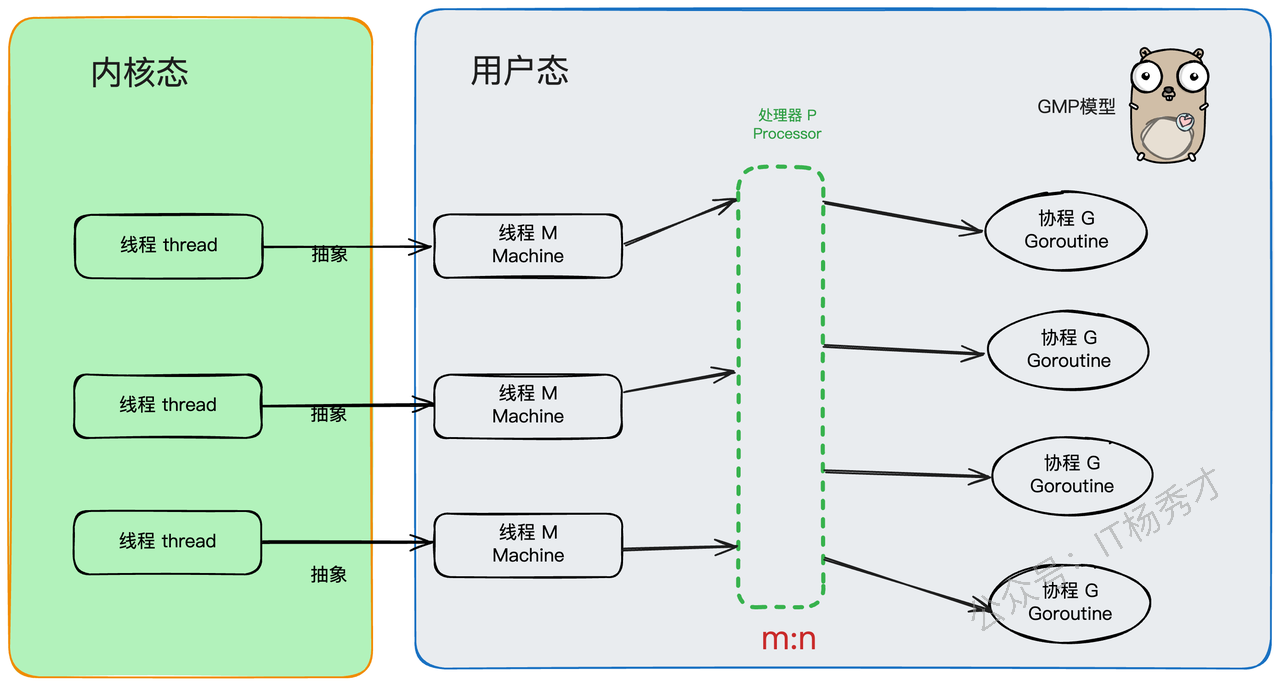
-Go语言选择的并发实现,就是我们所熟知的 **goroutine**。你可以把它看作是Go对协程的"超级魔改版"。它并不是一个孤立的概念,而是整个 **GMP调度体系** 的核心产物。
-
-
-
-正是因为有了GMP这套精妙的架构,goroutine才拥有了超越原生协程的两大核心优势:
-
-1. **灵活的调度**:G(goroutine)、M(Machine,内核线程)、P(Processor,处理器)三者之间可以动态地绑定和解绑,整个调度过程充满了弹性。
-
-2. **动态的栈空间**:每个goroutine的栈空间可以根据需要自动伸缩,既方便使用,又极大地节约了内存资源。
-
-更牛的是,Go语言在顶层完全屏蔽了线程这个概念,所有的并发操作都是围绕着goroutine来的,就像秦始皇统一了度量衡,Go也用goroutine统一了并发江湖的秩序。
-
-### 1.3 GMP架构全景图
-
-好了,主角登场!GMP,顾名思义,就是 **G**oroutine + **M**achine + **P**rocessor。
-
-* **G(Goroutine)**:就是我们的"任务单元"。它有自己的执行栈、生命状态,以及要完成的具体工作(就是你 `go` 后面跟的那个函数)。G需要绑定到M上才能运行,你可以把M想象成G的CPU。
-
-* **M(Machine)**:你可以把它看作Go对系统线程的封装,是真正干活的"工人"。M需要和P"绑定"后,才能进入GMP的调度循环。M的工作很简单,就是在`g0`(一个特殊的goroutine,负责调度)和普通的G之间反复横跳:执行`g0`时,它在找任务;执行普通G时,它在处理任务。
-
-* **P(Processor)**:P是调度器,是GMP模型中的"中枢大脑"。M必须获取到一个P,才能开始调度和执行G。P的数量决定了同一时间最多有多少个M可以处于运行状态,这个数量通常由 `GOMAXPROCS` 环境变量决定。P还有一个非常重要的职责:它自带一个本地的goroutine队列,我们称之为 **LRQ (Local Run Queue)**。
-
-G、M、P 三者的关系可以用一张图来概括:
-
-```mermaid
-graph TB
- subgraph P1["P0 (Processor)"]
- LRQ0["LRQ: [G5, G6, G7]"]
- end
- subgraph P2["P1 (Processor)"]
- LRQ1["LRQ: [G8]"]
- end
- GRQ["GRQ 全局队列
[G1, G2, G3, G4]"]
- M0["M0 (OS Thread)"] -->|绑定| P0_node["P0"]
- M1["M1 (OS Thread)"] -->|绑定| P1_node["P1"]
- P0_node --> LRQ0
- P1_node --> LRQ1
- LRQ0 -.偷取.-> LRQ1
- LRQ1 -.偷取.-> LRQ0
- GRQ -->|LRQ空时取| P0_node
- GRQ -->|LRQ空时取| P1_node
-
- style GRQ fill:#fff9c4
- style LRQ0 fill:#e8f5e9
- style LRQ1 fill:#e8f5e9
-```
-
-> [!tip] 💡 类比理解
-> 把 GMP 想象成一个工厂:
-> - **G** = 工作任务(如"组装一台手机")
-> - **M** = 工人(真正干活的 OS 线程)
-> - **P** = 车间主管(管理工人、分配任务)
-> - **LRQ** = 每个主管面前的待办清单
-> - **GRQ** = 工厂公共公告栏上的大清单
-> - **work-stealing** = 闲着的工人去隔壁忙不过来的车间"偷"活干
-
-
-
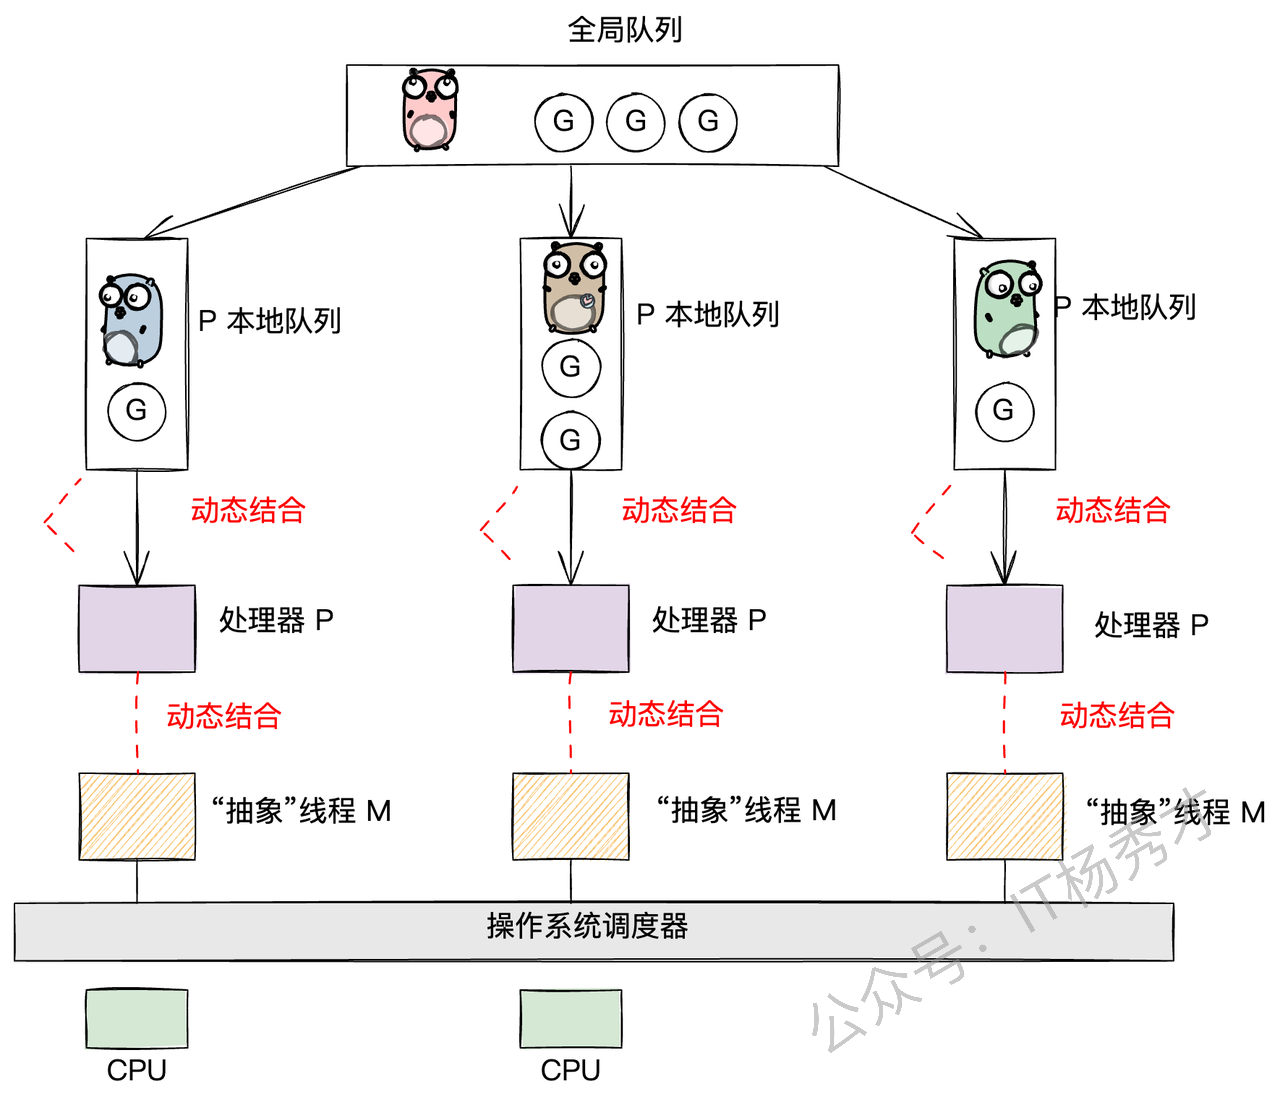
-现在,我们把目光聚焦到存放G的"容器"上。Go的设计非常巧妙,它有两种队列:
-
-1. **P 的本地队列(LRQ - Local Run Queue)**:每个 P 私有的 G 队列,最多存 256 个 G。优先无锁 CAS 操作存取,极少加锁。当 LRQ 满了或需要负载均衡时,会触发 **work-stealing** 机制——从其他 P 的 LRQ 中"偷"一半过来。
-
-2. **全局队列(GRQ - Global Run Queue)**:所有 M 共享的 G 队列,访问需加全局锁 `sched.lock`。新创建的 G 在 LRQ 满时被放入 GRQ。
-
-**G 的存放与获取逻辑**:
-
-* **放 G(put g)**:`go func(){...}` 创建的新 goroutine 优先放入当前 P 的 LRQ。LRQ 满了才加锁放入 GRQ。遵循"就近原则"。
-
-* **取 G(get g)**:M 上的 `g0` 找任务时按以下优先级:
-
-```mermaid
-flowchart TD
- LRQ["1. 当前 P 的 LRQ
无锁 CAS,最快"] -->|空| GRQ{"2. 全局 GRQ
需加锁"}
- GRQ -->|空| NET{"3. netpoll IO就绪
非阻塞 epoll_wait"}
- GRQ -->|有| GOT_G["找到 G ✓"]
- NET -->|有| GOT_G
- NET -->|空| STEAL{"4. 从其他 P 偷一半
work-stealing"}
- STEAL -->|成功| GOT_G
- STEAL -->|失败| SLEEP["5. P/M 进入休眠"]
- style LRQ fill:#e8f5e9
- style GRQ fill:#fff3e0
- style NET fill:#fff9c4
- style STEAL fill:#ffebee
- style SLEEP fill:#eceff1
-```
-
-> [!note] 📝 防饥饿机制
-> 为了防止 GRQ 中的 G 被长期饿死(因为 M 总是优先从 LRQ 取),调度器规定:**每进行 61 次调度循环,就必须强制去 GRQ 取一次**。这保证了公平性。
-
-### 1.4 GMP生态圈
-
-在Go的世界里,GMP是绝对的基石。所有上层的建筑,比如内存管理、并发工具等,都是围绕着GMP模型来精心设计的。
-
-#### 1.4.1 内存管理
-
-
-
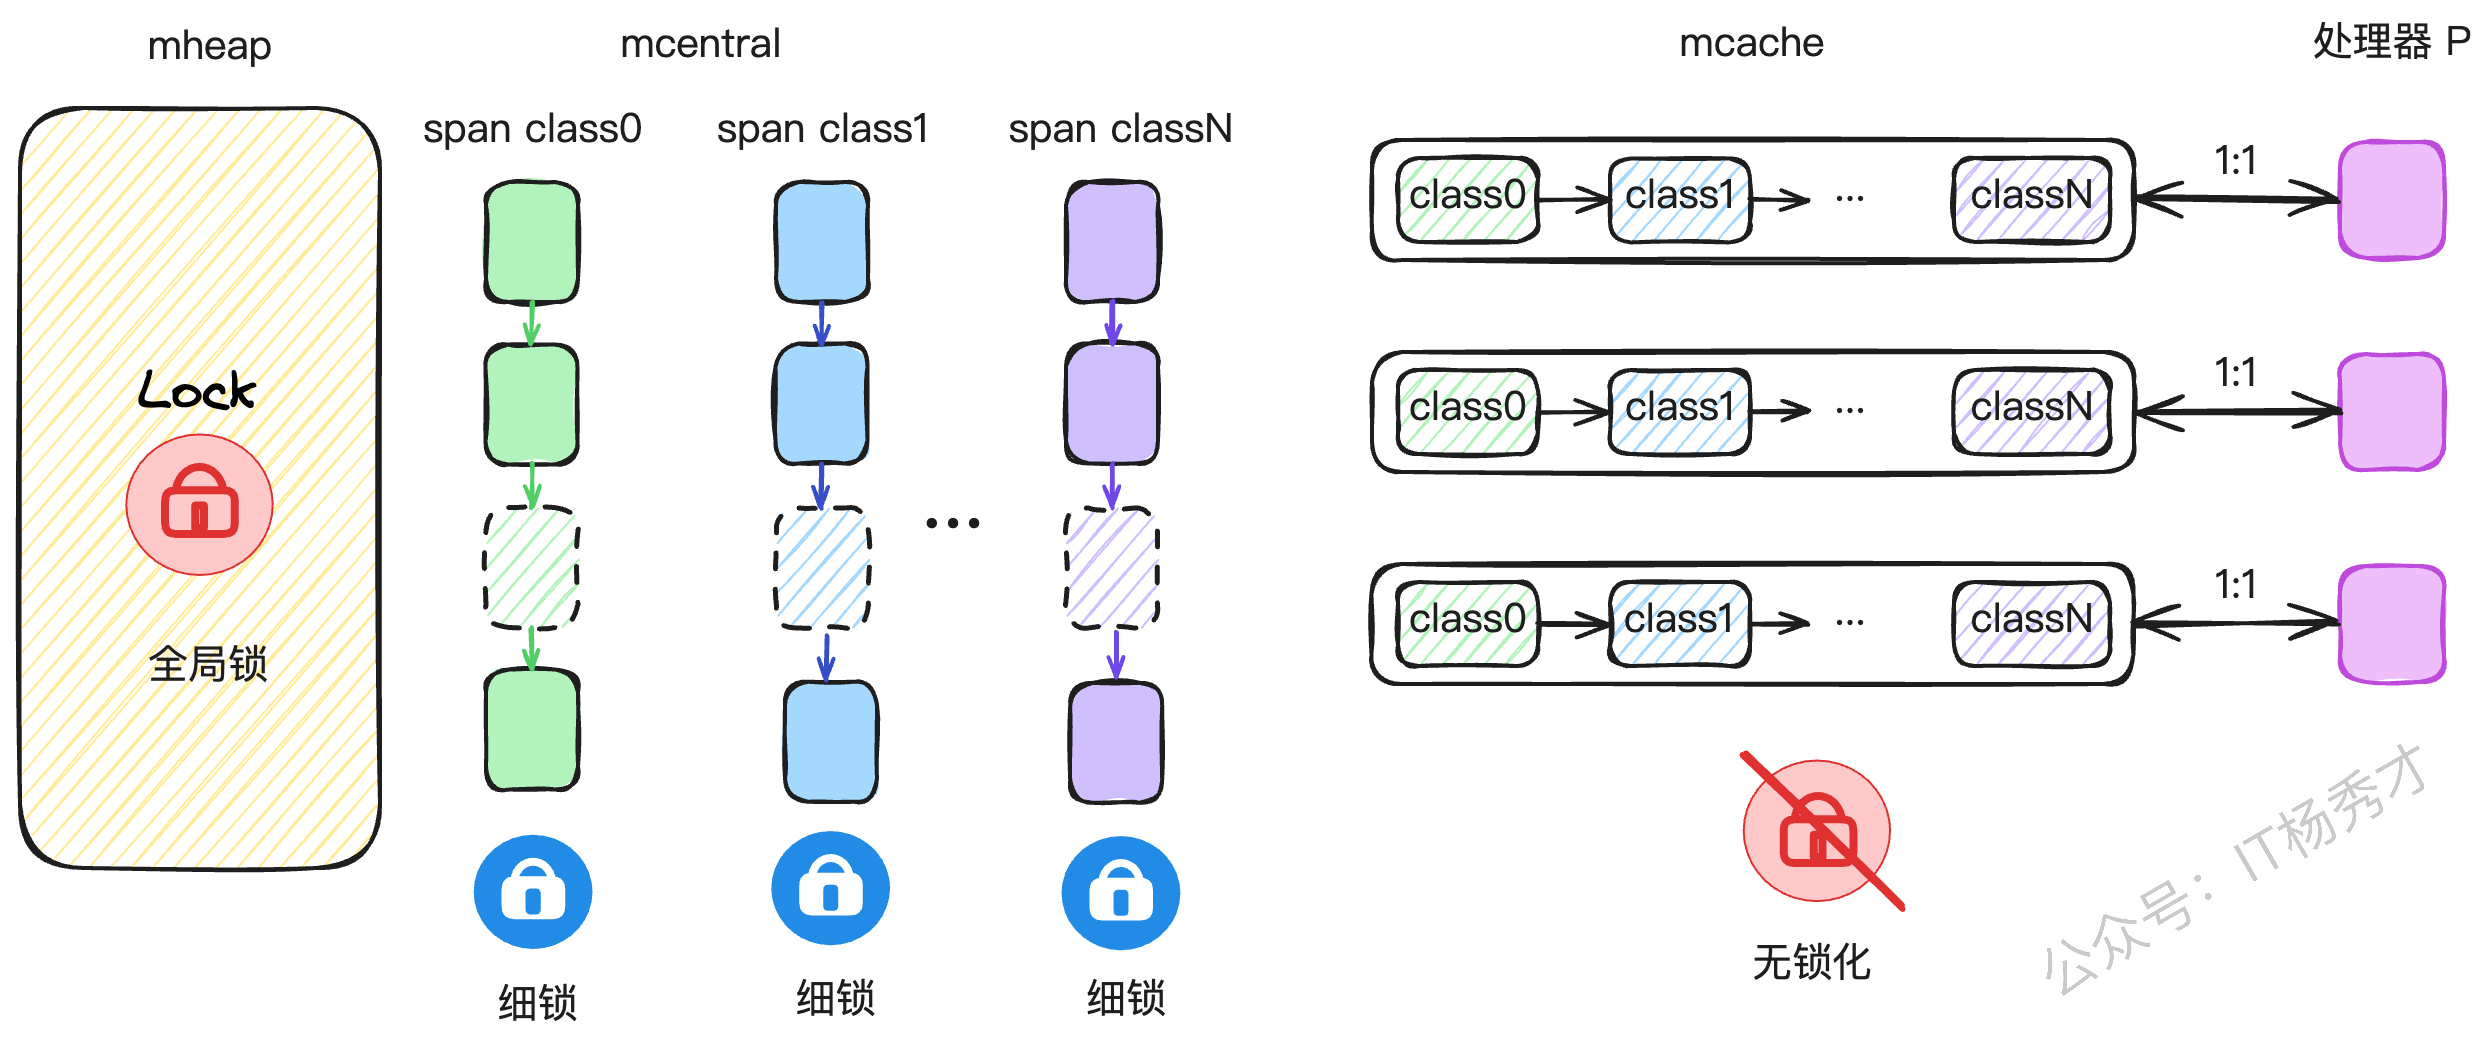
-Go的内存管理借鉴了Google自家的TCMalloc思想,并为GMP模型量身定做了优化。它为每个P都配备了一个私有的内存缓存——`mcache`。当一个P上的G需要分配小对象时,可以直接从这个私有的`mcache`里拿,完全无锁,速度飞快。
-
-#### 1.4.2 并发工具(Mutex, Channel)
-
-
-
-你有没有想过,为什么在Go里一个channel的读写阻塞了,或者一个Mutex锁住了,并不会把整个线程都卡死?
-
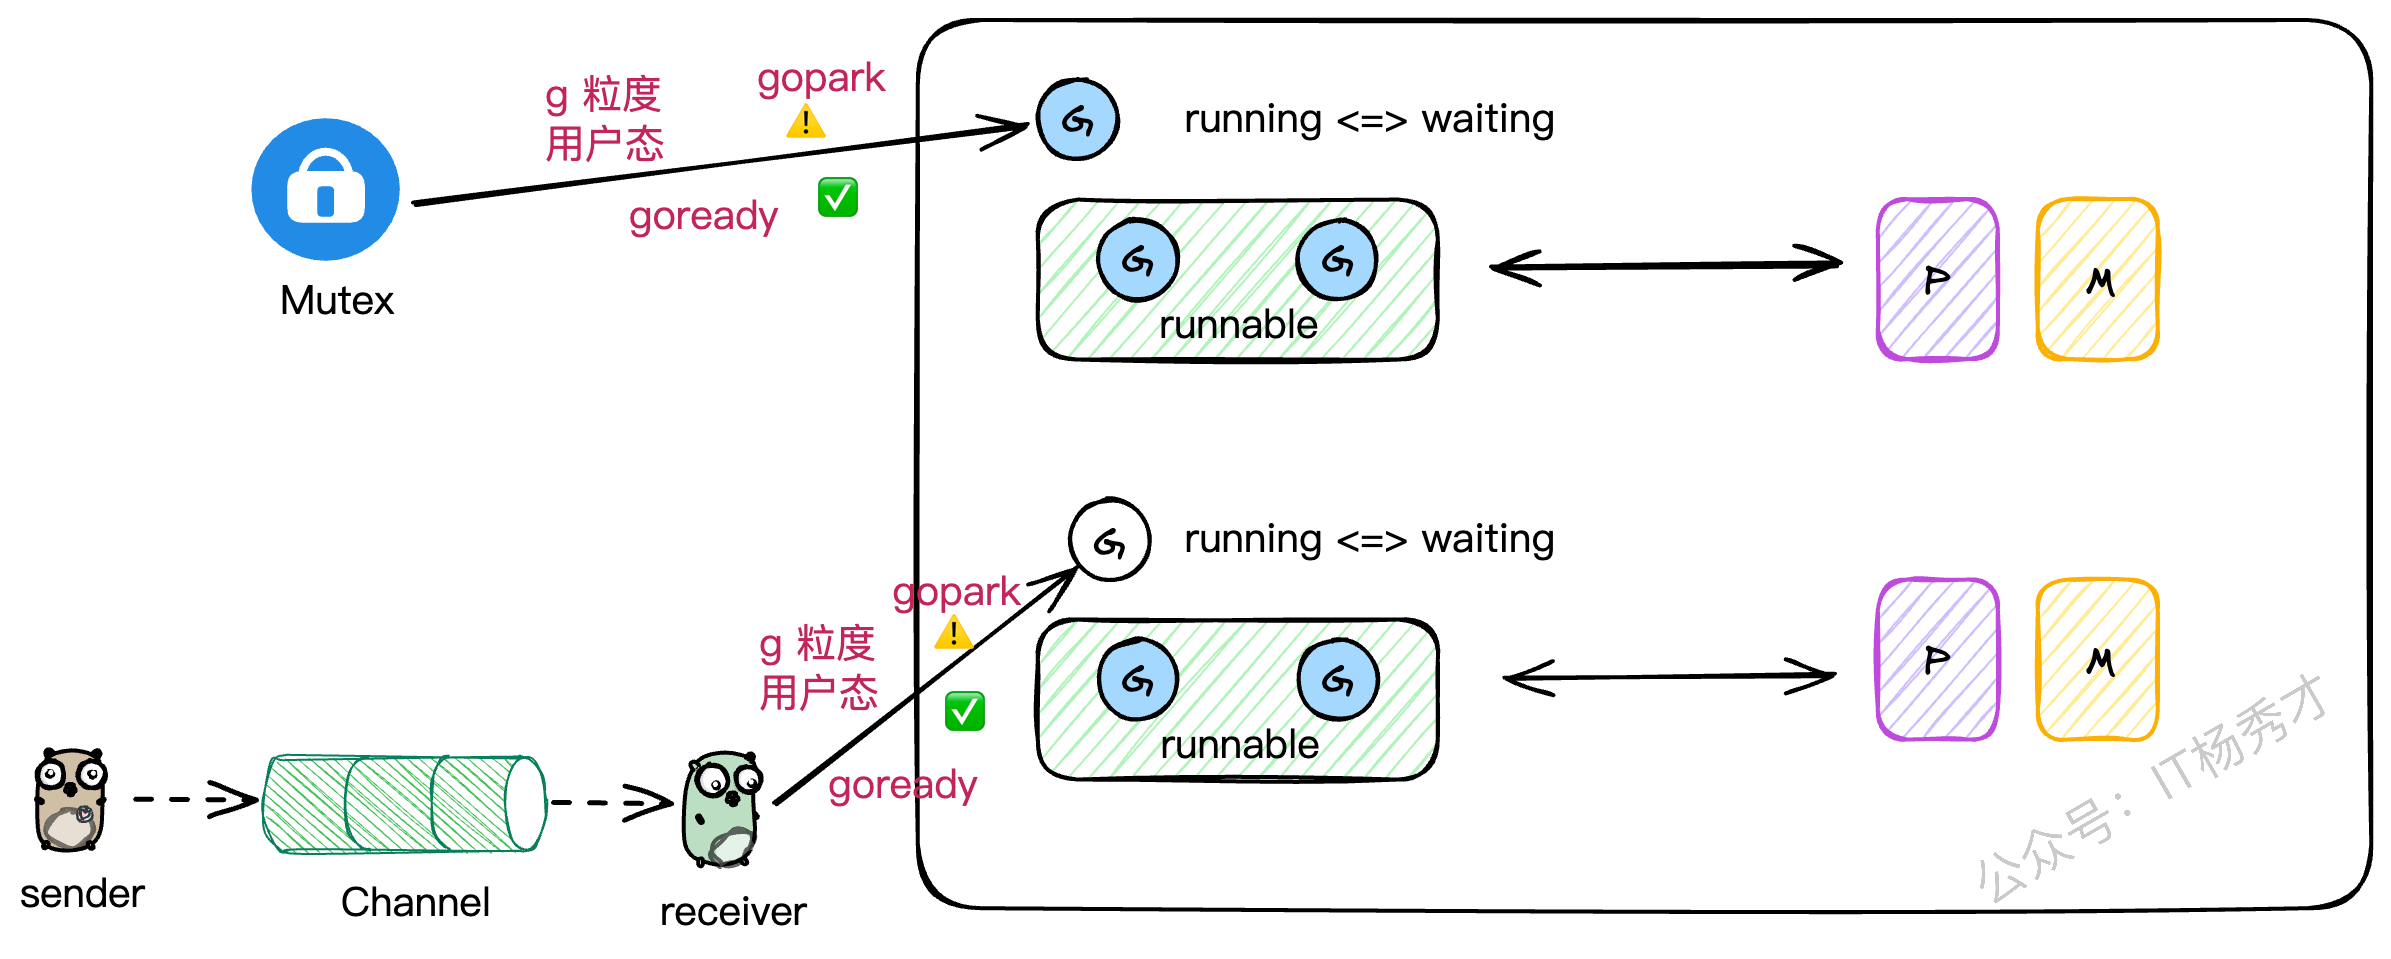
-这就是因为Go的并发工具都是"G级别"的。当一个G因为这些操作需要阻塞时,它会被挂起,让出M的执行权。M会立刻去寻找并执行其他的G,整个过程都在用户态完成,无需内核介入。这极大地提升了并发性能。
-
-我最近在用C++尝试模拟GMP时,就深有感触。C++标准库里的锁,一旦锁住,阻塞的是整个线程,这会导致线程上所有其他的协程都得干等着。想要实现Go这种效果,就得重写所有并发工具,成本巨大。这也反向证明了Go在并发设计上的优越性。
-
-#### 1.4.3 IO多路复用(netpoll)
-
-
-
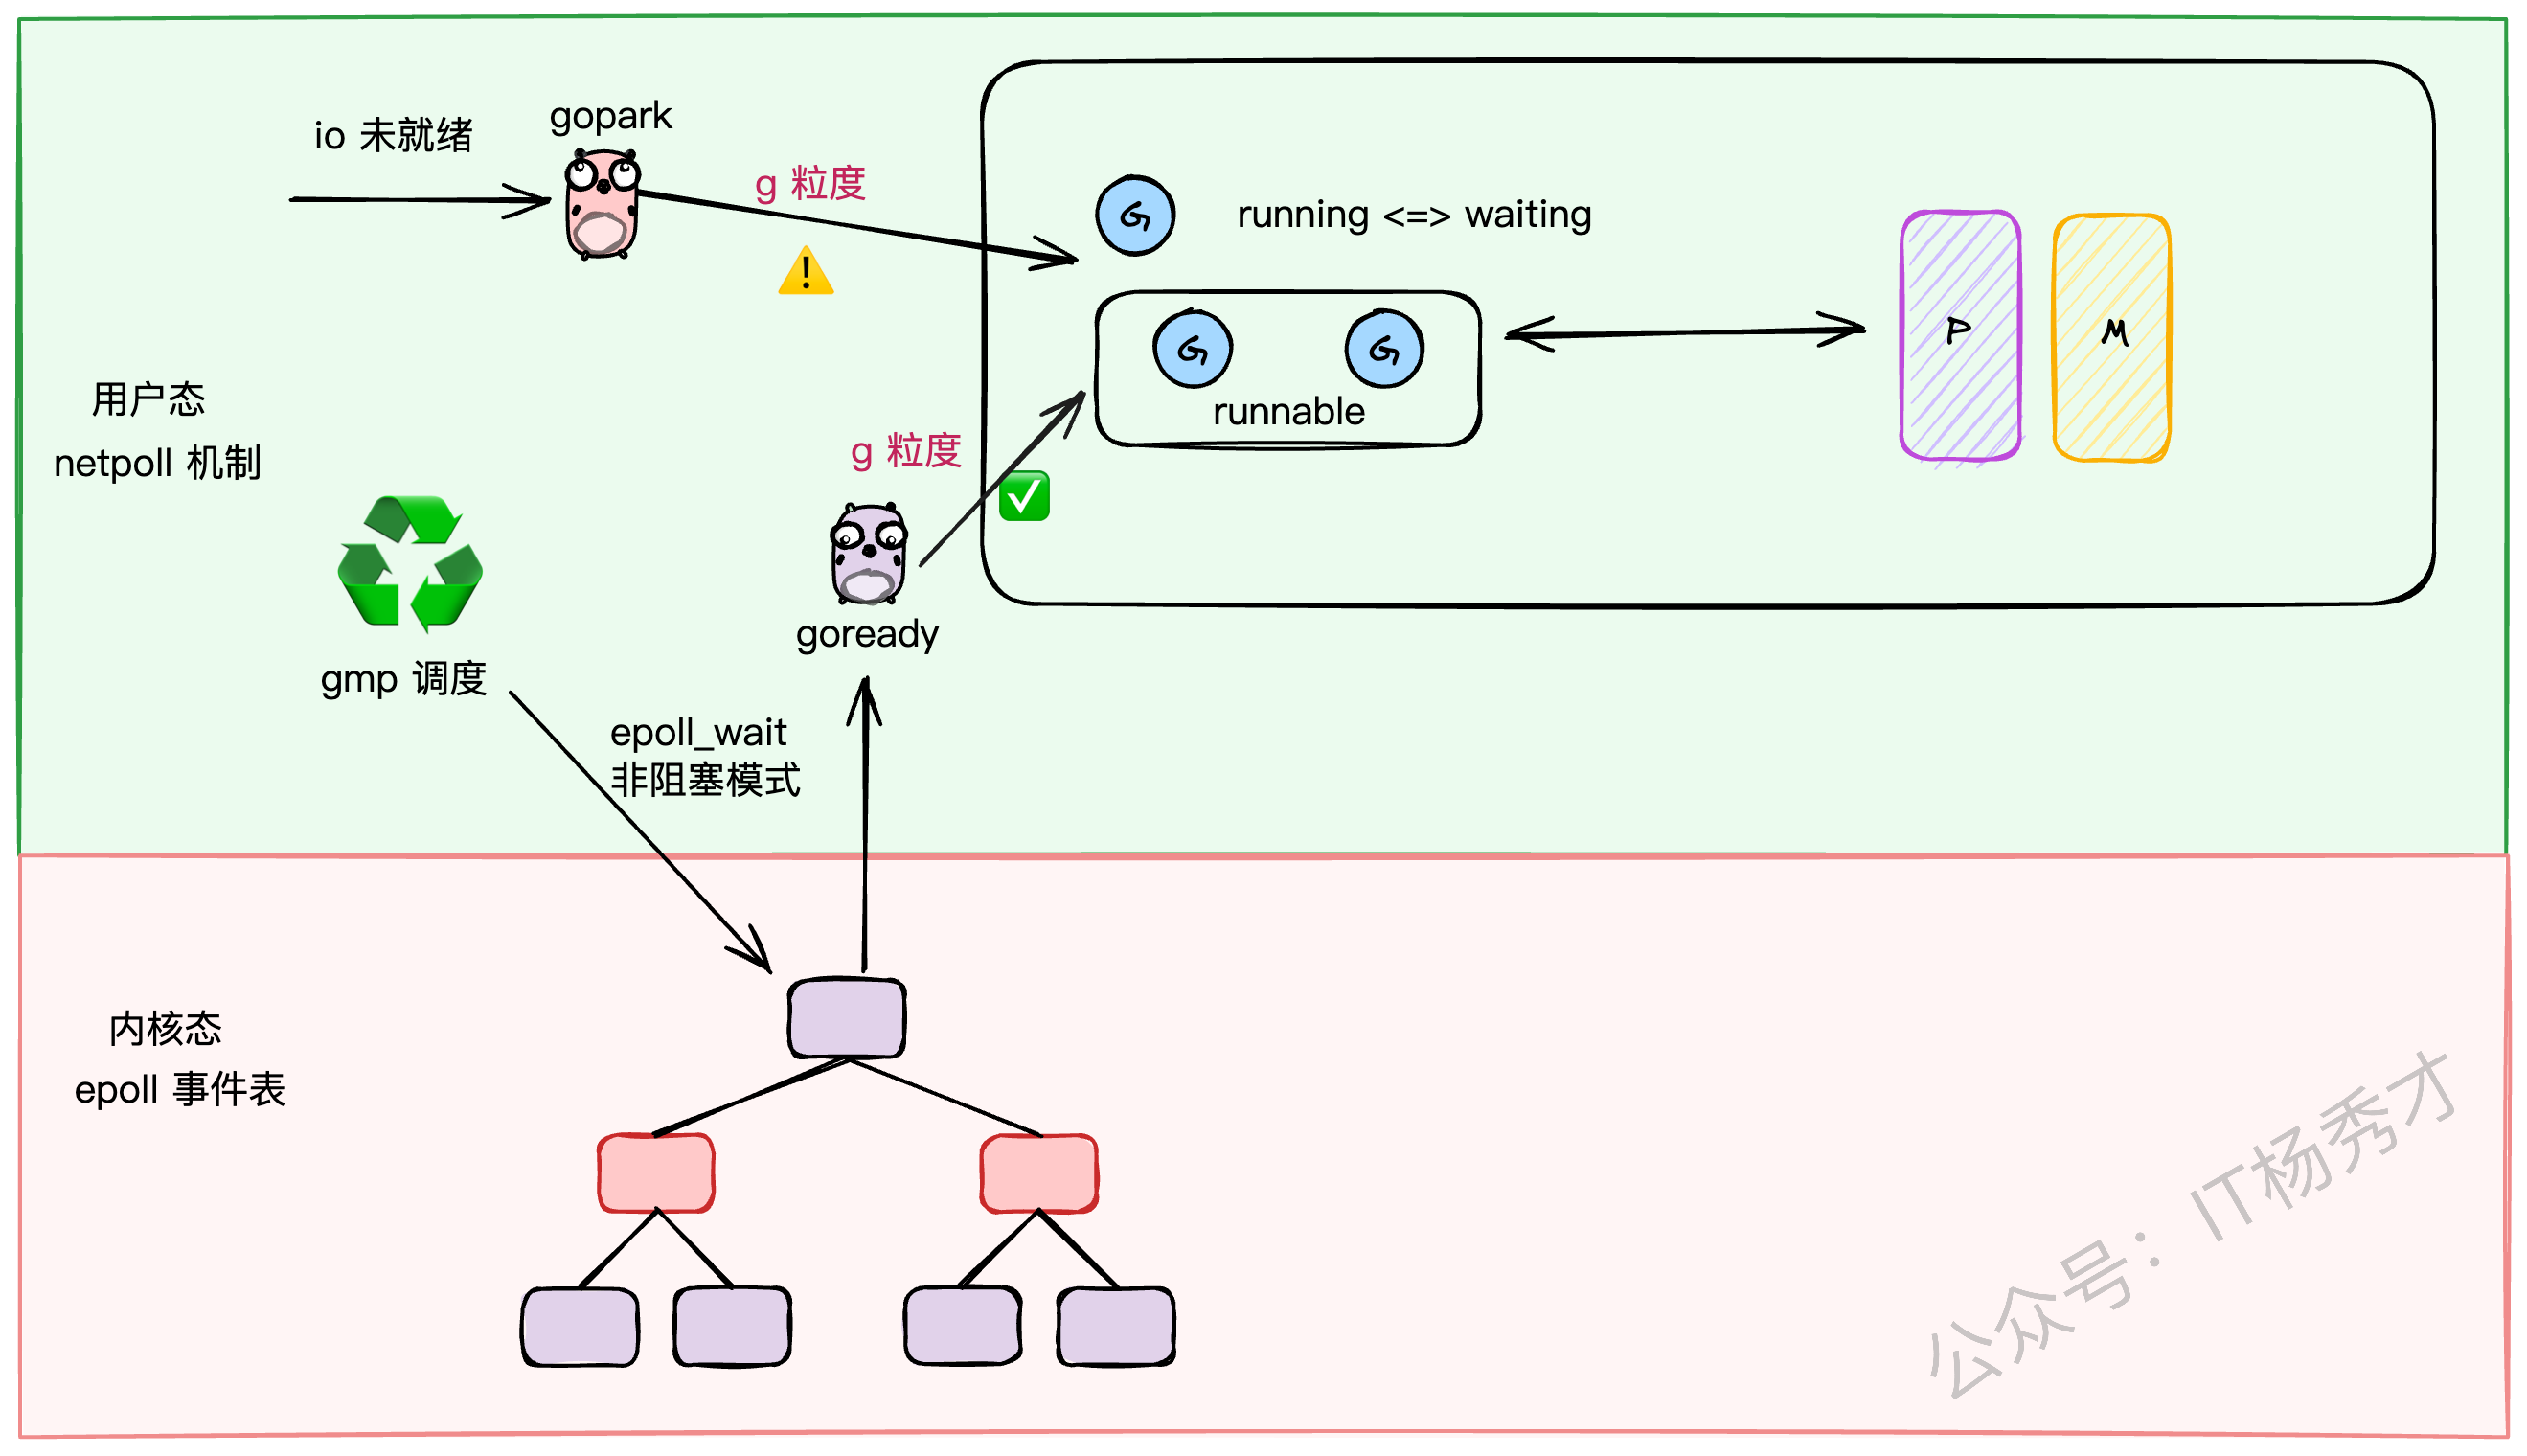
-对于网络IO,Go采用了Linux下性能强悍的epoll技术。但为了避免epoll的等待操作阻塞整个M,Go设计了一套巧妙的`netpoll`机制。它将IO阻塞操作转换成了G级别的阻塞(`gopark`),当IO就绪时,再通过`goready`唤醒对应的G。这样,IO操作也被完美地融入了GMP的调度体系中。
-
-可以说,不理解GMP,就无法真正理解Go语言的精髓。
-
-## 2. 深入源码:GMP的底层结构
-
-理论说了一大堆,我们现在就潜入源码,看看G、M、P在 `runtime/runtime2.go` 文件里到底长什么样。
-
-### 2.1 G的结构(goroutine)
-
-
-
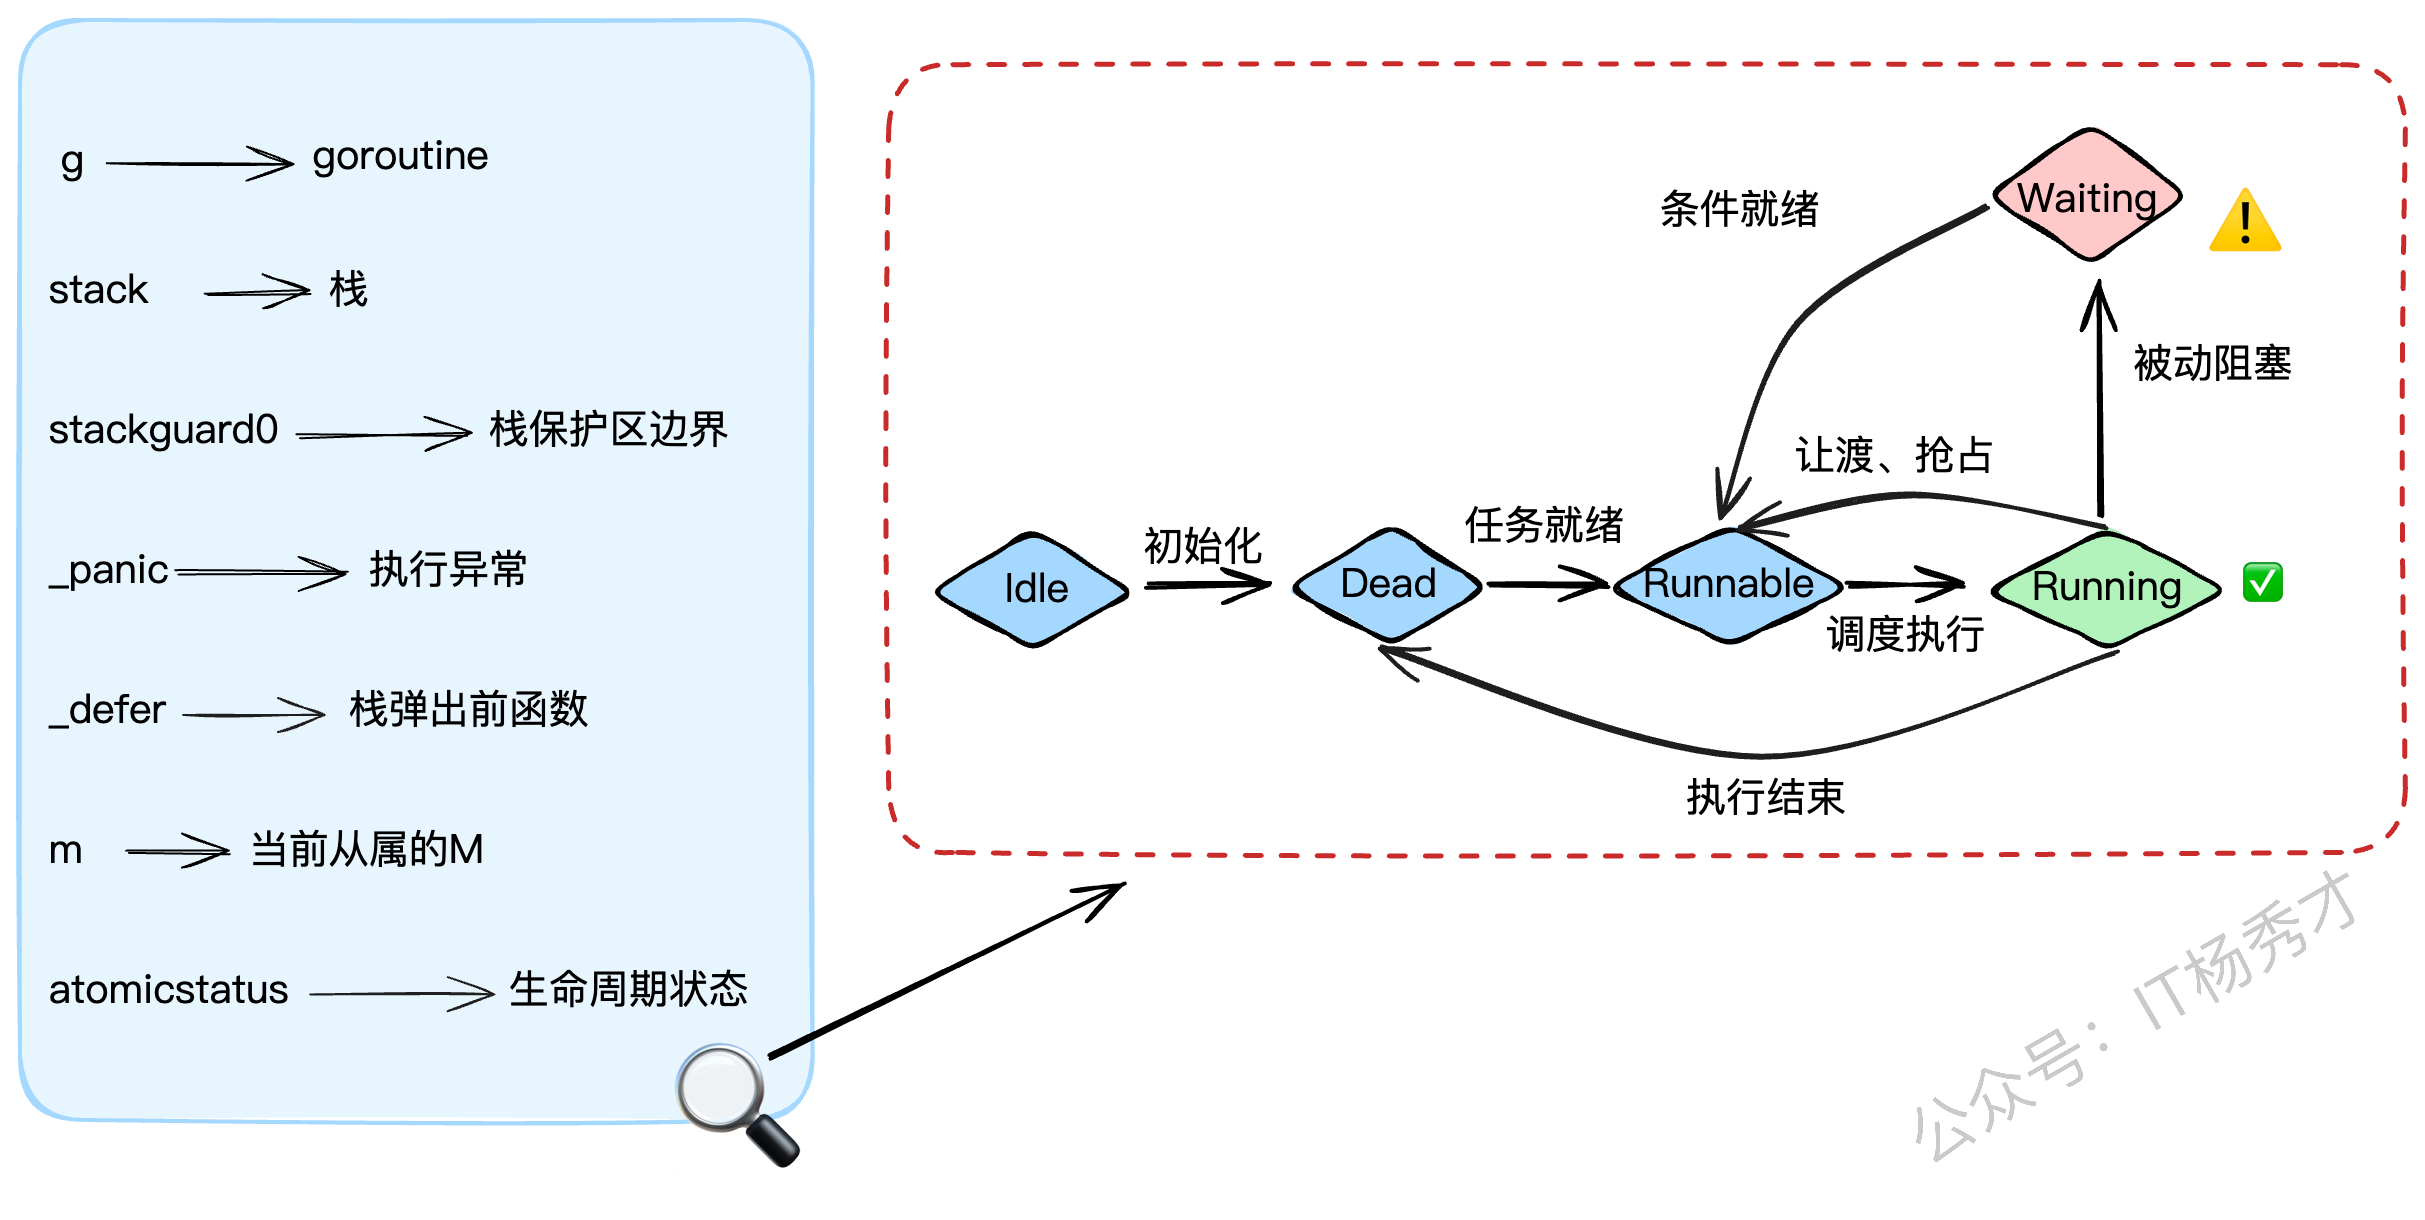
-`g`结构体是goroutine的实体,我们来看看它的关键字段:
-
-* `stack`: 描述了goroutine的栈空间信息(起始和结束地址)。
-
-* `stackguard0`: 栈的警戒线。当goroutine的栈使用量将要越过这条线时,就会触发栈扩容。同时,它也被用来标记"抢占请求"。
-
-* `_panic`: 用来记录goroutine中发生的panic。
-
-* `_defer`: 用链表的形式存储了goroutine中的defer操作(后进先出)。
-
-* `m`: 指向当前正在执行它的M。如果G没在运行,这个字段就是`nil`。
-
-* `atomicstatus`: G的生命周期状态,比如 `_Gidle`、`_Grunnable`、`_Grunning`、`_Gwaiting` 等。
-
-```go
-// g represents a goroutine.
-type g struct {
- // stack describes the goroutine's stack. The bounds are
- // [stack.lo, stack.hi).
- stack stack // goroutine的执行栈空间
- // stackguard0 is the stack pointer compared in the Go stack growth prologue.
- // It is stack.lo + _StackGuard.
- // It is also used to signal a request to preempt the goroutine.
- stackguard0 uintptr // 栈空间保护区边界,也用于传递抢占标识
-
- // ...
-
- _panic *_panic // 记录g执行过程中遇到的异常
- _defer *_defer // g中挂载的defer函数,是一个LIFO的链表结构
- m *m // 当前执行本g的m
-
- // atomicstatus is the status of the goroutine.
- // It is changed atomically with casgstatus.
- // This field is read and written atomically, and the values are not in the
- // GStatus enum.
- atomicstatus uint32 // g的状态
-
- // ...
-
- // schedlink is a link in the global run queue, idle g list, or gfree list.
- schedlink guintptr // 进入全局队列grq时指向相邻g的next指针
-}
-```
-
-### 2.2 M的结构(Machine)
-
-
-
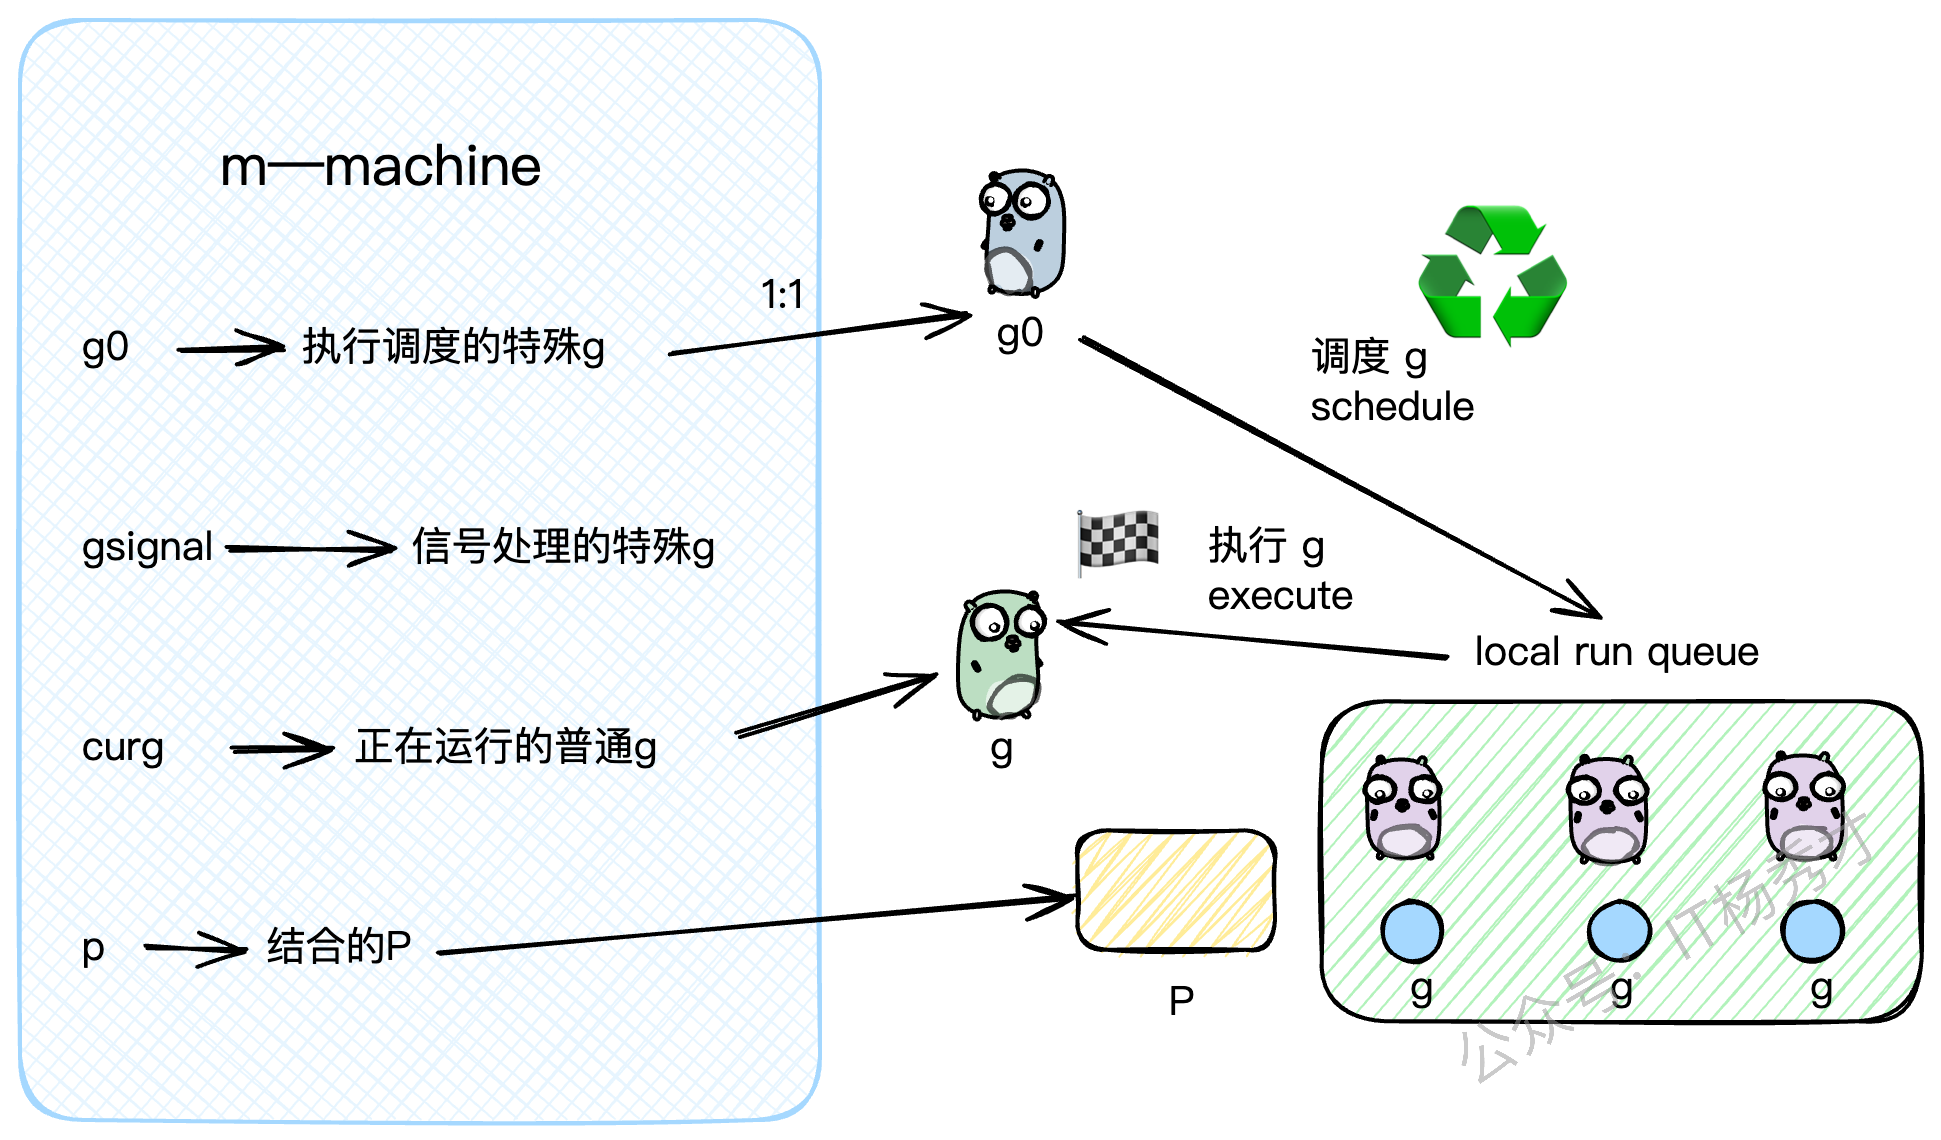
-`m`结构体是内核线程的抽象,核心字段如下:
-
-* `g0`: 一个非常特殊的G。每个M都有一个自己的`g0`,这个`g0`不执行用户代码,它的任务就是执行调度逻辑,为M寻找下一个要运行的普通G。
-
-* `gsignal`: 另一个特殊的G,专门用来处理分配给这个M的信号。
-
-* `curg`: 指向当前M上正在运行的那个普通的用户G。
-
-* `p`: 指向当前与M绑定的P。
-
-```go
-// m represents an OS thread.
-type m struct {
- g0 *g // 专门用于调度的g,每个M都有一个
- // ...
- procid uint64 // M的唯一ID
- gsignal *g // 用于处理信号的g
-
- curg *g // M上正在运行的普通g
- p puintptr // M关联的p
-
- // ...
-
- schedlink muintptr // M在空闲链表中的下一个M
-}
-```
-
-你可以把M的运行过程想象成两个状态的切换:当它在执行 `g0` 时,它在扮演"调度者"的角色;当它在执行 `curg` 时,它在扮演"执行者"的角色。
-
-### 2.3 P的结构(Processor)
-
-
-
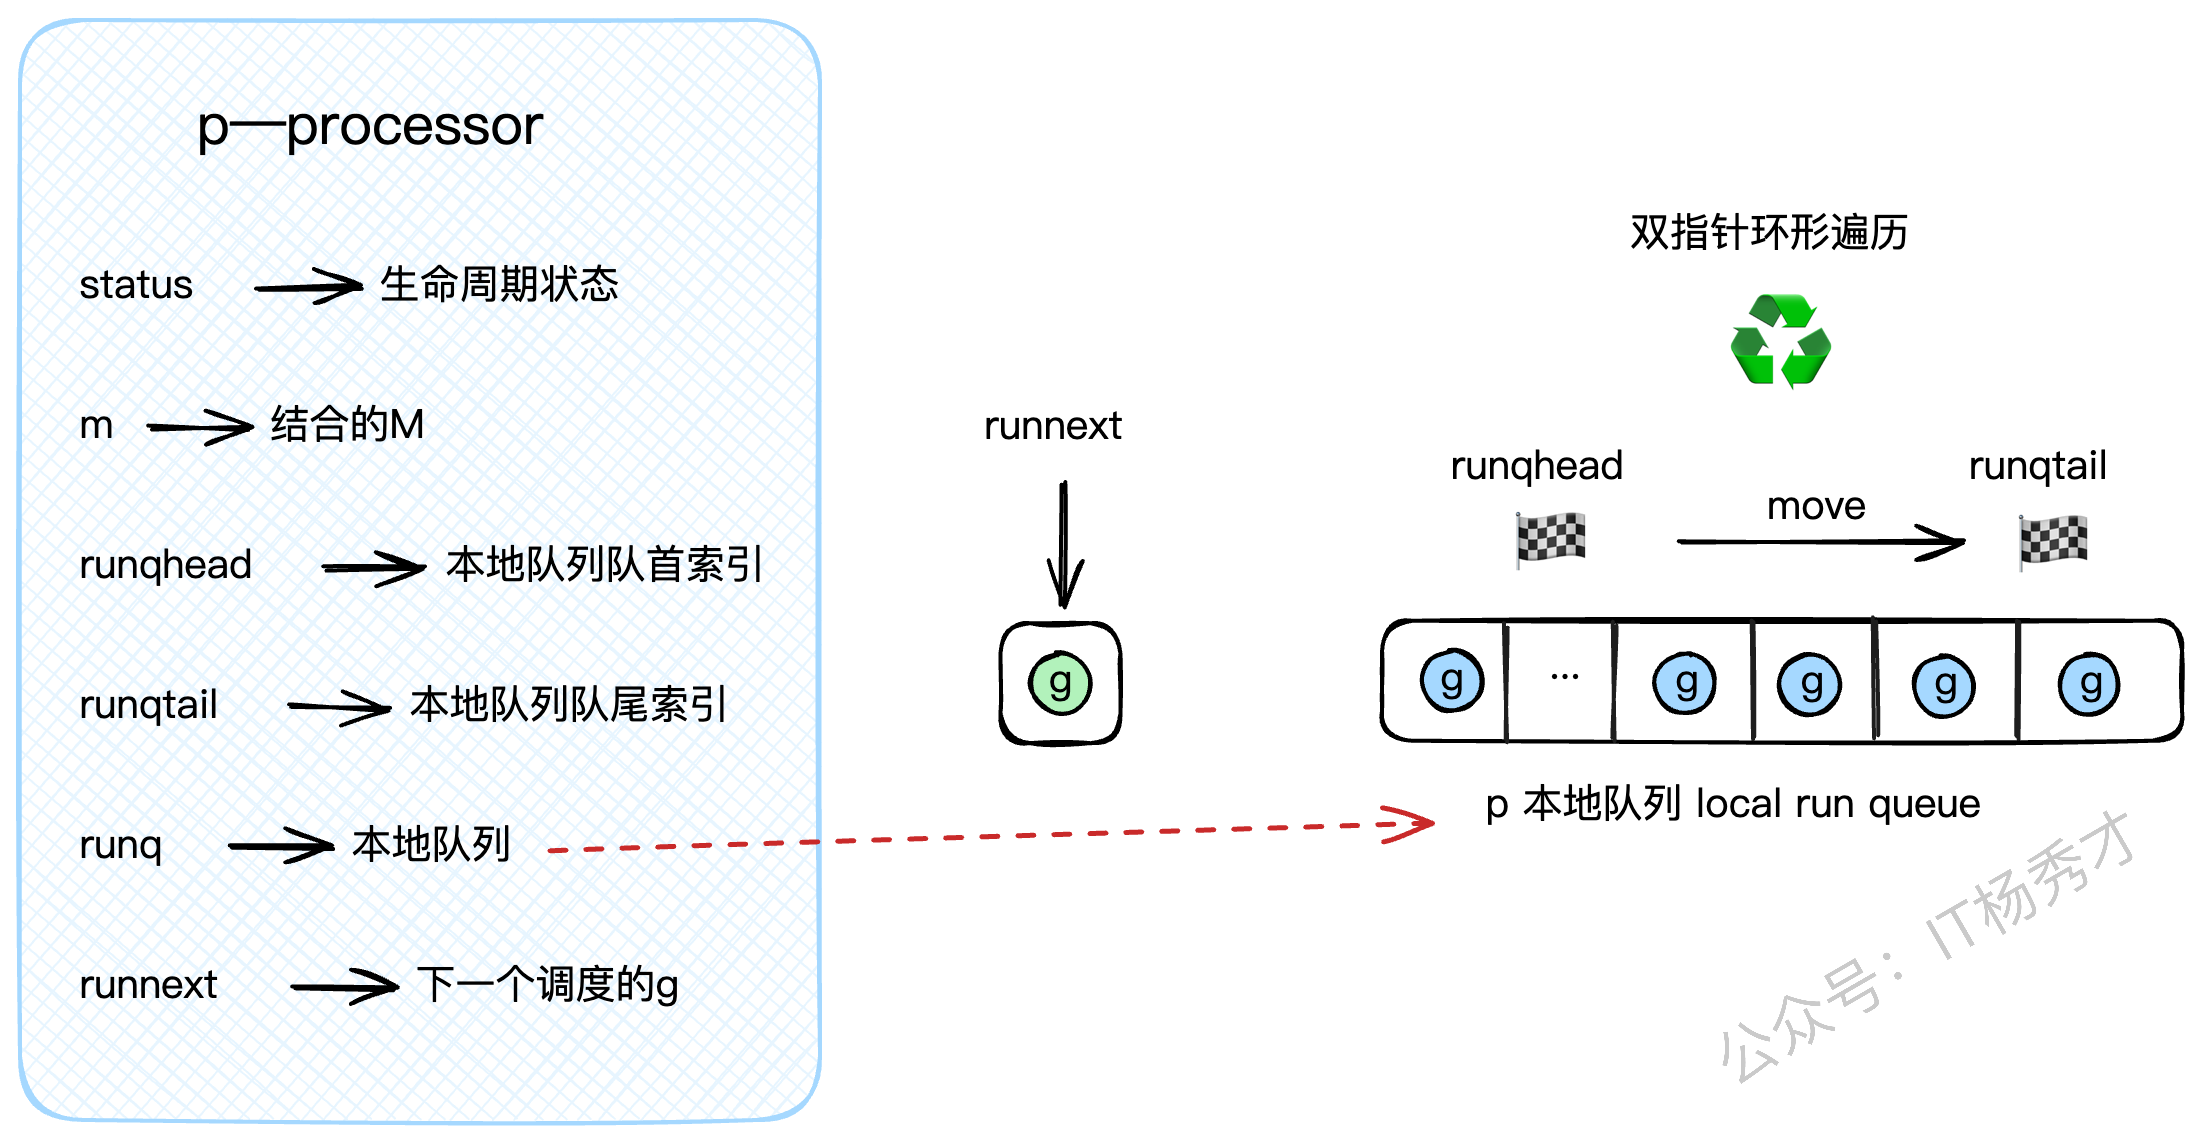
-`p`结构体是调度器,是连接G和M的桥梁,核心字段如下:
-
-* `status`: P的生命周期状态,如 `_Pidle`、`_Prunning` 等。
-
-* `m`: 指向当前与它绑定的M。
-
-* `runq`: P的私有G队列,也就是我们前面说的LRQ,它是一个定长的数组,可以存放256个G。
-
-* `runqhead`, `runqtail`: LRQ的头尾索引,用来实现一个环形队列。
-
-* `runnext`: LRQ里的一个"VIP通道"。通过 `runqput` 放入的下一个G会优先放在这里,调度器会首先检查 `runnext` 是否有G,有的话直接拿来执行,可以省去操作`runq`队列的开销。
-
-```go
-// p represents a processor.
-type p struct {
- id int32 // P的ID
- status uint32 // P的状态 (pidle, prunning, etc.)
- link puintptr
- schedtick uint32 // 每执行一次schedule,该值+1
- syscalltick uint32 // 每进行一次系统调用,该值+1
- m muintptr // 回指到关联的M (如果idle则为nil)
-
- // Queue of runnable goroutines. Accessed without lock.
- runqhead uint32
- runqtail uint32
- runq [256]guintptr // 本地G队列,即LRQ
- // runnext, if non-nil, is a runnable G that was ready'd by
- // the current G and should be run next instead of what's in
- // runq.
- runnext guintptr // 下一个要调度的G,可以看作是LRQ中的一个特权位置
-
- // ...
-}
-```
-
-### 2.4 全局调度器(schedt)
-
-
-
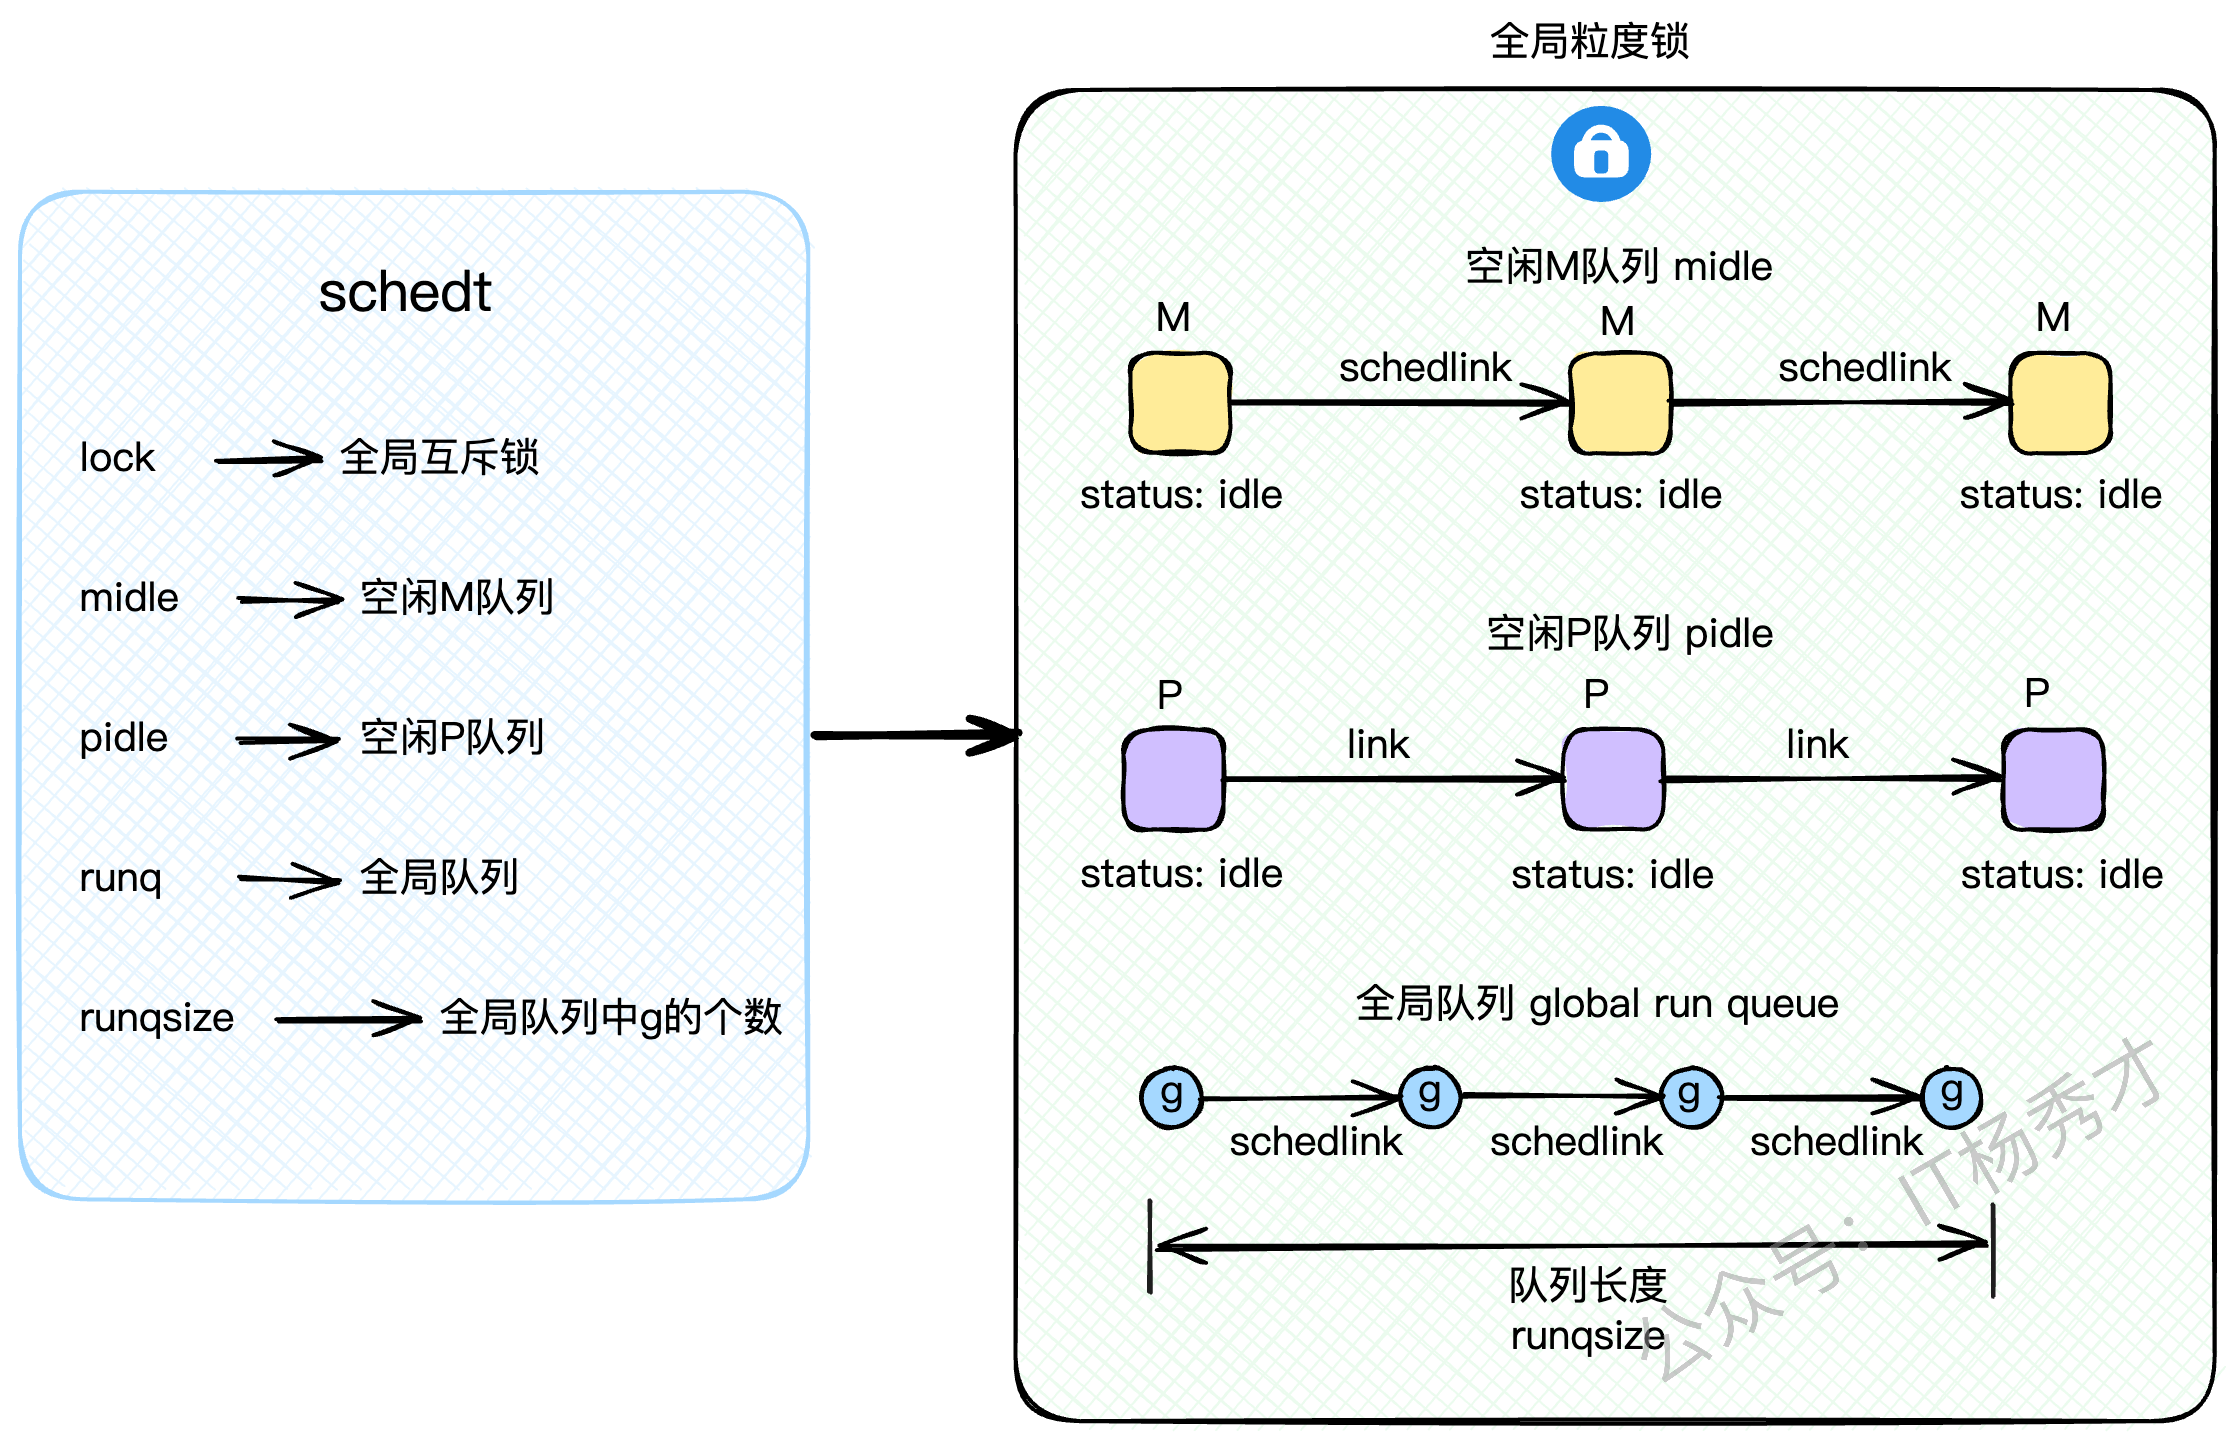
-除了G、M、P这三大组件,还有一个全局的 `schedt` 结构体,它掌管着全局资源,访问它需要加锁。
-
-* `lock`: 全局互斥锁。
-
-* `midle`: 空闲的M队列,没活干的M会在这里排队。
-
-* `pidle`: 空闲的P队列,没活干的P也在这里排队。
-
-* `runq`: 全局G队列,也就是GRQ。
-
-* `runqsize`: GRQ里G的数量。
-
-```go
-// 全局调度模块
-type schedt struct{
- // ...
- // 互斥锁
- lock mutex
-
- // 空闲 m 队列
- midle muintptr // idle m's waiting for work
- // ...
- // 空闲 p 队列
- pidle puintptr // idle p's
- // ...
-
- // 全局 g 队列——grq
- runq gQueue
- // grq 中存量 g 的个数
- runqsize int32
- // ...
-}
-```
-
-> `midle`和 `pidle`\`的设计是为了资源的复用和节能。当系统不忙时,空闲的M和P会被放进这两个队列里"休眠",避免CPU空转,等到有新任务时再被唤醒。
-
-## 3. 正向追踪:一个G的诞生与调度
-
-好了,基础结构我们都看完了。现在,让我们切换到第一人称视角,看看一个我们用 `go func(){...}` 创建的goroutine,是如何一步步被调度并执行的。这个过程,可以看作是从 `g0`到 `g`的转换。
-
-### 3.1 main函数的特殊性
-
-`main`函数是所有Go程序的入口,它比较特殊。它是由一个全局唯一的 m0(主线程)来执行的。源码位于 runtime.proc.go
-
-```go
-// The main goroutine.
-func main() {
- // ...
- // 获取用户定义的 main.main 函数
- fn := main_main
- // 执行用户的 main 函数
- fn()
- // ...
-}
-```
-
-### 3.2 普通G的创建之旅
-
-
-
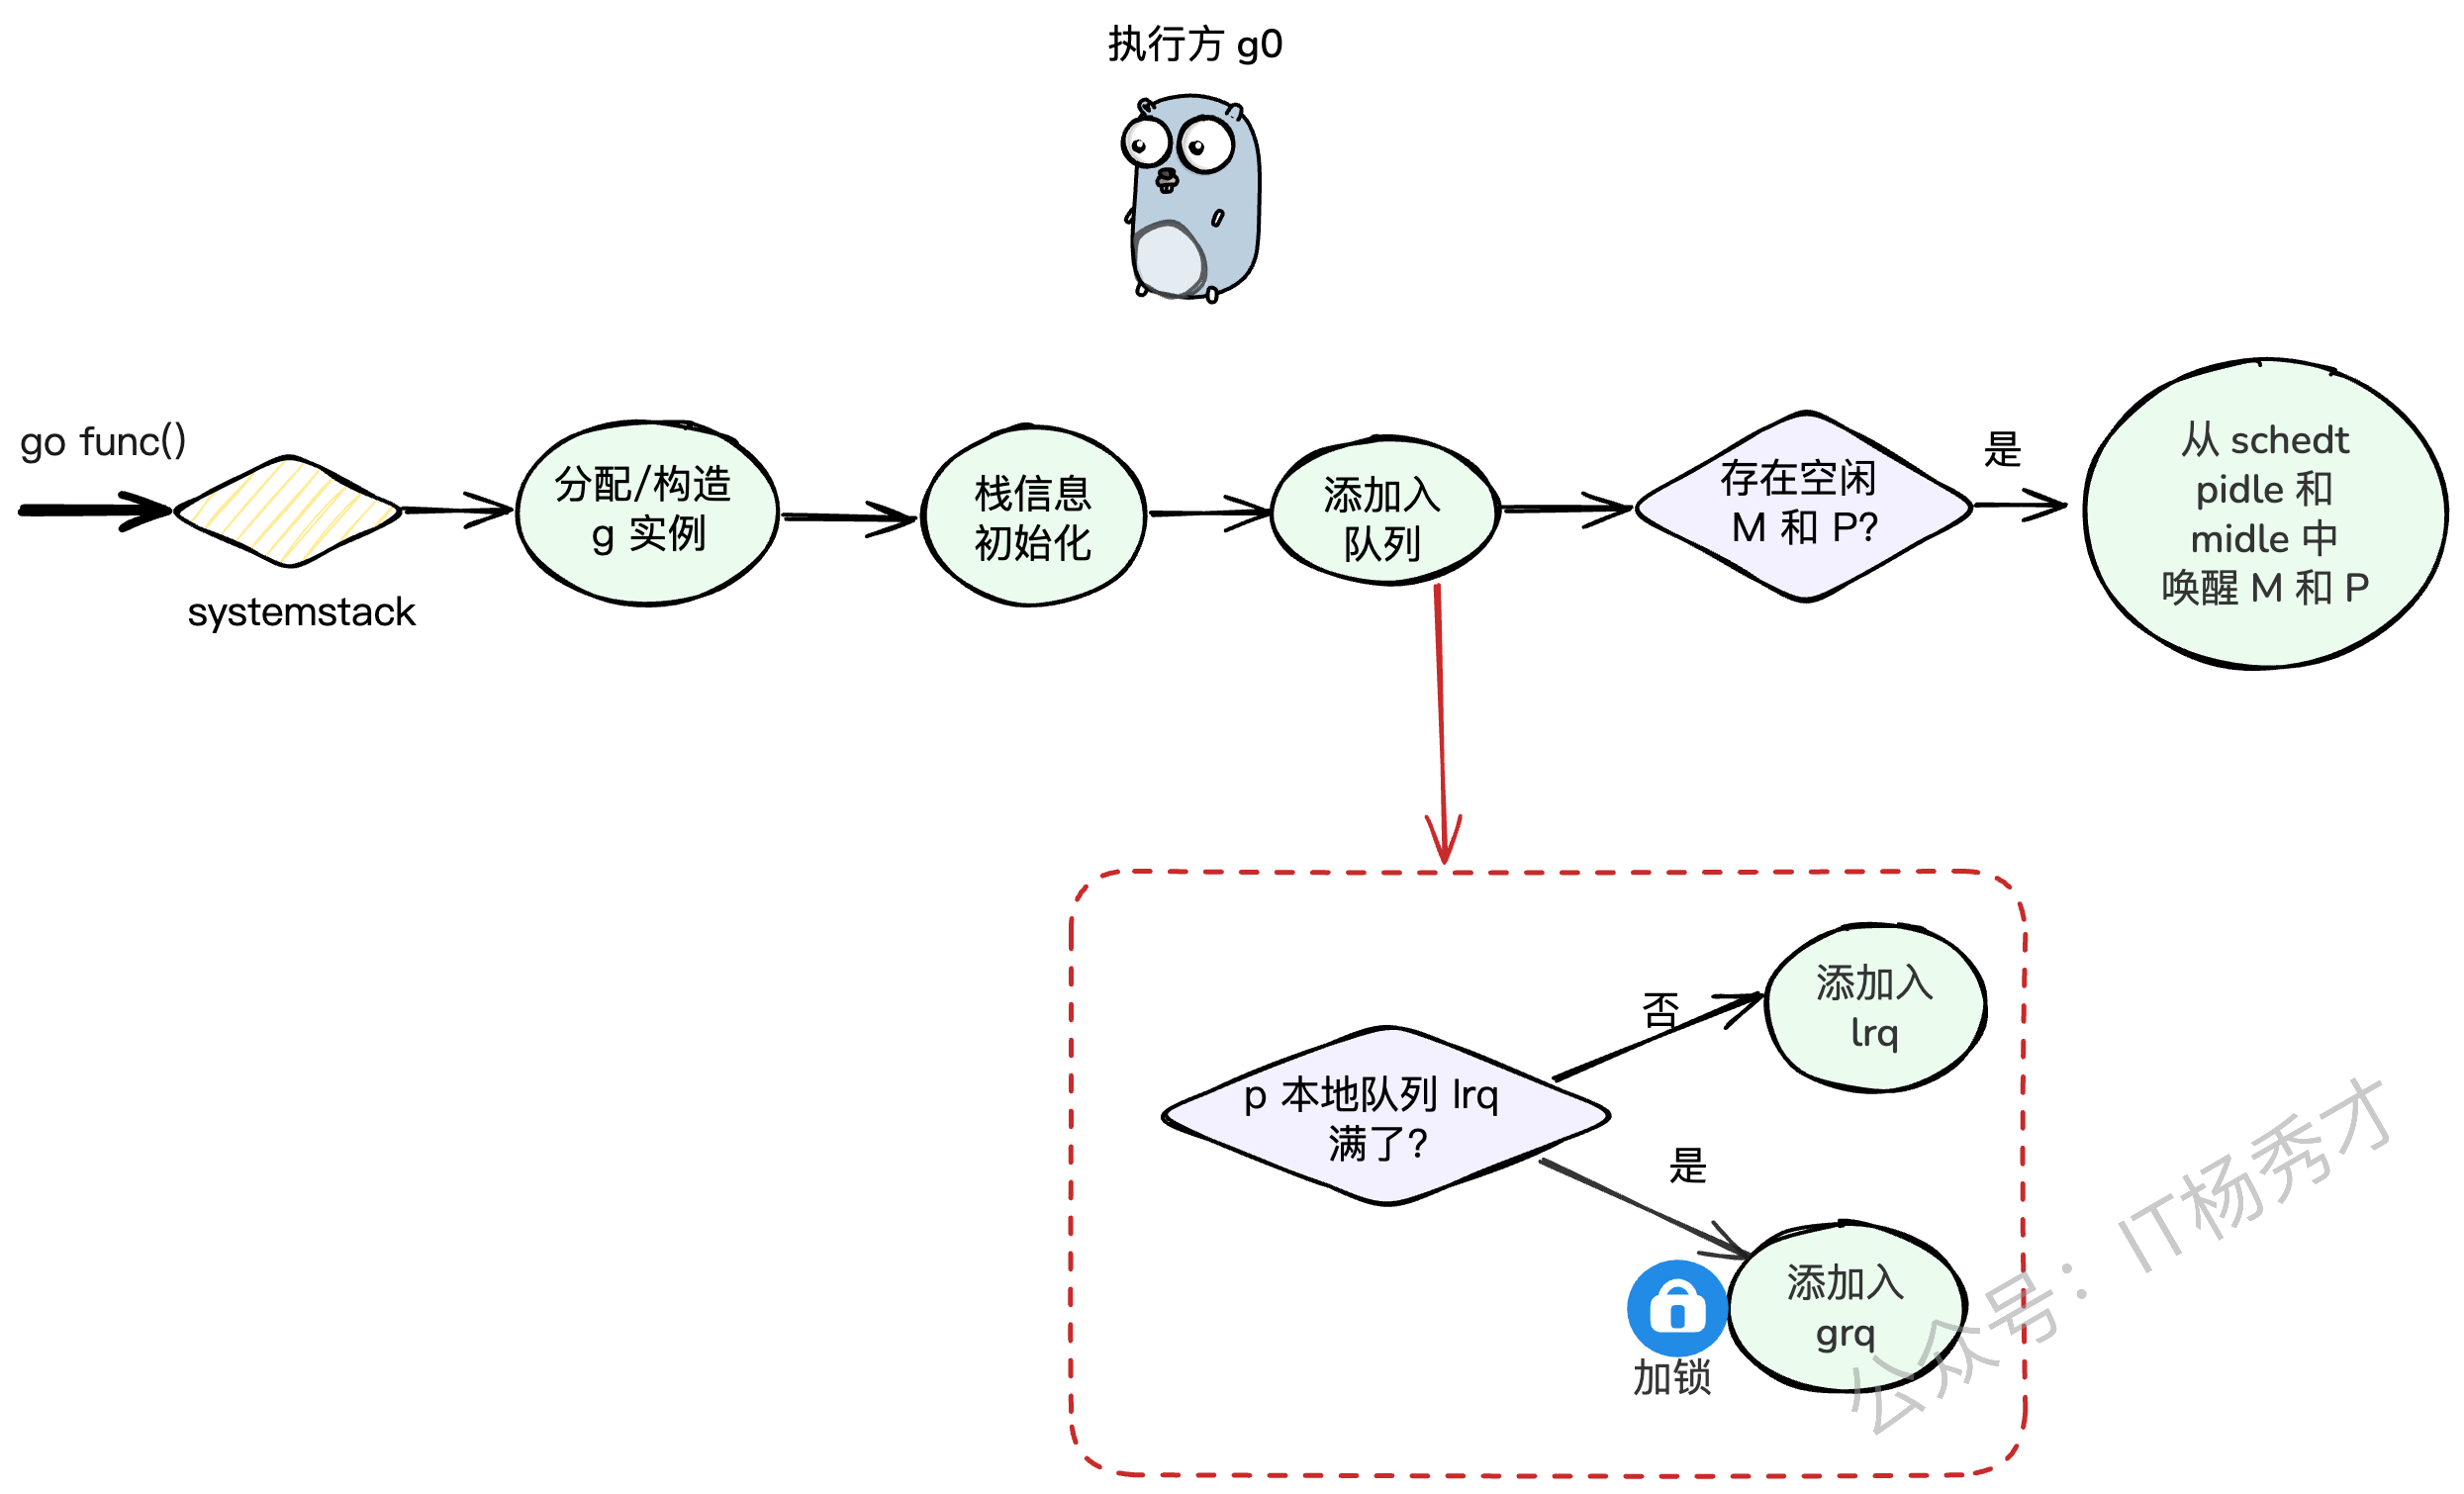
-除了`main`这个特例,我们自己启动的goroutine都会经历一个标准的创建流程。比如这段代码:
-
-```go
-func handle() {
- // 异步启动一个goroutine
- go func() {
- // do something ...
- }()
-}
-```
-
-编译器会把 `go func()` 转换成对 `runtime.newproc` 函数的调用。这个函数的核心逻辑如下(我们跟着代码走一遍):
-
-1. **切换到**`g0`**栈**:`newproc`会先通过`systemstack`把自己从当前的用户G栈切换到M的`g0`调度栈上。因为创建G是调度层面的工作,得由专业的`g0`来干。
-
-2. **创建G实例**:在`g0`栈上,调用`newproc1`来创建一个新的`g`结构体实例,并做好初始化工作,比如设置好要执行的函数入口地址、程序计数器等。
-
-3. **放入就绪队列**:新创建的G需要被放到一个就绪队列里,等待被调度。这里会调用`runqput`函数。
-
-4. `runqput`**的逻辑**:
-
- * 它会优先尝试把新的G放到当前P的`runnext`这个VIP位置。
-
- * 如果`runnext`被占了,它会尝试把G放到当前P的LRQ的队尾。
-
- * 如果LRQ也满了,那没办法,只能加个全局锁,把这个G和LRQ里的一半G都转移到全局队列GRQ里去(这个操作叫`runqputslow`)。
-
-5. **唤醒休眠的P**:如果此时有P因为没事干而处于休眠状态,`wakep`函数会负责唤醒一个P来处理这个新任务。
-
-6. **切回用户G栈**:`systemstack`执行完毕,切回到原来的用户G,继续执行它自己的代码。
-
-```go
-// 创建一个新的g,并将其投递到就绪队列中。fn是用户指定的函数。
-// 当前的执行者还是某个普通的g。
-func newproc(fn *funcval) {
- // 获取当前正在执行的普通g和程序计数器
- gp := getg()
- pc := getcallerpc()
-
- // systemstack会临时切换到g0栈,执行完闭包函数后,再切回原来的普通g
- systemstack(func() {
- // 此时执行方为g0
- // 构造一个新的g实例
- newg := newproc1(fn, gp, pc)
-
- // 获取当前P
- _p_ := getg().m.p.ptr()
-
- // 将newg添加到队列中:
- // 1) 优先添加到P的本地队列LRQ
- // 2) 如果LRQ满了,则添加到全局队列GRQ
- runqput(_p_, newg, true)
-
- // 如果有因为空闲而被阻塞的P和M,需要唤醒它们
- if mainStarted {
- wakep()
- }
- })
- // 切回到原来的普通g继续执行
-}
-```
-
-### 3.3 从 `g0` 到 `g` 的切换
-
-
-
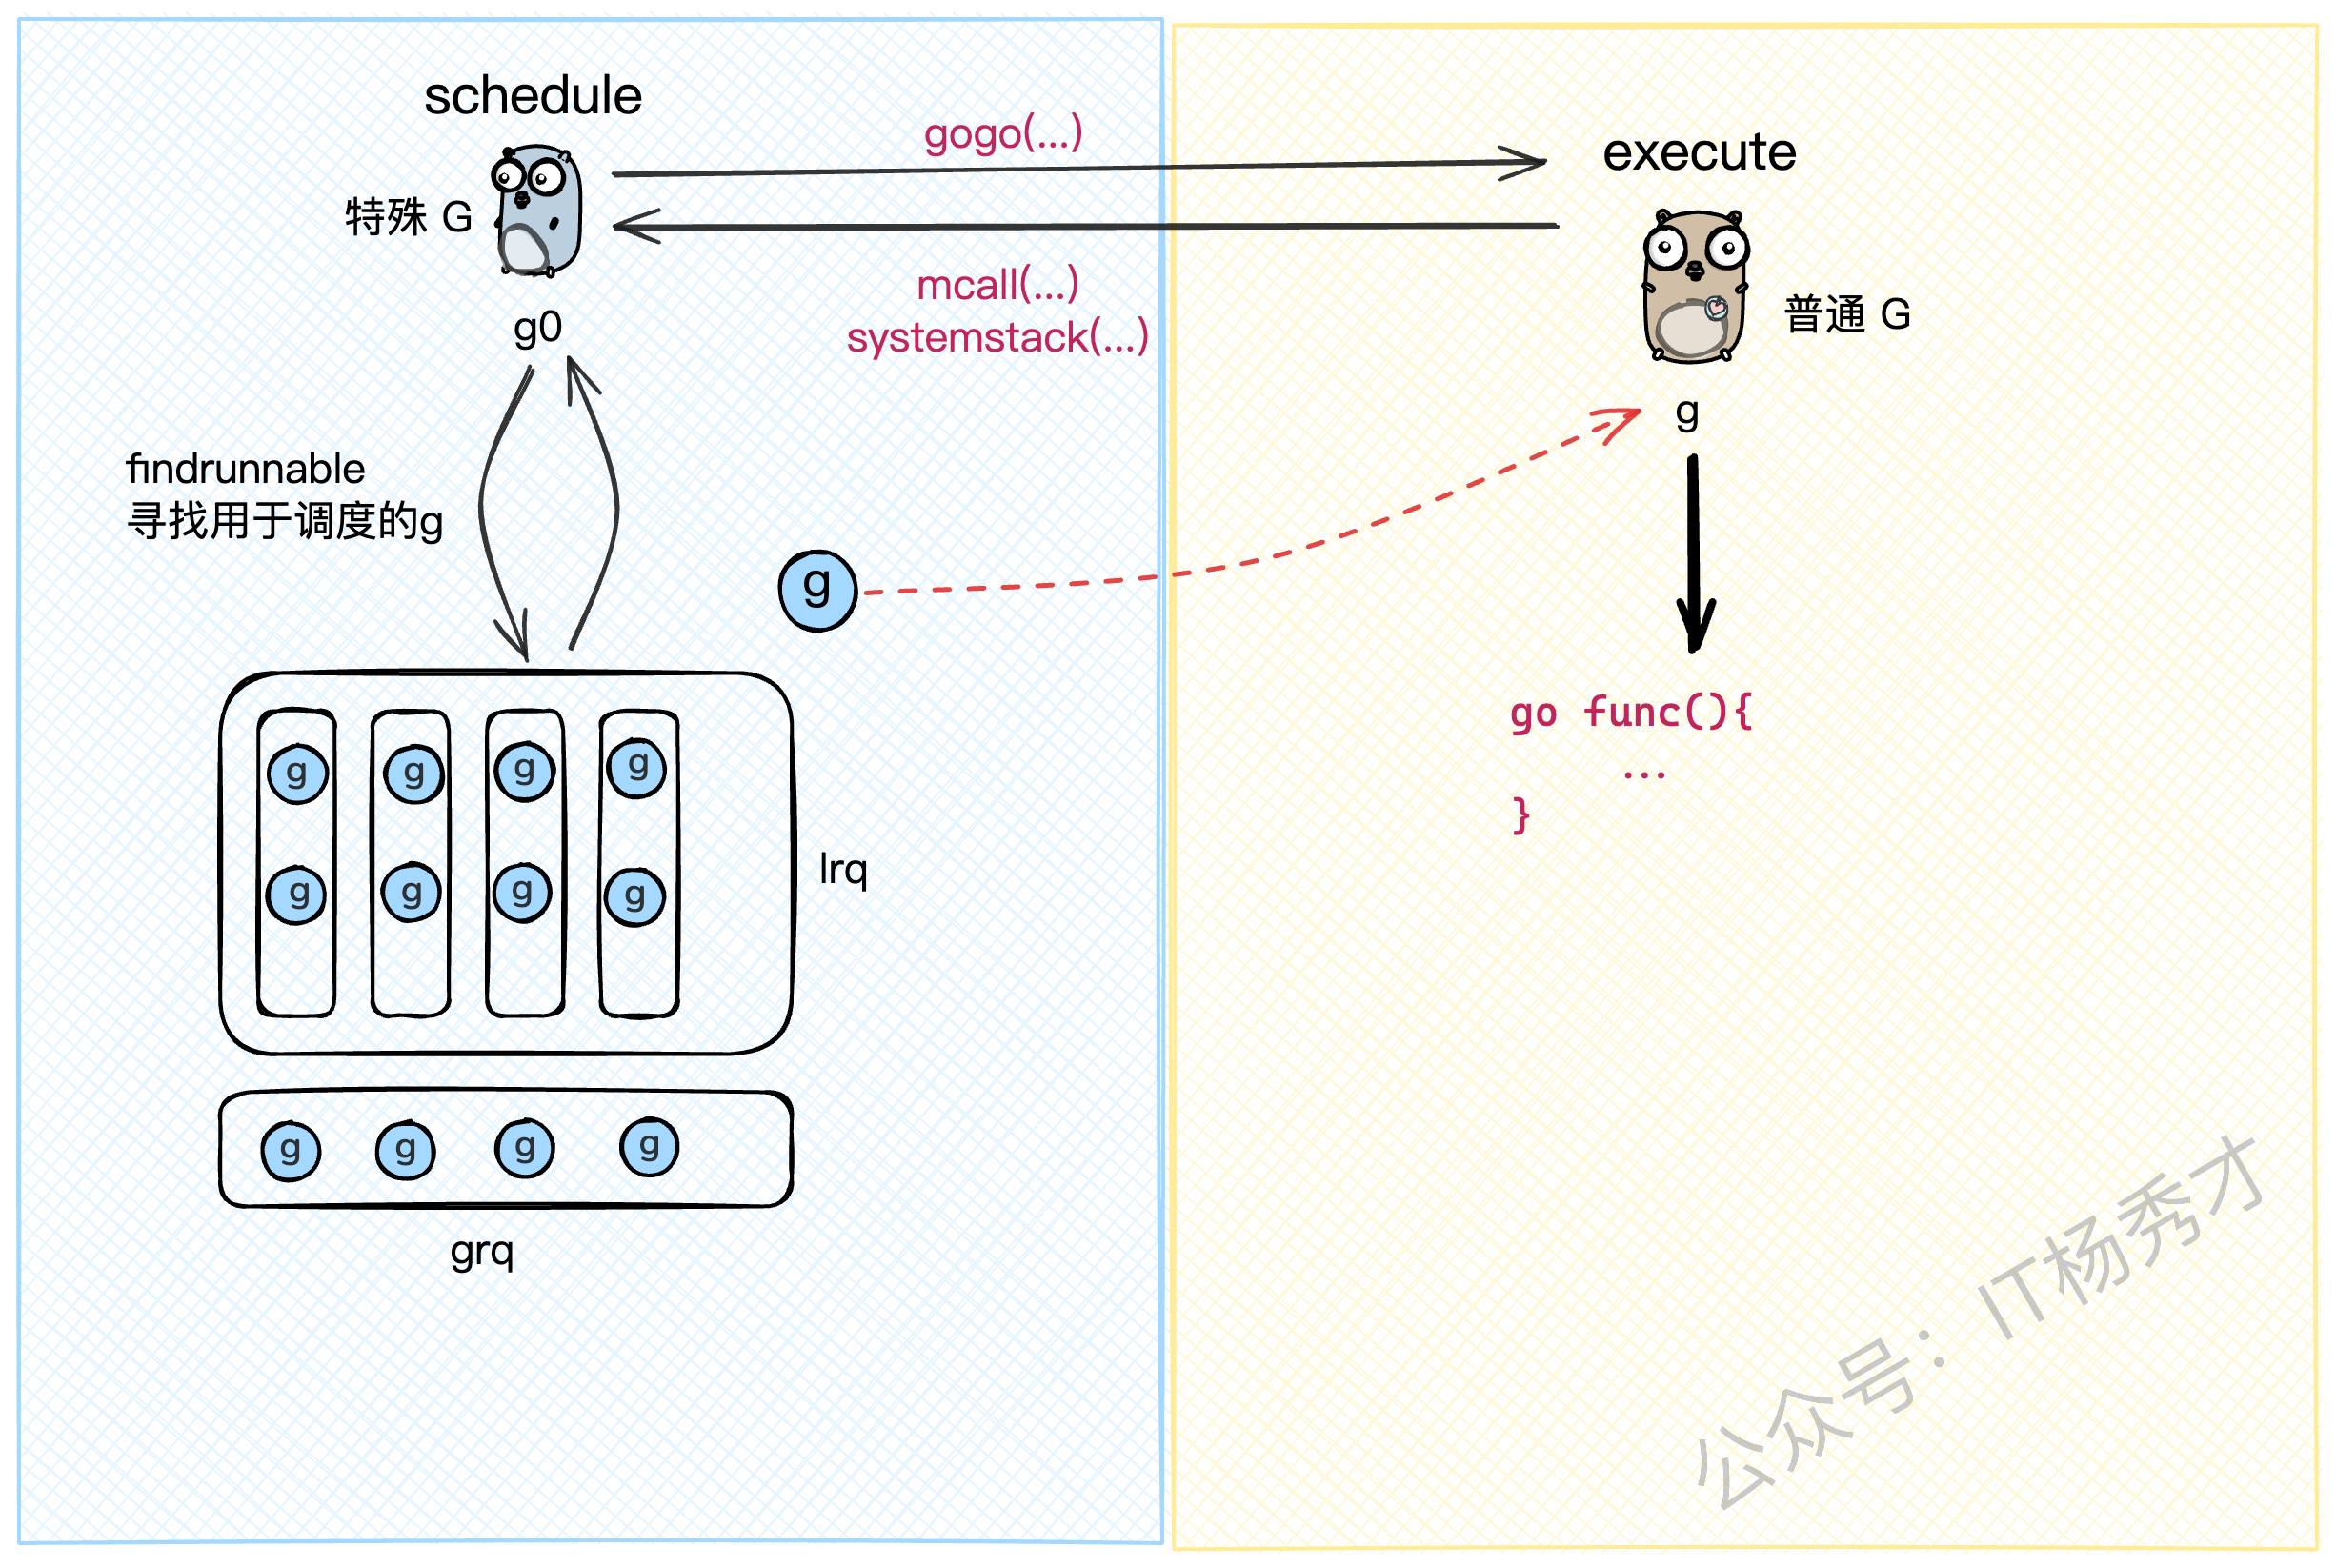
-每个M都有一个自己的`g0`,`g0`的工作就是不断地调用`schedule`函数来寻找可执行的G。所以,一个M的生命周期,就是在执行`g0`(找任务)和执行普通`g`(做任务)之间循环往复。
-
-这个切换过程有两个关键的"桩函数":
-
-* `mcall`, `systemstack`: 实现从 `g` 切换到 `g0`。
-
-* `gogo`: 实现从 `g0` 切换到 `g`。
-
-我们从`g0`的视角来看,它主要做两件事:
-
-1. `schedule()`: 调用`findrunnable()`方法,从各个队列里找到一个可执行的G。
-
-2. `execute()`: 找到G之后,更新上下文信息(比如把`m.curg`指向找到的G),然后调用`gogo`,把M的CPU执行权从`g0`交到这个G手上。
-
-上述方法均实现于 runtime/proc.go 文件中:
-
-```go
-// 执行方为g0
-func schedule() {
- _g_ := getg() // 获取当前g0
-
-top:
- pp := _g_.m.p.ptr() // 获取当前P
-
- // ...
-
- // 核心方法: 获取一个可调度的g
- // - 按照优先级,依次从本地队列LRQ、全局队列GRQ、netpoll、其他P的LRQ中寻找
- // - 如果都找不到,就把P和M都休眠掉
- gp, inheritTime, tryWakeP := findRunnable() // 这个函数会阻塞直到找到任务
-
- // ...
-
- // 执行g,这个方法会把执行权从g0切换到gp
- execute(gp, inheritTime)
-}
-
-// 执行指定的g。当前执行方还是g0,但会通过gogo方法切换到gp
-func execute(gp *g, inheritTime bool) {
- _g_ := getg() // 获取g0
-
- // 建立g0和gp的关系
- _g_.m.curg = gp
- gp.m = _g_.m
-
- // 更新gp的状态:runnable -> running
- casgstatus(gp, _Grunnable, _Grunning)
-
- // 设置gp的栈保护区边界
- gp.stackguard0 = gp.stack.lo + _StackGuard
-
- // 执行gogo方法,M的执行权会切换到gp
- gogo(&gp.sched)
-}
-```
-
-### 3.4 寻找G的漫漫长路:`findrunnable`
-
-`findrunnable`是调度循环中最核心的函数,它寻找G的策略体现了Go调度器的智慧。
-
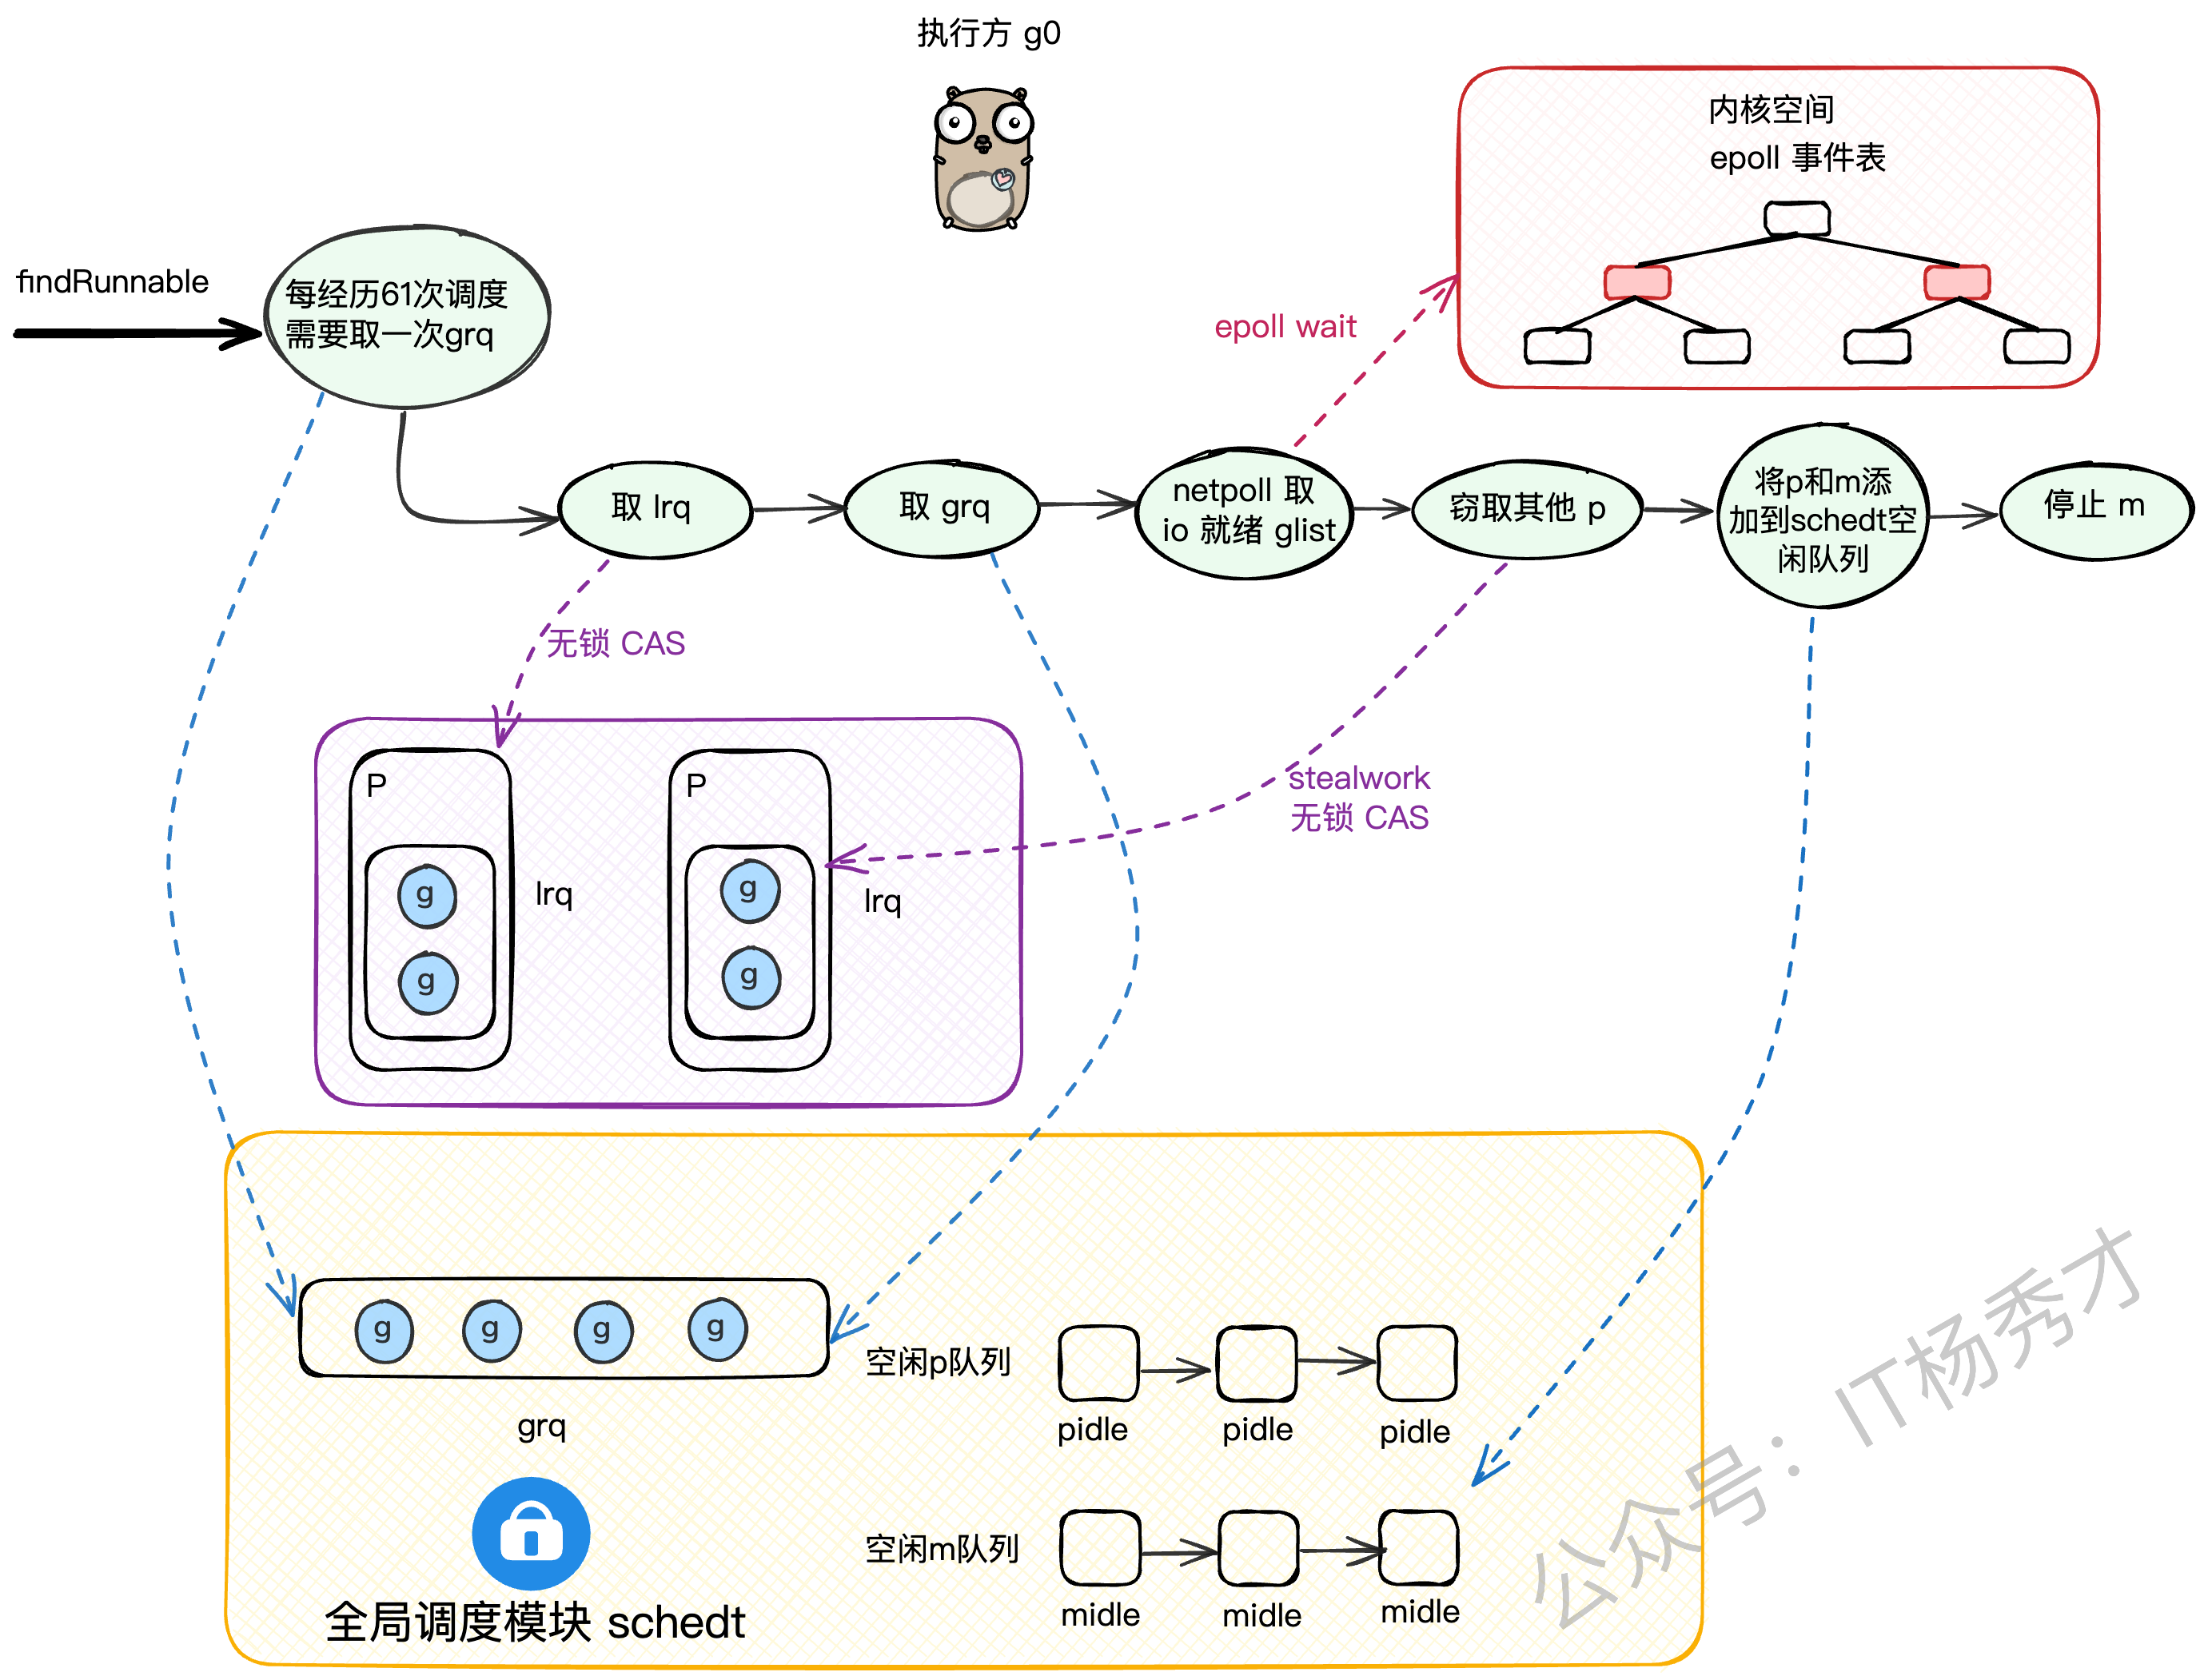
-
-
-我们来梳理一下它的寻找步骤:
-
-1. **检查全局队列(GRQ)**:还记得吗?每61次调度循环,必须先从全局队列`globrunqget`拿一个G,防止GRQ饥饿。(需要加锁)
-
-2. **检查本地队列(LRQ)**:从当前P的LRQ里`runqget`一个G。(无锁CAS)
-
-3. **再次检查全局队列(GRQ)**:如果本地没有,再去全局队列里`globrunqget`找。(需要加锁)
-
-4. **检查网络轮询器(netpoll)**:如果还没有,就去`netpoll`里看看有没有因为网络IO就绪的G。(非阻塞模式)
-
-5. **从别的P偷(steal work)**:如果还找不到,就只能启动`stealwork`机制,随机找一个别的P,从它的LRQ里偷一半的G过来。
-
-6. **再次double check全局队列**:偷完之后,再最后看一眼全局队列。
-
-7. **进入休眠**:如果以上所有努力都失败了,说明系统现在真的很闲,`findrunnable`会:
-
- * 把当前的P设置为`_Pidle`状态,并把它放到全局的`pidle`队列里。
-
- * 在把当前M也休眠之前,会做最后一次挣扎:以**阻塞模式**调用`netpoll`,看看能不能等到一个IO事件。
-
- * 如果连阻塞等待IO都没用,那就彻底死心了,把当前M也放到全局的`midle`队列里,然后调用`stopm`让M休眠,交出线程控制权。
-
-这个过程设计得非常精妙,既保证了任务获取的高效性(优先无锁操作),又实现了负载均衡(work-stealing),还能在系统空闲时自动缩容,节省资源。
-
-### 3.5 findRunnable函数详解
-
-Go调度器的核心在于`findRunnable`函数,这个函数负责为当前的处理器P找到一个可执行的goroutine。整个过程遵循着严格的优先级顺序,确保系统的公平性和效率。
-
-```go
-// 寻找可执行的goroutine,返回时必定已经找到目标g
-func findRunnable()(gp *g, inheritTime, tryWakeP bool){
- // 获取当前P下的g0(调度协程)
- _g_ := getg()
- // ...
-top:
- // 获取当前的处理器P
- _p_ := _g_.m.p.ptr()
- // ...
-
- // 防饥饿机制:每61次调度检查一次全局队列
- if _p_.schedtick%61==0 && sched.runqsize > 0{
- lock(&sched.lock)
- gp = globrunqget(_p_, 1)
- unlock(&sched.lock)
- if gp != nil{
- return gp, false, false
- }
- }
- // ...
-
- // 第一优先级:从本地运行队列获取goroutine
- if gp, inheritTime := runqget(_p_); gp != nil{
- return gp, inheritTime, false
- }
-
- // 第二优先级:从全局队列获取goroutine
- if sched.runqsize != 0{
- lock(&sched.lock)
- gp := globrunqget(_p_, 0)
- unlock(&sched.lock)
- if gp != nil{
- return gp, false, false
- }
- }
-
- // 第三优先级:处理网络I/O就绪的goroutine
- if netpollinited() && atomic.Load(&netpollWaiters) > 0 &&
- atomic.Load64(&sched.lastpoll) != 0{
- if list := netpoll(0); !list.empty(){ // 非阻塞调用
- gp := list.pop()
- injectglist(&list)
- casgstatus(gp, _Gwaiting, _Grunnable)
- // ...
- return gp, false, false
- }
- }
- // ...
-
- // 第四优先级:从其他P的本地队列偷取goroutine
- gp, inheritTime, tnow, w, newWork := stealWork(now)
- if gp != nil{
- return gp, inheritTime, false
- }
-
- // 若有GC标记任务,参与协作而非直接回收P
- // ...
-
- // 最后检查:再次确认全局队列
- lock(&sched.lock)
- // ...
- if sched.runqsize != 0{
- gp := globrunqget(_p_, 0)
- unlock(&sched.lock)
- return gp, false, false
- }
- // ...
-
- // 无事可做时:解绑P和M,将P放入空闲队列
- releasep()
- now = pidleput(_p_, now)
- unlock(&sched.lock)
- // ...
-
- // 网络轮询保障机制:确保有M专门处理I/O事件
- if netpollinited() && (atomic.Load(&netpollWaiters) > 0 || pollUntil != 0) &&
- atomic.Xchg64(&sched.lastpoll, 0) != 0{
- atomic.Store64(&sched.pollUntil, uint64(pollUntil))
- // ...
-
- // 阻塞模式执行网络轮询
- delay := int64(-1)
- // ...
- list := netpoll(delay) // 阻塞直到有新任务
-
- // 恢复轮询标识
- atomic.Store64(&sched.lastpoll, uint64(now))
- // ...
-
- lock(&sched.lock)
- // 尝试获取空闲的P
- _p_, _ = pidleget(now)
- unlock(&sched.lock)
-
- // 如果没有可用的P,将就绪的goroutine放入全局队列
- if _p_ == nil{
- injectglist(&list)
- } else {
- // 重新绑定P和M
- acquirep(_p_)
- // 取第一个goroutine用于调度,其余放入全局队列
- if !list.empty(){
- gp := list.pop()
- injectglist(&list)
- casgstatus(gp, _Gwaiting, _Grunnable)
- // ...
- return gp, false, false
- }
- // ...
- goto top
- }
- }
- // ...
-
- // 最终手段:阻塞当前M,加入空闲队列
- stopm()
- goto top
-}
-```
-
-#### 3.5.1 本地队列获取策略
-
-从本地队列获取goroutine是最高效的方式,因为不需要加锁。`runqget`函数采用了巧妙的双重策略:
-
-```go
-// 无锁方式从P的本地队列获取goroutine
-func runqget(_p_ *p)(gp *g, inheritTime bool){
- // 优先获取runnext位置的goroutine(高优先级位置)
- next := _p_.runnext
- if next != 0 && _p_.runnext.cas(next, 0){
- return next.ptr(), true
- }
-
- // 从队列头部获取普通goroutine
- for{
- // 原子操作获取头部索引
- h := atomic.LoadAcq(&_p_.runqhead) // load-acquire语义,与其他消费者同步
- // 获取尾部索引
- t := _p_.runqtail
-
- // 队列为空的情况
- if t == h {
- return nil, false
- }
-
- // 根据索引取出对应的goroutine
- gp := _p_.runq[h%uint32(len(_p_.runq))].ptr()
-
- // CAS操作更新头部索引
- if atomic.CasRel(&_p_.runqhead, h, h+1){ // cas-release语义,提交消费操作
- return gp, false
- }
- }
-}
-```
-
-这里有个有趣的设计:`runnext`是一个特殊位置,专门存放高优先级的goroutine,比如刚刚创建的新goroutine。这样设计可以提高响应性。
-
-#### 3.5.2 全局队列的公平调度
-
-当本地队列为空时,调度器会转向全局队列。但这里有个重要的防饥饿机制:
-
-```go
-// 从全局队列获取goroutine,调用前必须持有全局锁
-func globrunqget(_p_ *p, max int32)*g {
- // 确保持有锁的断言检查
- assertLockHeld(&sched.lock)
-
- // 队列空检查
- if sched.runqsize == 0{
- return nil
- }
- // ...
-
- // 根据max参数可能会批量转移goroutine到本地队列
- // 这里简化显示核心逻辑
- // ...
-
- // 从全局队列头部弹出一个goroutine
- gp := sched.runq.pop()
- // ...
- return gp
-}
-```
-
-#### 3.5.3 网络I/O事件处理机制
-
-在 gmp 调度流程中,如果 lrq 和 grq 都为空,则会执行 netpoll 流程,尝试以非阻塞模式下的 epoll\_wait 操作获取 io 就绪的 g。该方法位于 runtime/netpoll\_epoll.go:
-
-```go
-func netpoll(delay int64) gList {
- // ...
- // 调用系统的epoll_wait获取就绪事件
- var events [128]epollevent
- n := epollwait(epfd, &events[0], int32(len(events)), waitms)
- // ...
-
- var toRun gList
- for i := int32(0); i < n; i++{
- ev := &events[i]
- // 将就绪事件对应的goroutine加入待运行列表
- netpollready(...)
- }
- return toRun
-}
-```
-
-这个机制让Go程序能够高效处理大量并发连接,而不需要为每个连接分配单独的线程。
-
-#### 3.5.4 从其他的P队列窃取g
-
-当本地队列和全局队列都为空时,并且执行完 netpoll 流程后仍未获得 g,则会尝试从其他 p 的 lrq 中窃取半数 g 补充到当前 p 的 lrq 中。工作窃取算法是负载均衡的关键,它确保了系统中的处理器都能保持忙碌状态。
-
-```go
-func stealWork(now int64) (gp *g, inheritTime bool, rnow, pollUntil int64, newWork bool){
- // 获取当前P
- pp := getg().m.p.ptr()
- // ...
-
- // 最多尝试4轮窃取
- const stealTries = 4
- for i := 0; i < stealTries; i++{
- // ...
-
- // 随机选择窃取目标,避免热点竞争
- for enum := stealOrder.start(fastrand()); !enum.done(); enum.next(){
- // ...
-
- // 获取目标P
- p2 := allp[enum.position()]
-
- // 不能从自己这里偷
- if pp == p2 {
- continue
- }
- // ...
-
- // 只要目标P不是空闲状态就尝试窃取
- if !idlepMask.read(enum.position()){
- // 窃取目标P本地队列中的一半goroutine
- if gp := runqsteal(pp, p2, stealTimersOrRunNextG); gp != nil{
- return gp, false, now, pollUntil, ranTimer
- }
- }
- }
- }
-
- // 窃取失败
- return nil, false, now, pollUntil, ranTimer
-}
-```
-
-#### 3.5.5 回收空闲p和m
-
-再执行完上述逻辑之后,如果还是未能获取到可运行的g,系统需要妥善处理空闲的P和M,此时会将 p 和 m 添加到 schedt 的 pidle 和 midle 队列中并停止 m 的运行,避免产生资源浪费
-
-```go
-// 将P加入空闲队列
-func pidleput(_p_ *p, now int64)int64{
- assertLockHeld(&sched.lock)
- // ...
-
- // 将P插入空闲队列头部
- _p_.link = sched.pidle
- sched.pidle.set(_p_)
- atomic.Xadd(&sched.npidle, 1)
- // ...
-}
-
-// 停止当前M的运行
-func stopm(){
- _g_ := getg()
- // ...
-
- lock(&sched.lock)
- // 将M加入空闲队列
- mput(_g_.m)
- unlock(&sched.lock)
-
- // 让M进入休眠状态
- mPark()
- // ...
-}
-```
-
-## 4. 逆向追踪:G的让渡艺术
-
-有借有还,再借不难。G拿到了M的执行权,也得在适当的时候还回去。这个"还"的过程,我们称之为**让渡(yield)**。让渡是一个主动的行为,由G自己发起,目的是把执行权交还给`g0`,让`g0`可以去调度其他的G。这是一个从 `g` 到 `g0` 的转换。
-
-### 4.1 功成身退:执行结束
-
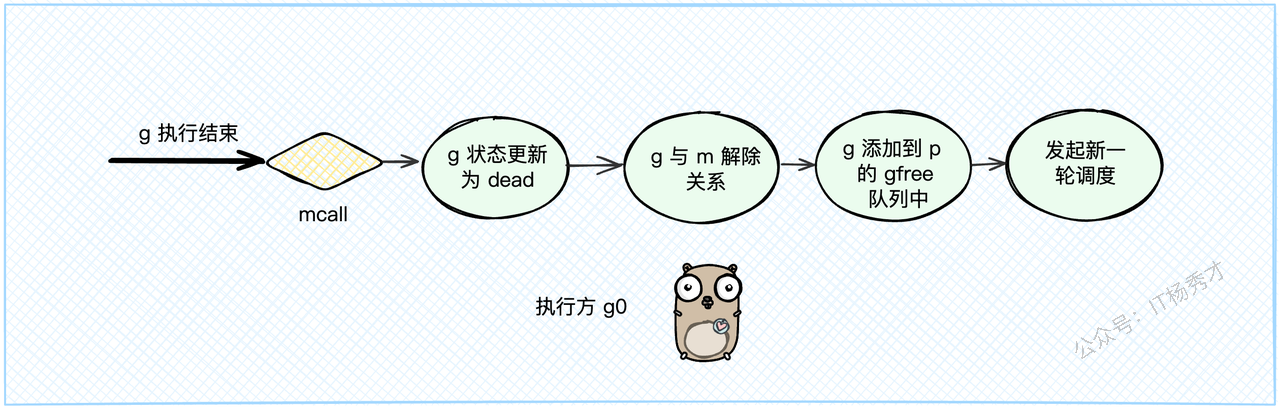
-
-
-当一个G的任务执行完毕,它会调用`goexit1`,这是一个主动的"退休"申请。
-
-1. 在`goexit1`里,它会调用`mcall(goexit0)`,这个`mcall`指令会把执行权从当前的G切换到M的`g0`上,并让`g0`去执行`goexit0`函数。
-
-2. `goexit0`函数(此时由`g0`执行)会负责给这个退休的G办"后事":
-
- * 把G的状态从`_Grunning`更新为`_Gdead`。
-
- * 清理G内部的数据。
-
- * 解除G和M的绑定关系(`dropg`)。
-
- * 把这个G的结构体放到P的`gfree`队列里,方便下次创建新G时复用,避免了内存的反复申请和释放。
-
- * 最后,调用`schedule()`,开始新一轮的调度。
-
-```go
-// goroutine运行结束,此时执行方是普通g
-func goexit1() {
- // 通过mcall,将执行方转为g0,调用goexit0方法
- mcall(goexit0)
-}
-
-// 此时执行方为g0,入参gp为已经运行结束的g
-func goexit0(gp *g) {
- _g_ := getg() // 获取g0
- _p_ := _g_.m.p.ptr()
-
- // 将gp的状态由running更新为dead
- casgstatus(gp, _Grunning, _Gdead)
- // ... 清理工作 ...
-
- // 将g和p解除关系
- dropg()
-
- // 将g添加到p的gfree队列中以供复用
- gfput(_p_, gp)
-
- // 发起新一轮调度流程
- schedule()
-}
-```
-
-### 4.2 高风亮节:主动让渡
-
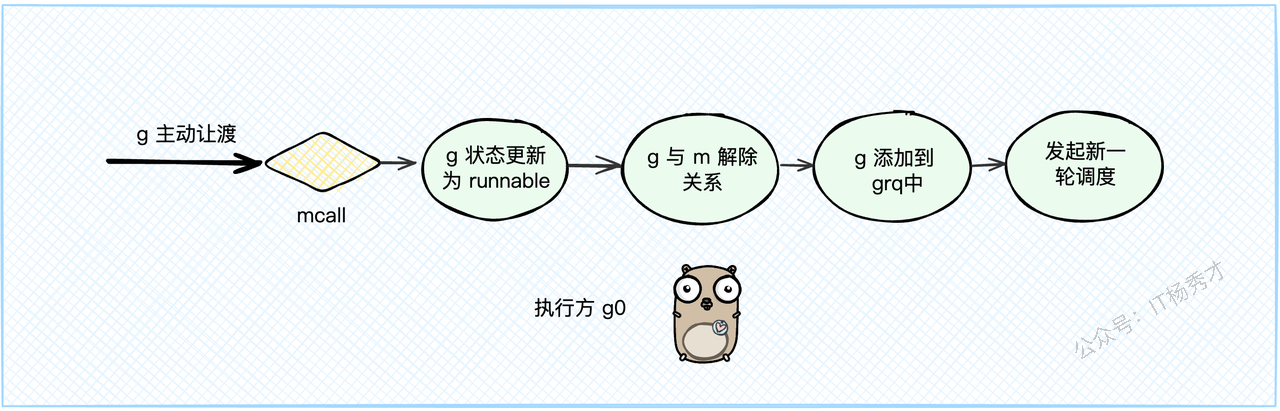
-
-
-我们可以通过在代码里调用 `runtime.Gosched()` 来手动让一个G让出CPU。这个函数会做和`goexit1`类似的事情:
-
-1. 调用`mcall(gosched_m)`,把执行权从当前G切换到`g0`。
-
-2. `g0`执行`gosched_m`函数,它的逻辑是:
-
- * 把G的状态从`_Grunning`改回`_Grunnable`。
-
- * 解除G和M的绑定。
-
- * 把这个G直接扔到**全局队列GRQ**中,等待下一次被调度。
-
- * 调用`schedule()`,开始新一轮调度。
-
-```go
-// 主动让渡出执行权,此时执行方还是普通g
-func Gosched() {
- // 通过mcall,将执行方转为g0,调用gosched_m方法
- mcall(gosched_m)
-}
-
-// 此时执行方为g0
-func gosched_m(gp *g) {
- // ...
- goschedImpl(gp)
-}
-
-func goschedImpl(gp *g) {
- // 将g状态由running改为runnable就绪态
- casgstatus(gp, _Grunning, _Grunnable)
- // 解除g和m的关系
- dropg()
- // 将g添加到全局队列grq
- lock(&sched.lock)
- globrunqput(gp)
- unlock(&sched.lock)
- // 发起新一轮调度
- schedule()
-}
-```
-
-### 4.3 情非得已:阻塞让渡
-
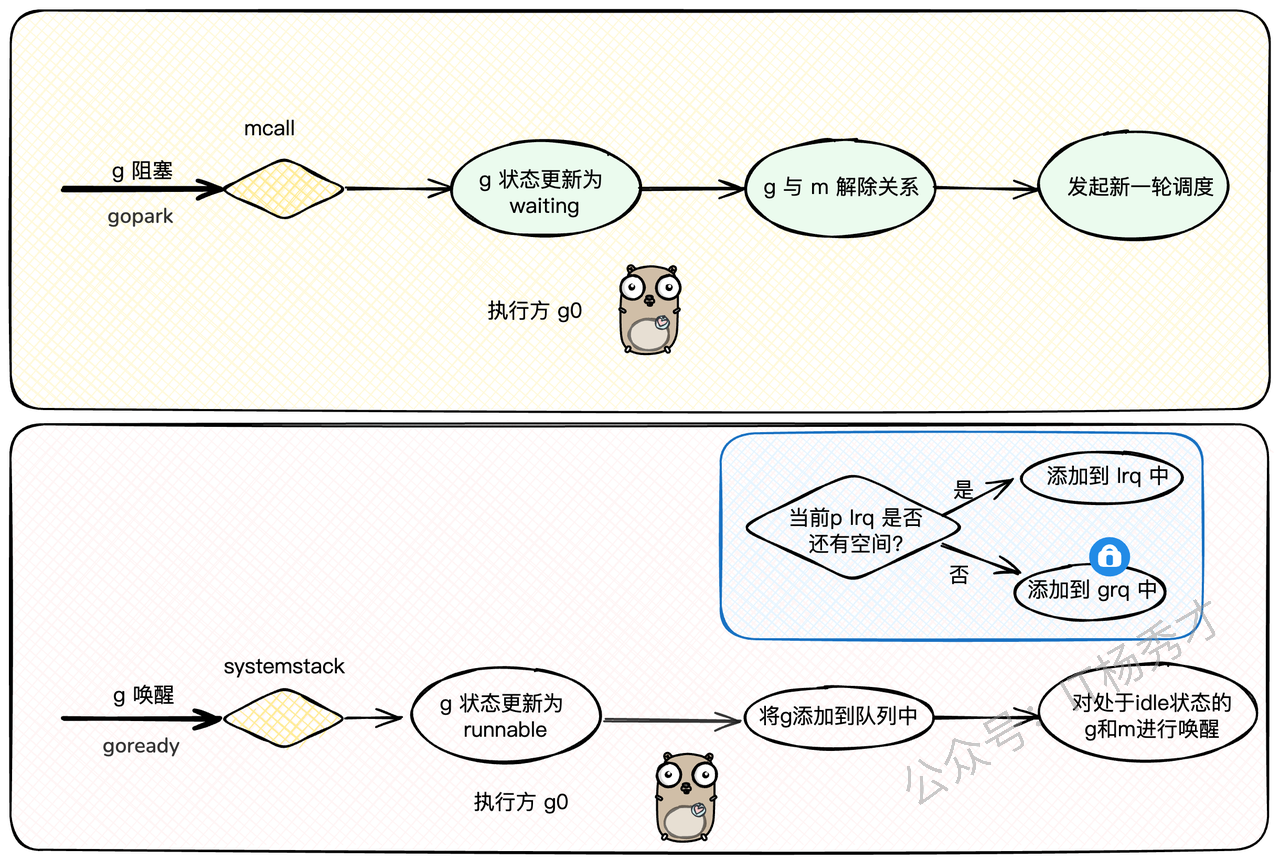
-
-
-这是最常见的一种让渡方式。当G执行到需要等待某个外部条件的地方(比如读一个空的channel,或者等待一个锁),它就会被阻塞。
-
-这个过程的核心是`gopark`函数:
-
-1. 当G需要阻塞时,上层函数(比如channel的读写逻辑)会调用`gopark`。
-
-2. `gopark`同样会调用`mcall(park_m)`,把执行权交给`g0`。
-
-3. `g0`执行`park_m`,它会:
-
- * 把G的状态从`_Grunning`改为`_Gwaiting`。
-
- * 解除G和M的绑定。
-
- * **注意**:`_Gwaiting`状态的G不会被放到任何就绪队列里!它会被上层调用者(比如channel)自己保管。
-
- * `g0`调用`schedule()`,寻找下一个G来执行。
-
-当外部条件满足时(比如channel里有了数据),另一个G会调用`goready`函数来唤醒这个处于`_Gwaiting`状态的G。
-
-`goready`会:
-
-1. 把目标G的状态从`_Gwaiting`改回`_Grunnable`。
-
-2. 调用`runqput`,把这个G重新放回到就绪队列(LRQ或GRQ)中。
-
-3. 调用`wakep`,尝试唤醒一个空闲的P来处理这个刚被唤醒的G。
-
-这一`park`一`ready`,完美地实现了G级别的阻塞和唤醒,整个过程高效且对用户透明。
-
-以下是具体的代码分析:
-
-```go
-// 此时执行方为普通 g
-func gopark(unlockf func(*g, unsafe.Pointer)bool,lockunsafe.Pointer, reason waitReason, traceEv byte, traceskip int){
- // 获取 m 正在执行的 g,也就是要阻塞让渡的 g
- gp := mp.curg
- // ...
- // 通过 mcall,将执行方由普通 g -> g0
- mcall(park_m)
-}
-
-// 此时执行方为 g0. 入参 gp 为需要执行 park 的普通 g
-func park_m(gp *g){
- // 获取 g0
- _g_ := getg()
-
- // 将 gp 状态由 running 变更为 waiting
- casgstatus(gp,_Grunning,_Gwaiting)
- // 解绑 g 与 m 的关系
- dropg()
-
- // g0 发起新一轮调度流程
- schedule()
-}
-```
-
-与 gopark 相对的,是用于唤醒 g 的 goready 方法,其中会通过 systemstack 压栈切换至 g0 执行 ready 方法——将目标 g 状态由 waiting 改为 runnable,然后添加到就绪队列中.
-
-```go
-// 此时执行方为普通 g. 入参 gp 为需要唤醒的另一个普通 g
-func goready(gp *g, traceskip int) {
- // 调用 systemstack 后,会切换至 g0 亚展调用传入的 ready 方法. 调用结束后则会直接切换回到当前普通 g 继续执行.
- systemstack(func() {
- ready(gp, traceskip, true)
- })
-
- // 恢复成普通 g 继续执行 ...
-}
-```
-
-```go
-// 此时执行方为 g0. 入参 gp 为拟唤醒的普通 g
-func ready(gp *g, traceskip int, next bool){
- // ...
-
- // 获取当前 g0
- _g_ := getg()
- // ...
- // 将目标 g 状态由 waiting 更新为 runnable
- casgstatus(gp,_Gwaiting,_Grunnable)
- /*
- 1) 优先将目标 g 添加到当前 p 的本地队列 lrq
- 2)若 lrq 满了,则将 g 追加到全局队列 grq
- */
- runqput(_g_.m.p.ptr(), gp,next)
- // 如果有 m 或 p 处于 idle 状态,将其唤醒
- wakep()
- // ...
-}
-```
-
-## 5. 第三方视角:抢占式调度
-
-前面说的"让渡"都是G的主动行为。但如果一个G是个"老赖",执行一个超长的计算任务,一直不主动让出CPU怎么办?难道要让整个系统都等它一个吗?
-
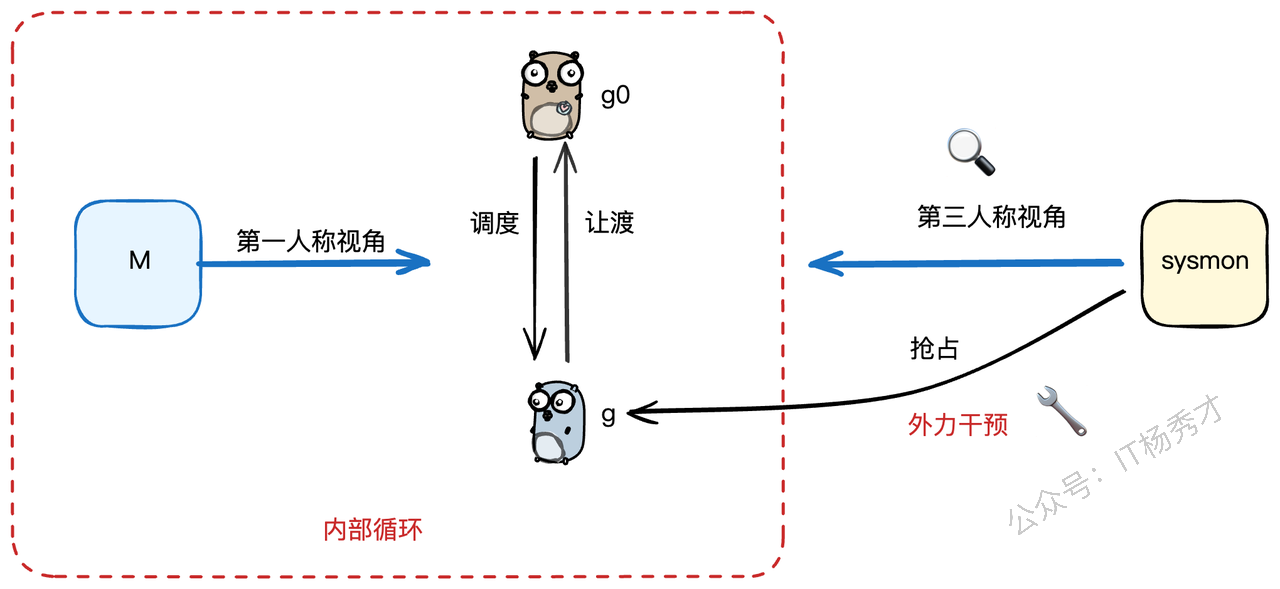
-当然不行!Go调度器还有一个"霸道总裁"的角色来强制干预,就是**抢占(Preemption)**。一个由外部力量发起的、为了维护整个系统公平和效率的"强制让位"过程。
-
-
-
-### 5.1 幕后英雄:无处不在的sysmon
-
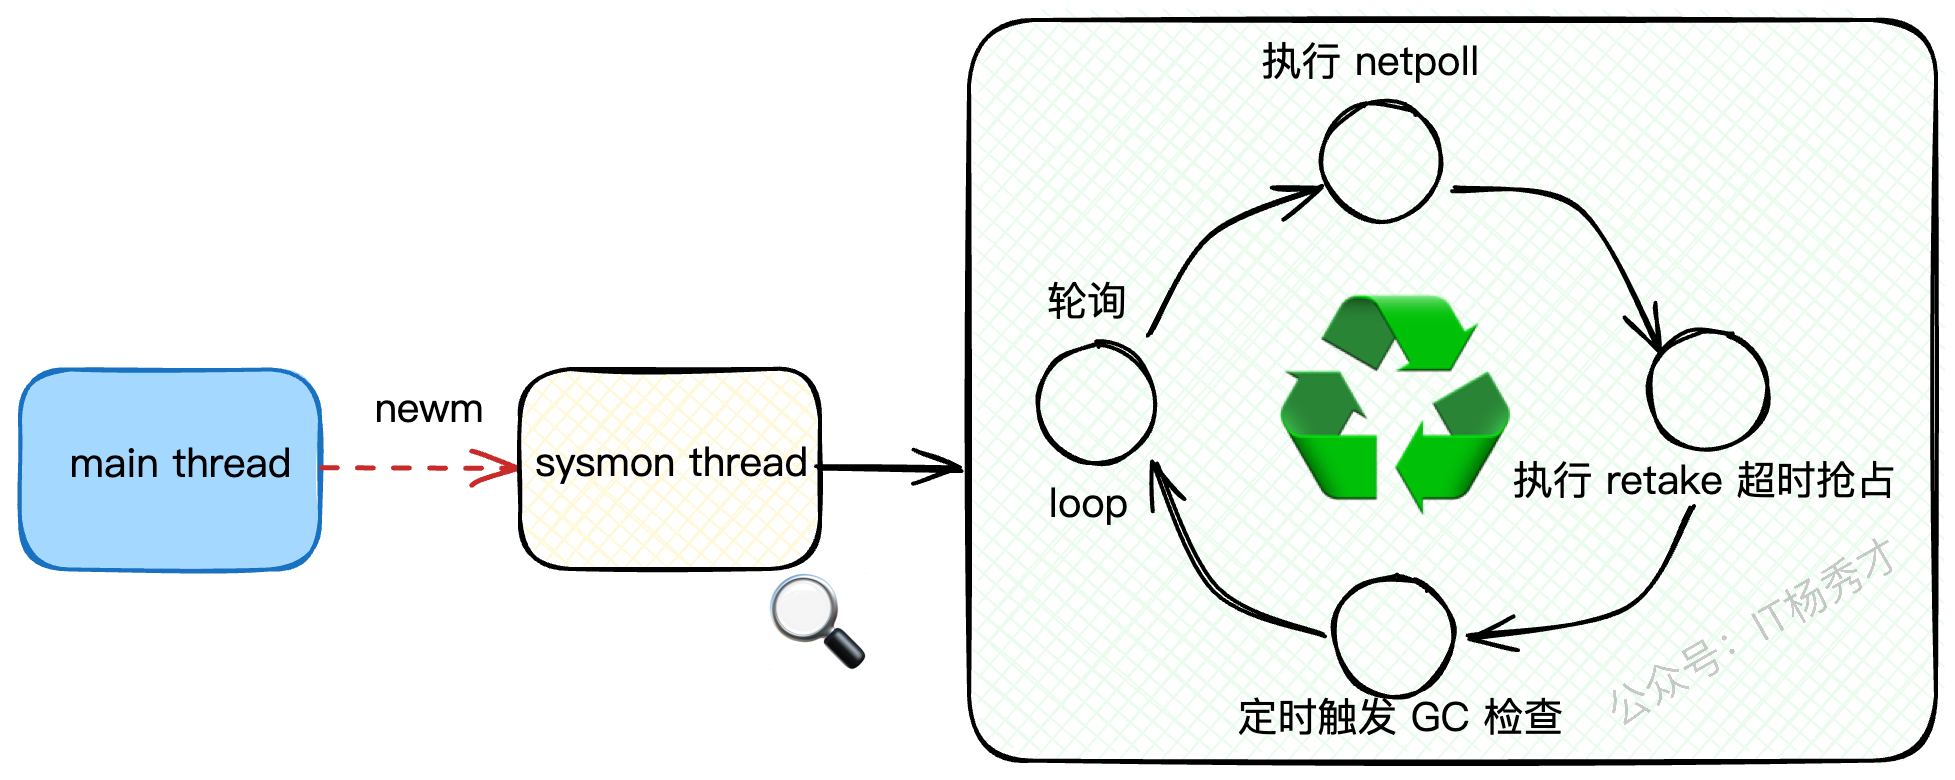
-在我们的Go程序启动时,除了我们熟知的主线程外,runtime还会悄悄启动一个非常关键的后台线程——`sysmon`(System Monitor,系统监控)。
-
-你可以把它想象成一个永不休息的"巡逻兵",它独立于普通的G-P-M调度模型,持续地在后台循环执行。这个线程在整个程序生命周期里是全局唯一的,就像一个大管家,不知疲倦地监视着整个Go程序的运行状态。
-
-
-
-`sysmon` 的工作是一个永不停歇的循环,它主要关心三件大事儿:
-
-* **网络轮询(netpoll)**:检查有没有已经完成IO操作的网络连接,唤醒那些等待IO的Goroutine。
-
-* **抢占(retake)**:找出那些运行时间太长的Goroutine,毫不留情地把它"踹"下CPU。
-
-* **GC触发检查**:看看是不是时候该进行垃圾回收(GC)了。
-
-这个 `sysmon` 线程是在哪里创建的呢?答案就在 `main` 函数启动的深处。Go运行时会通过 `newm` 创建一个新的系统线程(M)专门来跑 `sysmon` 这个函数。
-
-它的核心工作逻辑大致如下:
-
-```go
-// The main goroutine.
-// main goroutine的入口
-func main(){
- systemstack(func() {
- // 创建一个新的M(系统线程)来执行sysmon函数
- // 这个M不关联任何P,是一个专门用于系统监控的线程
- newm(sysmon, nil, -1)
- })
- // ...
-}
-
-// sysmon是系统监控函数,它在一个独立的M上无限循环运行
-func sysmon() {
- //..
- for {
- // 根据程序的繁忙程度,动态调整休眠时间
- // 如果程序比较空闲,会休眠长一点,最长10毫秒
- usleep(delay)
- // ...
-
- // 记录上次网络轮询的时间
- lastpoll := int64(atomic.Load64(&sched.lastpoll))
- // 如果网络轮询器已初始化,并且距离上次轮询超过10ms
- if netpollinited() && lastpoll != 0 && lastpoll+10*1000*1000 < now {
- //...
- // 执行非阻塞的网络轮询,返回一个就绪的goroutine列表
- list := netpoll(0)
- // ...
- }
-
- // 执行抢占工作,这是我们的重点
- retake(now)
- //...
-
- // 检查是否需要触发GC
- if t := (gcTrigger{kind: gcTriggerTime, now: now}); t.test() && atomic.Load(&forcegc.idle) != 0 {
- // ...
- }
- // ...
- }
-}
-```
-
-可以看到,`sysmon` 的核心就是一个 `for` 死循环,每次循环都会执行一遍它的"三板斧"。而我们的抢占逻辑,就藏在 `retake` 这个函数里。`retake` 会根据Goroutine的不同状态,采取不同的抢占策略,主要分为两种:**系统调用抢占**和**运行超时抢占**。
-
-### 5.2 系统调用抢占
-
-我们知道,系统调用(syscall)是连接用户态程序和操作系统内核的桥梁。但当一个M(系统线程)陷入系统调用时,它就会被操作系统挂起,暂时无法执行任何用户态代码。这对Go的调度器来说是个大问题,因为如果M上还绑定着一个P(处理器),那这个P也就跟着被闲置了,它所管理的本地Goroutine队列就得不到执行,造成了资源浪费。
-
-Go的策略非常聪明:**人走可以,但办公桌得留下!**
-
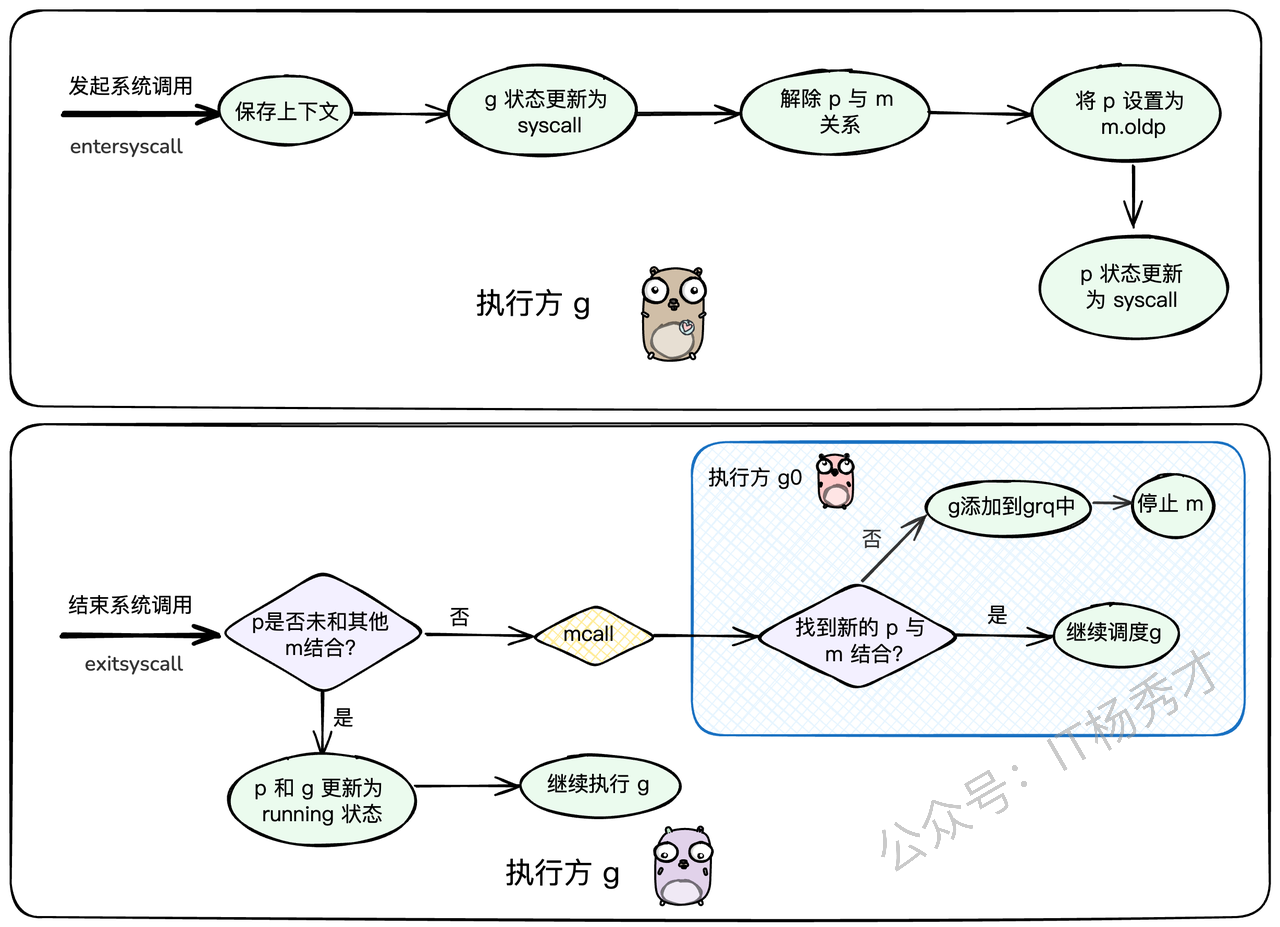
-当一个Goroutine即将发起系统调用时,调度器会做几件事:
-
-1. **解除P与M的绑定**:把当前线程M和处理器P分离开。
-
-2. **状态更新**:把Goroutine和P的状态都更新为 `_Gsyscall` 和 `_Psyscall`。
-
-3. **保留弱联系**:虽然P和M分开了,但M会记住这个P(存放在`m.oldp`),方便回来的时候能"再续前缘"。
-
-4. **寻找新机会**:脱离了M的P,可以去和其他空闲的M结合,继续执行其他Goroutine,一点都不耽误事儿。
-
-
-
-这个过程主要发生在 `reentersyscall` 函数中:
-
-```go
-// reentersyscall 在goroutine进入系统调用时被调用
-func reentersyscall(pc, sp uintptr) {
- _g_ := getg() // 获取当前的goroutine
-
- // ...
- // 保存当前的程序计数器(PC)和栈指针(SP)等上下文信息
- save(pc, sp)
- // ...
-
- // 1. 将goroutine的状态从 _Grunning 更新为 _Gsyscall
- casgstatus(_g_, _Grunning, _Gsyscall)
-
- // ...
- // 2. 解除 P 和 M 的绑定关系
- pp := _g_.m.p.ptr()
- pp.m = 0 // P的m指针置空
- _g_.m.p = 0 // M的p指针置空
-
- // 3. 将P设置为M的oldp,建立一个弱引用关系
- _g_.m.oldp.set(pp)
-
- // 4. 将P的状态更新为 _Psyscall
- atomic.Store(&pp.status, _Psyscall)
-
- // ...
-}
-```
-
-等系统调用结束,Goroutine从内核态返回时,会执行 `exitsyscall` 函数。这时它会尝试"复位归来":
-
-* **快速路径**:先看看之前那个P(`oldp`)是不是还单身(没有和其他M结合)。如果是,太好了,直接拿回来用,光速恢复执行。
-
-* **慢速路径**:如果P已经被别的M"拐走"了,那就没办法了。当前Goroutine会被切换到`g0`栈,执行`exitsyscall0`,尝试为自己所在的M寻找一个新的空闲P。如果找到了,就继续执行;如果找不到,说明现在很忙,M就会被挂起,这个Goroutine则被放到全局队列中,等待下一次被调度
-
-```go
-// exitsyscall 在goroutine退出系统调用时执行
-func exitsyscall() {
- _g_ := getg() // 获取当前goroutine
-
- // ...
- // 尝试快速路径:如果oldp没有被其他M绑定,就直接复用
- oldp := _g_.m.oldp.ptr()
- _g_.m.oldp = 0
- if exitsyscallfast(oldp) {
- // ...
- // 快速恢复成功,将g的状态改回_Grunning
- casgstatus(_g_, _Gsyscall, _Grunning)
- // ...
- return // 直接返回,继续执行g
- }
-
- // 快速路径失败,切换到g0栈,执行慢速路径逻辑
- mcall(exitsyscall0)
- // ...
-}
-
-// exitsyscall0 在g0栈上为当前M寻找一个新的P
-func exitsyscall0(gp *g) {
- // 将goroutine的状态从 _Gsyscall 改为 _Grunnable 就绪态
- casgstatus(gp, _Gsyscall, _Grunnable)
- // 解除g和当前M的绑定
- dropg()
- lock(&sched.lock)
-
- // 尝试从空闲列表获取一个P
- var _p_ *p
- _p_, _ = pidleget(0)
- // ...
-
- // 如果没有找到空闲的P
- if _p_ == nil {
- // 将g放入全局运行队列
- globrunqput(gp)
- // ...
- }
- // ...
- unlock(&sched.lock)
-
- // 如果找到了P
- if _p_ != nil {
- // 绑定P,然后立即执行这个goroutine
- acquirep(_p_)
- execute(gp, false) // 不会返回
- }
-
- // 如果没找到P,M只能进入休眠
- stopm()
- // 当M被唤醒后,重新开始调度循环
- schedule() // 不会返回
-}
-```
-
-
-
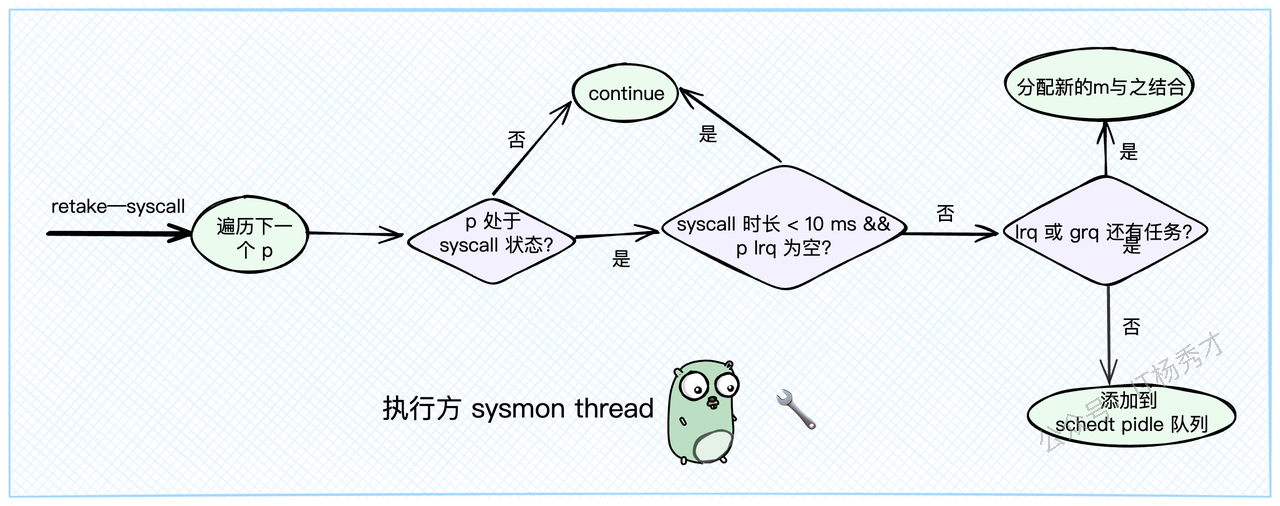
-你可能会问,这和 `sysmon` 有什么关系?关系大了!`sysmon` 会在它的 `retake` 检查中,遍历所有的P。如果发现某个P长时间处于 `_Psyscall` 状态(默认超过10ms),或者这个P虽然在syscall,但它的本地队列里还有其他Goroutine在排队,`sysmon` 就会认为不能再等了,必须执行抢占。 它会调用 `handoffp`,强制把这个P从syscall的M那里"抢"过来,分配给一个新的或者空闲的M,去执行P本地队列里的其他任务。
-
-```go
-// retake 函数由 sysmon 线程周期性调用
-func retake(now int64) uint32{
- n :=0
- // 加锁
- lock(&allpLock)
- // 遍历所有 p
- for i :=0; i 0&& pd.syscallwhen+10*1000*1000> now {
- continue
- }
- unlock(&allpLock)
- // 将 p 的状态由 syscall 更新为 idle
- if atomic.Cas(&_p_.status, s,_Pidle){
- // ...
- // 让 p 拥有和其他 m 结合的机会
- handoffp(_p_)
- }
- // ...
- lock(&allpLock)
- }
- }
- unlock(&allpLock)
- return uint32(n)
-}
-```
-
-```javascript
-func handoffp(_p_ *p) {
- // 如果 p lrq 中还有 g 或者全局队列 grq 中还有 g,则立即分配一个新 m 与该 p 结合
- if!runqempty(_p_)|| sched.runqsize !=0{
- // 分配一个 m 与 p 结合
- startm(_p_,false)
- return
- }
- // ...
- // 若系统空闲没有 g 需要调度,则将 p 添加到 schedt 中的空闲 p 队列 pidle 中
- pidleput(_p_,0)
- // ...
-}
-```
-
-### 5.3 运行超时抢占
-
-除了系统调用,另一种需要抢占的场景就是Goroutine运行时间过长。比如一个纯计算的循环,没有任何IO或channel操作,它就会像个"钉子户"一样霸占着CPU。
-
-
-
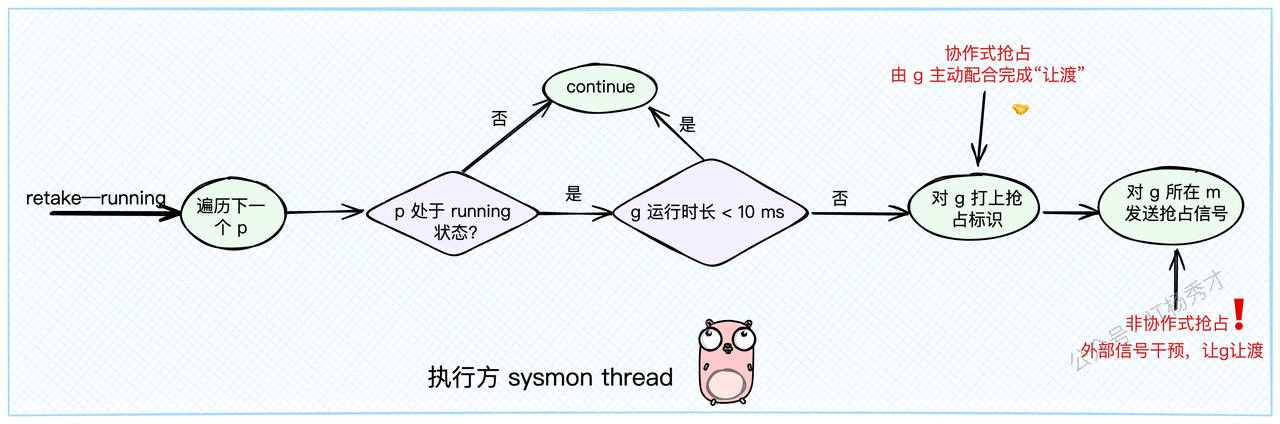
-`sysmon` 在 `retake` 函数中同样会检查每个处于 `_Prunning` 状态的P。它会看当前P上的Goroutine从何时开始执行(`schedwhen`),如果执行时间超过了一个阈值(`forcePreemptNS`,通常是10ms),`sysmon` 就会认为需要抢占了。
-
-```go
-// retake 函数的一部分
-func retake(now int64) uint32 {
- // ...
- for i := 0; i < len(allp); i++ {
- _p_ := allp[i]
- // ...
- // 如果P正在运行
- if s == _Prunning {
- // ...
- // 检查当前goroutine的执行时间是否超过了10ms
- if _p_.schedwhen+forcePreemptNS <= now {
- // 发起抢占
- preemptone(_p_)
- }
- }
- }
- // ...
-}
-```
-
-这里的抢占又分为两种方式:一种是"好言相劝",一种是"强行执法"。
-
-#### 5.3.1 协作式抢占
-
-这是Go早期版本就有的抢占方式,比较"温柔"。`sysmon` 在决定抢占后,会调用 `preemptone` 函数。这个函数首先会给目标Goroutine打上一个"抢占标记"。具体来说,就是把 `gp.preempt` 设置为 `true`,同时把 `gp.stackguard0` 设置为一个特殊值 `stackPreempt`。
-
-```go
-// preemptone 抢占指定P上正在运行的g
-func preemptone(_p_ *p) bool {
- // 获取P上绑定的M
- mp := _p_.m.ptr()
- // 获取M上正在运行的g,也就是我们的抢占目标
- gp := mp.curg
-
- // ...
- // 1. 设置协作式抢占标志
- gp.preempt = true
-
- // 2. 修改栈保护标志,这是协作式抢占的关键
- // 当g进行函数调用(特别是涉及栈检查)时,会检查这个值
- gp.stackguard0 = stackPreempt
-
- // ...
-}
-```
-
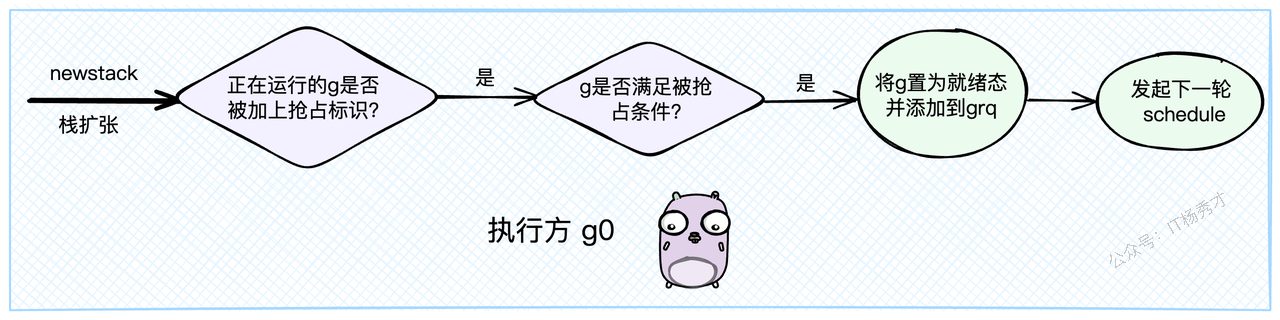
-这个 `stackguard0` 标志位非常关键。Goroutine在执行函数调用时,尤其是可能导致栈扩容的场景下,会检查这个标志位。当它发现 `stackguard0` 变成了 `stackPreempt`,就知道:"哦,调度器想让我让位了"。于是,它就会很"自觉"地停止当前工作,调用 `gopreempt_m`,将自己重新放回全局队列,让出CPU。这个过程就叫做**协作式抢占**。
-
-
-
-这个检查点通常在 `newstack` 函数中,也就是栈扩容的逻辑里:
-
-```go
-// newstack 在g0栈上为goroutine扩展栈空间时执行
-func newstack() {
- // 获取当前需要扩容栈的goroutine
- gp := thisg.m.curg
-
- // 读取g的栈保护标志
- stackguard0 := atomic.Loaduintptr(&gp.stackguard0)
-
- // 如果标志被设置为stackPreempt,说明被标记为需要抢占
- if stackguard0 == stackPreempt {
- // 检查当前g是否满足被抢占的条件(比如没有持有锁等)
- if canPreemptM(thisg.m) {
- // 条件满足,响应抢占,执行让渡操作
- gopreempt_m(gp) // 这个函数不会返回
- }
- }
- // ...
-}
-
-// gopreempt_m 会走到 goschedImpl,后续流程和主动让渡(gosched)一样
-func gopreempt_m(gp *g) {
- // ...
- goschedImpl(gp)
-}
-
-func goschedImpl(gp *g) {
- // g状态从_Grunning变为_Grunnable
- casgstatus(gp, _Grunning, _Grunnable)
- // 解绑M
- dropg()
- // 加锁后放入全局队列
- lock(&sched.lock)
- globrunqput(gp)
- unlock(&sched.lock)
- // 触发新一轮调度
- schedule()
-}
-```
-
-但协作式抢占有个明显的缺点:如果一个Goroutine是个铁憨憨,一直在执行纯计算的死循环,没有任何函数调用,那它就永远没有机会去检查 `stackguard0`,也就无法响应抢占意图。这可怎么办?
-
-#### 5.3.2 非协作式抢占
-
-为了解决协作式抢占的短板,Go 1.14 版本引入了基于信号的抢占机制,也就是**非协作式抢占**。这种方式就非常"硬核"了。
-
-在 `preemptone` 函数中,除了设置协作标记,还会做一件事:向目标Goroutine所在的M(线程)发送一个信号 `sigPreempt`。
-
-```go
-// preemptone 函数的另一部分
-func preemptone(_p_ *p) bool {
- // ... (前面设置协作标记的代码)
-
- // 3. 基于信号实现非协作式抢占
- if preemptMSupported && debug.asyncpreemptoff == 0 {
- _p_.preempt = true
- // 向目标M发送抢占信号
- preemptM(mp)
- }
- return true
-}
-
-func preemptM(mp *m) {
- // ...
- // 向指定的线程(由mp.procid标识)发送sigPreempt信号
- signalM(mp, sigPreempt)
- // ...
-}
-
-func signalM(mp *m, sig int) {
- // 底层通过pthread_kill实现向线程发送信号
- pthread_kill(pthread(mp.procid), uint32(sig))
-}
-```
-
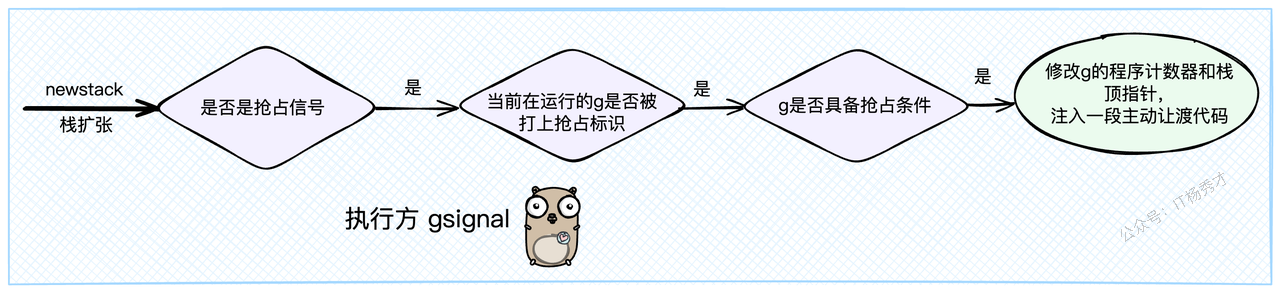
-Go程序启动时,会注册一个信号处理器 `sighandler` 来处理各种信号,其中就包括了我们的 `sigPreempt`
-
-
-
-当M接收到 `sigPreempt` 信号后,操作系统会中断M的当前执行,转而去执行`sighandler`。 信号处理函数会发现这是一个抢占信号,然后检查当前的Goroutine是否满足被抢占的条件(例如,没有在执行一些敏感的运行时代码)。
-
-如果条件满足,最关键的一步来了:`sighandler`会像一个黑客一样,直接修改G的寄存器信息,主要是程序计数器(PC)和栈顶指针(SP)。它会强行在G的执行流中"注入"一段代码,这段代码就是 `asyncPreempt` 函数。
-
-```go
-// sighandler 是go的信号处理总入口
-// 它在gsignal这个特殊的goroutine上执行
-func sighandler(sig uint32, info *siginfo, ctxt unsafe.Pointer, gp *g) {
- // ...
- // 如果收到了抢占信号
- if sig == sigPreempt {
- // 执行抢占处理
- doSigPreempt(gp, ctxt)
- }
- // ...
-}
-
-// doSigPreempt 执行具体的信号抢占逻辑
-func doSigPreempt(gp *g, ctxt *sigctxt) {
- // 判断g是否满足抢占条件
- if wantAsyncPreempt(gp) {
- if ok, newpc := isAsyncSafePoint(gp, ctxt.sigpc(), ctxt.sigsp(), ctxt.siglr()); ok {
- // 通过修改g的寄存器,强行让它下一条指令去执行asyncPreempt
- ctxt.pushCall(abi.FuncPCABI0(asyncPreempt), newpc)
- }
- }
- // ...
-}
-
-// pushCall 修改栈指针和程序计数器,实现"指令注入"
-func (c *sigctxt) pushCall(targetPC, resumePC uintptr) {
- // 获取当前栈顶指针 sp (rsp寄存器)
- sp := uintptr(c.rsp())
- // 栈向下移动一个指针大小,为返回地址腾出空间
- sp -= goarch.PtrSize
- // 将原始的下一条指令地址(resumePC)存入新的栈顶
- *(*uintptr)(unsafe.Pointer(sp)) = resumePC
- // 更新栈顶指针
- c.set_rsp(uint64(sp))
- // 将程序计数器(rip寄存器)设置为我们要注入的函数的地址 (targetPC)
- c.set_rip(uint64(targetPC))
-}
-```
-
-这样一来,当信号处理结束,G恢复执行时,它下一条要执行的指令不再是原来被打断的地方,而是被篡改为了 `asyncPreempt` 函数。这个函数会立即调用 `mcall` 切换到 `g0` 栈,执行 `gopreempt_m`,最终完成让渡操作,和协作式抢占殊途同归。
-
-```go
-// asyncPreempt2 是被强行注入的代码逻辑
-// 此时的执行方是被抢占的g自己
-func asyncPreempt2() {
- gp := getg()
- // ...
- // 切换到g0栈,调用gopreempt_m完成让渡
- mcall(gopreempt_m)
- // ...
-}
-```
-
-至此,哪怕是最顽固的"钉子户"Goroutine,也会被这种强制手段给请下CPU,保证了调度器的公平性。
-
-**抢占**是Go调度器为了公平和效率,由`sysmon`线程发起的强制性调度行为。
-
-1. **系统调用抢占**:通过解绑P和M,让P可以继续服务其他Goroutine,避免因单个M阻塞导致整个P被浪费。
-
-2. **运行超时抢占**:针对长时间运行的Goroutine,Go提供了两手准备:
-
- * **协作式抢占**:温柔地打个标记,让Goroutine在函数调用时"自觉"让出CPU。
-
- * **非协作式抢占**:对于不自觉的Goroutine,直接发送信号,通过修改PC和SP寄存器的方式,强行中断其执行,注入让渡逻辑。
-
-正是有了这套精密的、软硬兼施的抢占机制,Go的并发调度才能如此健壮和高效,让我们能够放心地创建和使用海量的Goroutine。
-
-## 6. 小结
-
-本文从宏观的架构,到微观的源码实现,再到正向、逆向、第三方三种视角,全方位地把GMP给解剖了一遍。
-
-希望通过这篇文章,你能对Go的并发调度有一个更深刻、更系统的理解。GMP模型无疑是Go语言设计的精髓所在,它优雅、高效地解决了并发调度中的种种难题,是我们每个Gopher都应该掌握的核心知识。
-
----
-
-### GMP 全景回顾
-
-```mermaid
-flowchart TD
- subgraph Create["创建 goroutine"]
- NewProc["runtime.newproc
systemstack → newproc1
runqput → LRQ/GRQ"]
- end
-
- subgraph Schedule["调度循环"]
- ScheduleFn["schedule() → findRunnable()"]
- FindR["findRunnable: LRQ→GRQ→netpoll→steal"]
- Execute["execute() → gogo(g)"]
- end
-
- subgraph Yield["让出执行权"]
- End["goexit1 → mcall(goexit0)
status=Gdead, gfput"]
- Gosched["Gosched → mcall(gosched_m)
status=Grunnable, globrunqput"]
- Park["gopark → mcall(park_m)
status=Gwaiting, 由上层管理"]
- end
-
- subgraph Preempt["抢占 (sysmon)"]
- Sysmon["sysmon 线程"]
- Retake["retake: 系统调用 + 超时检测"]
- Collab["协作式: stackPreempt 标记"]
- Signal["非协作式: sigPreempt 信号注入"]
- end
-
- subgraph Recover["恢复执行"]
- Ready["goready → ready()
status=Grunnable, runqput"]
- end
-
- Create --> Schedule
- Schedule --> Yield
- Yield --> Recover
- Recover --> Schedule
- Sysmon --> Preempt
- Preempt --> Yield
- style Create fill:#e3f2fd
- style Schedule fill:#e8f5e9
- style Yield fill:#fff3e0
- style Preempt fill:#ffebee
- style Recover fill:#e8f5e9
-```
-
-> [!note] 📝 核心要点总结
-> - **G** = 任务(goroutine),有自己的栈和执行状态
-> - **M** = 工人(OS 线程),真正执行 G 的代码
-> - **P** = 主管(逻辑处理器),管理 LRQ 并协调 M 与 G 的关系
-> - 调度优先级:LRQ(无锁)> GRQ(加锁)> netpoll(IO)> steal(工作窃取)
-> - 防饥饿:每 61 次调度强制检查 GRQ
-> - 抢占机制:协作式(栈检查标记)+ 非协作式(信号注入)+ 系统调用退出抢占
-> - sysmon 是永不休息的"巡逻兵",负责 IO 轮询、抢占检查和 GC 触发
-
-## 关联笔记
-
-- [[hzh/GolangStar/Go语言进阶/Goroutine]] — Goroutine 的基础概念
-- [[hzh/GolangStar/Go语言基础/Go语言函数]] — 函数的返回值与 defer
-- [[hzh/GolangStar/Go语言原理/内存管理]] — GMP 与内存管理的协作
-- [[hzh/GolangStar/Go语言原理/垃圾回收]] — sysmon 如何触发 GC
-- [[hzh/GolangStar/Go面试题库/GMP面试题]] — GMP 调度相关高频面试题
-
-
-
+### 阅读顺序
+
+| # | 文档 | 涵盖内容 | 适合阶段 |
+|---|------|----------|----------|
+| 1 | [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview]] | G/M/P 角色、LRQ/GRQ 队列、work-stealing、GMP 生态圈 | 入门建立全局视图 |
+| 2 | [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures]] | G/M/P/schedt 结构体源码逐字段解析 + 状态机 | 深入理解底层布局 |
+| 3 | [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle]] | goroutine 创建流程 → findRunnable 调度 → 三种让渡方式(结束/Gosched/gopark) | 追踪完整生命周期 |
+| 4 | [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption]] | sysmon 线程、系统调用抢占、协作式与非协作式抢占 | 理解强制干预机制 |
+| 5 | [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary]] | 全景流程图 + 核心要点速查表 | 复习回顾 / 面试准备 |
diff --git a/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures.md b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures.md
new file mode 100644
index 0000000..4dc23bd
--- /dev/null
+++ b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures.md
@@ -0,0 +1,123 @@
+---
+tags: [go, golang, go-principle, gmp-scheduler, datastructure]
+create time: 2026-06-07 16:00
+---
+
+# GMP 调度原理 — 数据结构
+
+## 概述
+
+本节深入 `runtime/runtime2.go`,逐字段拆解 G、M、P、schedt 四个核心结构体的源码定义及其设计意图。理解这些结构是后续追踪调度流程的基础。
+
+## 正文
+
+### 2.1 G(Goroutine)
+
+G 是 goroutine 的运行时实体,承载栈空间、执行状态和生命周期信息。
+
+```go
+type g struct {
+ stack stack // 栈空间 [stack.lo, stack.hi)
+ stackguard0 uintptr // 栈保护区边界;也用于传递抢占标记
+
+ _panic *_panic // panic 链表头
+ _defer *_defer // defer 链表头(LIFO)
+ m *m // 当前绑定的 M(未运行时为 nil)
+ atomicstatus uint32 // 原子状态:_Gidle → _Grunnable → _Grunning → ...
+
+ schedlink guintptr // 全局队列 / 空闲链表中的 next 指针
+}
+```
+
+| 关键字段 | 说明 |
+|----------|------|
+| `stack` | Goroutine 的执行栈,初始约 2KB,可动态扩容 |
+| `stackguard0` | 函数调用前比较值。若等于 `stackPreempt` 表示被标记抢占;若接近 `stack.lo` 则触发栈扩容 |
+| `atomicstatus` | 生命周期状态的原子快照,通过 `casgstatus()` 切换 |
+
+**状态流转**:
+
+```mermaid
+stateDiagram-v2
+ [*] --> _Gidle: 未初始化
+ _Gidle --> _Grunnable: newproc()
+ _Grunnable --> _Grunning: schedule() 从队列取出
+ _Grunning --> _Grunnable: Gosched() / preempt()
+ _Grunning --> _Gdead: 执行完毕
+ _Grunning --> _Gwaiting: gopark() 阻塞
+ _Gwaiting --> _Grunnable: goready() 唤醒
+ _Gwaiting --> _Gsyscall: (间接)
+ _Gsyscall --> _Grunning: exitsyscall()
+ _Gdead --> [*]: 回收
+ style _Grunning fill:#e8f5e9
+ style _Gwaiting fill:#fff3e0
+```
+
+### 2.2 M(Machine)
+
+M 是 OS 线程的运行时封装,真正执行代码。
+
+```go
+type m struct {
+ g0 *g // 调度协程,每个 M 独有
+ procid uint64 // M 的唯一 ID
+ gsignal *g // 信号处理协程
+ curg *g // 当前正在运行的用户 G
+ p puintptr // 当前绑定的 P
+ schedlink muintptr // 空闲 M 链表 next 指针
+}
+```
+
+M 在两个角色间切换:
+- 执行 `g0` 时:**调度者**——调用 `schedule()` 寻找下一个待执行的 G
+- 执行 `curg` 时:**执行者**——运行用户代码
+
+### 2.3 P(Processor)
+
+P 是逻辑处理器,作为调度器的核心组件管理本地队列。
+
+```go
+type p struct {
+ id int32 // P 的编号
+ status uint32 // _Pidle / _Prunning / _Psyscall
+ link puintptr // 空闲 P 链表
+ schedtick uint32 // 每次 schedule() 自增
+ syscalltick uint32 // 每次系统调用自增
+ m muintptr // 回指绑定的 M(idle 时为 0)
+
+ runqhead uint32 // LRQ 头部索引
+ runqtail uint32 // LRQ 尾部索引
+ runq [256]guintptr // 本地 G 队列(环形数组)
+ runnext guintptr // VIP 位置:高优先级下一个 G
+}
+```
+
+| 关键字段 | 作用 |
+|----------|------|
+| `runq[256]` | 定长环形数组作为 LRQ,CAS 无锁存取 |
+| `runnext` | 新创建的 G 优先放入此处,下次调度直接执行,跳过队列开销 |
+| `schedtick` | 配合防饥饿机制:`schedtick % 61 == 0` 时检查 GRQ |
+
+### 2.4 schedt(全局调度器)
+
+`schedt` 管理跨 P 的全局资源,访问需持有 `sched.lock`。
+
+```go
+type schedt struct {
+ lock mutex // 全局互斥锁
+ midle muintptr // 空闲 M 队列
+ pidle puintptr // 空闲 P 队列
+ runq gQueue // 全局 G 队列(GRQ)
+ runqsize int32 // GRQ 中 G 的数量
+ // ...
+}
+```
+
+> [!note] 📝 idle 队列的设计意图
+> `midle` 和 `pidle` 实现了资源的休眠与复用——不忙时释放回池中,有新任务时快速唤醒,避免 CPU 空转或频繁创建线程。
+
+## 关联笔记
+
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview]] — GMP 概览
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle]] — 创建与调度流程
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption]] — 抢占机制
diff --git a/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle.md b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle.md
new file mode 100644
index 0000000..9fd4a2e
--- /dev/null
+++ b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle.md
@@ -0,0 +1,285 @@
+---
+tags: [go, golang, go-principle, gmp-scheduler, lifecycle]
+create time: 2026-06-07 16:00
+---
+
+# GMP 调度原理 — Goroutine 生命周期
+
+## 概述
+
+本节从第一人称视角追踪 goroutine 的完整生命周期:从 `go func()` 触发的创建流程,到被调度器翻牌子执行,再到主动让出执行权的三种方式。涵盖 §3(正向追踪)和 §4(逆向追踪)。
+
+## 正文
+
+### 3.1 main 函数的特殊性
+
+`main` 函数是 Go 程序的唯一起点,由全局唯一的 `m0`(主线程)直接执行,不涉及普通的调度流程。
+
+```go
+func main() {
+ fn := main_main // 获取用户定义的 main 函数
+ fn() // 直接执行
+}
+```
+
+### 3.2 普通 G 的创建流程
+
+自己编写的 `go func(){...}` 最终被编译器转换为对 `runtime.newproc` 的调用:
+
+```go
+func newproc(fn *funcval) {
+ gp := getg()
+ pc := getcallerpc()
+
+ systemstack(func() {
+ newg := newproc1(fn, gp, pc) // ① 切换到 g0 栈 → 构造 G 实例
+ _p_ := getg().m.p.ptr()
+ runqput(_p_, newg, true) // ② 放入就绪队列
+ if mainStarted { wakep() } // ③ 唤醒空闲 P
+ })
+ // 切回原用户 G 继续执行
+}
+```
+
+**核心步骤**:
+
+1. **切换栈**:通过 `systemstack` 从当前用户 G 栈切到 M 的 `g0` 栈——创建 G 是调度层面的工作,必须交由 `g0` 处理。
+2. **构造 G**:`newproc1` 分配并初始化新的 `g` 结构体(设置入口地址、程序计数器等)。
+3. **入队**:`runqput` 按优先级放置:`runnext` → LRQ → GRQ(满时通过 `runqputslow` 批量迁移)。
+4. **唤醒**:若有休眠中的 P,`wakep` 将其拉起来干活。
+
+### 3.3 调度循环:从 g0 到 g
+
+每个 M 的生命周期在两种角色间循环:**执行 `g0`(找任务)** ↔ **执行用户 G(做任务)**。
+
+```mermaid
+flowchart LR
+ A["M 执行 g0"] -->|"schedule()"| B["findRunnable()"]
+ B -->|"找到 G"| C["execute(gp)"]
+ C -->|"gogo()"| D["M 执行用户 G"]
+ D -->|"G 让渡 / 阻塞 / 结束"| A
+ style A fill:#fff9c4
+ style D fill:#e8f5e9
+```
+
+关键桩函数:
+
+| 函数 | 方向 | 说明 |
+|------|------|------|
+| `mcall` / `systemstack` | G → g0 | 用户代码中切换至调度栈 |
+| `gogo` | g0 → G | 恢复用户 G 的上下文,交还 CPU |
+
+### 3.4 findRunnable:寻找任务的优先级策略
+
+这是调度环最核心的函数,按固定优先级依次查找:
+
+```mermaid
+flowchart TD
+ A["每 61 次检查 GRQ
防饥饿"] -->|"命中"| Z["返回 G ✓"]
+ A -->|"未命中"| B["LRQ: runqget
无锁 CAS"]
+ B -->|"有"| Z
+ B -->|"空"| C["GRQ: globrunqget
加锁"]
+ C -->|"有"| Z
+ C -->|"空"| D["netpoll
非阻塞 epoll_wait"]
+ D -->|"有"| Z
+ D -->|"空"| E["work-stealing
随机偷其他 P 的一半"]
+ E -->|"成功"| Z
+ E -->|"失败"| F["再次检查 GRQ"]
+ F -->|"有"| Z
+ F -->|"空"| G["释放 P → pidleput
阻塞 netpoll 最后一次机会
否则 stopm → 休眠"]
+ style A fill:#e8f5e9
+ style B fill:#c8e6c9
+ style C fill:#fff3e0
+ style D fill:#fff9c4
+ style E fill:#ffebee
+ style G fill:#eceff1
+```
+
+源码路径:`runtime/proc.go`
+
+### 3.5 本地与全局队列获取细节
+
+#### 本地队列(无锁)
+
+```go
+func runqget(_p_ *p) (gp *g, inheritTime bool) {
+ // 先尝试 runnext VIP 位
+ next := _p_.runnext
+ if next != 0 && _p_.runnext.cas(next, 0) {
+ return next.ptr(), true
+ }
+ // CAS 自旋取头部
+ for {
+ h := atomic.LoadAcq(&_p_.runqhead)
+ t := _p_.runqtail
+ if t == h { return nil, false }
+ gp := _p_.runq[h%256].ptr()
+ if atomic.CasRel(&_p_.runqhead, h, h+1) {
+ return gp, false
+ }
+ }
+}
+```
+
+`runnext` 存放刚创建的或高优先级的 G,跳过队列开销直接执行。
+
+#### 全局队列(加锁)
+
+```go
+func globrunqget(_p_ *p, max int32) *g {
+ assertLockHeld(&sched.lock)
+ if sched.runqsize == 0 { return nil }
+ gp := sched.runq.pop()
+ return gp
+}
+```
+
+> [!question] ❓ 为什么需要锁?
+> LRQ 是 per-P 私有数据,并发操作可通过 CAS 保证原子性;GRQ 被所有 P 共享,必须用互斥锁。
+
+### 3.6 网络 IO 事件处理
+
+```mermaid
+sequenceDiagram
+ participant Net as netpoll
+ participant EP as epoll_wait
+ participant Q as gList
+ loop 遍历就绪事件
+ Net->>EP: epollwait(fd, events, 128, timeout)
+ EP-->>Net: n 个就绪事件
+ Net->>Q: netpollready(event)
+ end
+ Note over Q: 返回待运行的 G 列表
+```
+
+位于 `runtime/netpoll_epoll.go`,每次最多批量处理 128 个事件。
+
+### 3.7 Work-Stealing 工作窃取
+
+当本地和全局队列为空时,P 会从其他繁忙的 P 那里"偷"一半 G:
+
+```go
+func stealWork(now int64) (...) {
+ const stealTries = 4 // 最多试探 4 轮
+ for i := 0; i < stealTries; i++ {
+ for enum := stealOrder.start(fastrand()); !enum.done(); enum.next() {
+ p2 := allp[enum.position()]
+ if pp == p2 { continue } // 不偷自己
+ if idlepMask.read(enum.position()){ continue } // 目标也是 idle,跳过
+ if gp := runqsteal(pp, p2, ...); gp != nil {
+ return gp, ... // 偷到一半,成功!
+ }
+ }
+ }
+ return nil, ...
+}
+```
+
+设计要点:
+- **随机起始**:`fastrand()` 打乱探查顺序,避免热点竞争
+- **偷一半**:`runqsteal` 窃取目标 P LRQ 中的一半而非全部,减少反复争夺
+- **4 轮试探**:兼顾负载均衡与 CPU 利用率
+
+### 3.8 P/M 回收机制
+
+无事可做时,将闲置资源归还池中以节省 CPU:
+
+```go
+// 释放 P 并放回 pidle 队列
+releasep()
+_p_ = pidleput(_p_, now)
+
+// 停止 M 并放入 midle 队列
+stopm() // → mPark() → pthread_cond_wait()
+```
+
+> [!tip] 💡 优雅缩容
+> sysmon 线程还会定期清理长时间处于 `_Psyscall` 状态的 P(见抢占篇),防止因系统调用导致 P 被白白占用。
+
+### 4.1 让渡总览
+
+G 拿到 CPU 后需要适时归还执行权,让给其他 G 使用。存在三种让渡方式:
+
+```mermaid
+flowchart TD
+ A["正在执行的 G"] --> B{"如何让渡?"}
+ B -->|"正常结束"| C["goexit1 → goexit0
状态→Gdead,回收复用"]
+ B -->|"主动让出"| D["Gosched → gosched_m
状态→Grunnable,入 GRQ"]
+ B -->|"等待外部条件"| E["gopark → park_m
状态→Gwaiting,上层保管"]
+ C & D & E --> F["g0 调用 schedule() 寻找下一个 G"]
+ style C fill:#e8f5e9
+ style D fill:#fff9c4
+ style E fill:#e3f2fd
+```
+
+### 4.2 功成身退:执行结束
+
+```go
+func goexit1() { mcall(goexit0) } // G → g0
+
+func goexit0(gp *g) { // g0 执行
+ casgstatus(gp, _Grunning, _Gdead) // 标记死亡
+ dropg() // 解除 M 绑定
+ gfput(_p_, gp) // 回收到 gfree 链表
+ schedule() // 下一轮调度
+}
+```
+
+被回收的 G 缓存在 P 的 `gfree` 链表中,下次 `newproc` 可直接复用,无需重新 malloc。
+
+### 4.3 主动让出:Gosched
+
+```go
+func Gosched() { mcall(gosched_m) } // G → g0
+
+func goschedImpl(gp *g) { // g0 执行
+ casgstatus(gp, _Grunning, _Grunnable)
+ dropg()
+ lock(&sched.lock); globrunqput(gp); unlock(&sched.lock) // 入 GRQ
+ schedule()
+}
+```
+
+> [!note] 📝 与 goexit 的区别
+> Gosched 将 G 放回 **GRQ**(等待再次调度),goexit 将 G 放回 **gfree**(彻底回收)。
+
+### 4.4 情非得已:阻塞让渡(gopark / goready)
+
+最常见的让渡方式——等待 channel 数据、Mutex、Timer 等外部条件触发。
+
+**阻塞流程**(`gopark`):
+
+```go
+func gopark(...) { mcall(park_m) } // G → g0
+
+func park_m(gp *g) { // g0 执行
+ casgstatus(gp, _Grunning, __Gwaiting)
+ dropg()
+ schedule() // g0 去找别的 G
+}
+```
+
+关键点:`_Gwaiting` 状态的 G **不入任何就绪队列**,由上层调用者(channel / mutex 等)自行保管。
+
+**唤醒流程**(`goready` → `ready`):
+
+```go
+func goready(gp *g, traceskip int) {
+ systemstack(func() { ready(gp, traceskip, true) })
+}
+
+func ready(gp *g, traceskip int, next bool) { // g0 执行
+ casgstatus(gp, _Gwaiting, _Grunnable)
+ runqput(_g_.m.p.ptr(), gp, next) // 入 LRQ 或 GRQ
+ wakep() // 唤醒空闲 P
+}
+```
+
+这一 `park` 一 `ready` 构成了 Go 并发原语的基础——G 级别阻塞,不拖垮 OS 线程。
+
+## 关联笔记
+
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview]] — GMP 概览
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures]] — G/M/P/Schedt 数据结构
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption]] — 抢占式调度机制
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary]] — 知识卡片
diff --git a/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview.md b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview.md
new file mode 100644
index 0000000..3b9d08c
--- /dev/null
+++ b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview.md
@@ -0,0 +1,147 @@
+---
+tags: [go, golang, go-principle, gmp-scheduler, overview]
+create time: 2026-06-07 16:00
+---
+
+# GMP 调度原理 — 概览
+
+## 概述
+
+本文档是 Go GMP 调度模型的入门篇章,从宏观架构角度回答三个核心问题:Go 为什么不用原生 OS 线程做并发?G/M/P 三个角色各自做什么?它们之间如何协作完成工作窃取、负载均衡和 IO 轮询?
+
+读完本节后,你将建立起 GMP 的全局视图,后续章节将深入源码层面拆解每个组件的数据结构和调度流程。
+
+## 正文
+
+### 1.1 从线程到协程
+
+在理解 goroutine 之前,需要先区分两个基础概念:**线程(Thread)** 和 **协程(Coroutine)**。
+
+```mermaid
+graph LR
+ A["内核态"] --> B["线程
OS 管理
切换成本高"]
+ C["用户态"] --> D["协程
自我管理
切换成本极低"]
+ style A fill:#fce4ec
+ style C fill:#e8f5e9
+ style B fill:#fff9c4
+ style D fill:#e3f2fd
+```
+
+- **线程**:操作系统内核管理的执行单元,每次上下文切换需要陷入内核态(保存寄存器、切换页表等),开销较大但稳定性高。
+- **协程**:运行在用户态的轻量级执行流,由应用程序自主调度,切换仅需修改栈指针,开销极小。
+
+**结论**:线程重而稳,协程轻而快。
+
+### 1.2 Go 的答案:goroutine
+
+Go 没有直接采用传统协程模型,而是在其之上构建了 **GMP 调度体系**,使 goroutine 获得两大核心优势:
+
+1. **灵活调度**:G(goroutine)、M(machine,OS 线程)、P(processor,逻辑处理器)三者可动态绑定和解绑,支持水平伸缩。
+2. **动态栈**:初始栈仅 2~8KB,随使用量自动扩容或收缩,兼顾便利性和内存利用率。
+
+Go 在顶层屏蔽了系统线程的概念——开发者只与 goroutine 打交道,调度细节全部由 runtime 接管。
+
+### 1.3 GMP 架构全景
+
+| 角色 | 职责 | 类比(工厂) |
+|------|------|-------------|
+| **G** | 任务单元,包含执行栈、状态、要执行的函数体 | 工作任务 |
+| **M** | OS 线程封装,真正执行代码的"工人" | 工人 |
+| **P** | 调度器,管理本地队列,协调 M 与 G 的关系 | 车间主管 |
+
+```mermaid
+graph TB
+ subgraph P0["P0"]
+ LRQ0["LRQ: G5 → G6 → G7"]
+ end
+ subgraph P1["P1"]
+ LRQ1["LRQ: G8"]
+ end
+ GRQ["GRQ 全局队列
[G1, G2, G3, G4]"]
+ M0["M0"] --> P0_node["P0"]
+ M1["M1"] --> P1_node["P1"]
+ P0_node --> LRQ0
+ P1_node --> LRQ1
+ LRQ0 -.work-stealing.-> LRQ1
+ LRQ1 -.work-stealing.-> LRQ0
+ GRQ -->|"LRQ 空时取"| P0_node
+ GRQ -->|"LRQ 空时取"| P1_node
+ style GRQ fill:#fff9c4
+ style LRQ0 fill:#e8f5e9
+ style LRQ1 fill:#e8f5e9
+```
+
+#### 两种队列
+
+G 存放在两种队列中,获取优先级由高到低:
+
+| 队列 | 说明 | 锁 | 容量 |
+|------|------|-----|------|
+| **LRQ**(Local Run Queue) | 每个 P 私有的 G 队列 | 无锁 CAS | 最多 256 个 |
+| **GRQ**(Global Run Queue) | 所有 P 共享的全局队列 | `sched.lock` | 理论上无限 |
+
+**放置策略**:新创建的 G 优先放入当前 P 的 LRQ;LRQ 满时才加锁放入 GRQ。
+
+**获取策略**(`findrunnable` 的执行顺序):
+
+```mermaid
+flowchart TD
+ A["LRQ
无锁 CAS,最快"] -->|"空"| B{"GRQ
需加锁"}
+ B -->|"空"| C["netpoll IO 就绪
非阻塞 epoll_wait"]
+ B -->|"有"| E["找到 G ✓"]
+ C -->|"有"| E
+ C -->|"空"| D["work-stealing
偷其他 P 的一半"]
+ D -->|"成功"| E
+ D -->|"失败"| F["P/M 进入休眠"]
+ style A fill:#e8f5e9
+ style B fill:#fff3e0
+ style C fill:#fff9c4
+ style D fill:#ffebee
+ style F fill:#eceff1
+```
+
+> [!note] 📝 防饥饿机制
+> 为防止 GRQ 中的 G 长期饿死,每 61 次调度循环强制检查一次 GRQ,保证公平性。
+
+### 1.4 GMP 生态圈
+
+GMP 是 Go 运行时的心跳中枢,上层多数子系统都围绕它设计。
+
+#### 1.4.1 内存管理
+
+Go 借鉴 Google TCMalloc 思想,为每个 P 配备私有缓存 `mcache`。P 上的 G 分配小对象时直接从 `mcache` 取,完全无锁。
+
+```mermaid
+graph LR
+ G1["G₁"] -->|无锁| MC1["P₀ → mcache"]
+ G2["G₂"] -->|无锁| MC1
+ MC1 -->|"mcache 耗尽"| MH["mcentral → mspan"]
+ MH -->|"mspan 耗尽"| MM["mmapped 直接映射"]
+ style MC1 fill:#e8f5e9
+ style MH fill:#fff9c4
+ style MM fill:#fce4ec
+```
+
+#### 1.4.2 并发工具(Mutex / Channel)
+
+Go 的同步原语是 **G 级别** 的——当 G 因等待 channel 数据或 Mutex 而阻塞时,它调用 `gopark` 主动让出 M,而不是阻塞整条 OS 线程。这使得单个 OS 线程上可以承载海量并发。
+
+> [!question] ❓ 对比思考
+> C++ 标准库锁一旦持有,阻塞的是整个线程,该线程上的所有协程都被迫等待。Go 通过 G 级别阻塞实现了更细粒度的并发控制。
+
+#### 1.4.3 IO 多路复用(netpoll)
+
+网络 IO 场景下,Go 使用 Linux `epoll` 作为底层轮询机制,并通过 `netpoll` 将其包装为 G 级别的异步通知:
+
+- G 发起 IO → `gopark` 挂起自身
+- OS 就绪 → netpoll 发现 → `goready` 唤醒 G
+
+IO 操作由此无缝融入 GMP 调度环,无需额外线程。
+
+## 关联笔记
+
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures]] — G/M/P/Schedt 数据结构源码剖析
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle]] — Goroutine 创建、调度与让渡流程
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption]] — sysmon 抢占式调度机制
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary]] — 知识卡片与全景回顾
+- [[hzh/GolangStar/Go语言进阶/Goroutine]] — Goroutine 基础概念
diff --git a/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption.md b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption.md
new file mode 100644
index 0000000..8b35bd7
--- /dev/null
+++ b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption.md
@@ -0,0 +1,202 @@
+---
+tags: [go, golang, go-principle, gmp-scheduler, preemption]
+create time: 2026-06-07 16:00
+---
+
+# GMP 调度原理 — 抢占式调度
+
+## 概述
+
+前面讨论的让渡都是 G 的主动行为。但如果一个 G 执行纯计算循环,从不阻塞、不让出 CPU,整个系统就会被它拖垮。本节介绍 Go 调度器的"第三只手"——由后台 `sysmon` 线程发起的**抢占式调度**。涵盖 §5:system monitor、系统调用抢占、协作与非协作抢占。
+
+## 正文
+
+### 5.1 sysmon:永不休息的巡逻兵
+
+Go 程序启动时,runtime 通过 `newm(sysmon, nil, -1)` 创建一个独立的 OS 线程专跑 `sysmon`。它全程唯一、终身运行。
+
+```go
+func sysmon() {
+ for {
+ usleep(delay) // 自适应休眠(最长 10ms)
+
+ if netpollinited() && lastpoll+10ms < now {
+ list := netpoll(0) // ① 非阻塞网络轮询
+ injectglist(&list) // 将就绪 G 放回全局队列
+ }
+
+ retake(now) // ② 抢占检查
+
+ if t.test() && forcegc.idle != 0 {
+ // ③ GC 触发检查
+ }
+ }
+}
+```
+
+三次巡检职责:
+
+| 功能 | 说明 |
+|------|------|
+| **netpoll** | 从 epoll 取出已完成的 IO 事件,唤醒对应 G |
+| **retake** | 遍历所有 P,发现超时或 syscall 过久的立即抢占 |
+| **GC 检查** | 判断是否需要触发强制垃圾回收 |
+
+### 5.2 系统调用抢占
+
+当一个 G 发起 syscall 时,对应的 M 会被操作系统挂起,绑定的 P 也随之闲置。Go 的策略是:**人走可以,但办公桌留下。**
+
+**进入 syscall**(`reentersyscall`):
+
+```go
+func reentersyscall(pc, sp uintptr) {
+ casgstatus(_g_, _Grunning, _Gsyscall)
+
+ pp := _g_.m.p.ptr()
+ pp.m = 0 // 解除 P → M
+ _g_.m.p = 0 // 解除 M → P
+
+ _g_.m.oldp.set(pp) // 记住原 P(弱引用)
+ atomic.Store(&pp.status, _Psyscall)
+}
+```
+
+退出 syscall 时有两条路径:
+
+```mermaid
+flowchart TD
+ A["G 退出 syscall"] --> B{exitsyscallfast?}
+ B -->|"是: oldP 仍单身"| C["快速路径
复用 oldP
状态→Grunning"]
+ B -->|"否: oldP 被抢"| D["慢速路径
mcall exitsyscall0
找新 P / 入 GRQ / stopm"]
+ style C fill:#e8f5e9
+ style D fill:#fff3e0
+```
+
+```go
+func exitsyscall() {
+ oldp := _g_.m.oldp.ptr()
+ if exitsyscallfast(oldp) { // 快速路径
+ casgstatus(_g_, _Gsyscall, _Grunning)
+ return
+ }
+ mcall(exitsyscall0) // 慢速路径
+}
+```
+
+**sysmon 介入**:若 P 处于 `_Psyscall` 超过 10ms,`retake` 会强制将 P 从 syscall 的 M 处夺走,分配给新的空闲 M:
+
+```go
+// retake 中关键片段
+if s == _Psyscall {
+ if runqempty(_p_) && pd.syscallwhen+10ms > now {
+ continue // 刚进去不久且队列为空,暂不抢占
+ }
+ atomic.Cas(&_p_.status, s, _Pidle)
+ handoffp(_p_) // 抢夺 P,分配给新 M
+}
+```
+
+### 5.3 运行超时抢占
+
+对持续运行的 G(如纯计算死循环),`sysmon` 通过 `preemptone` 发起超时抢占。这分为两代实现:
+
+#### 5.3.1 协作式抢占(Go ≤ 1.13)
+
+`preemptone` 在目标 G 上打两个标记:
+
+```go
+func preemptone(_p_ *p) bool {
+ mp := _p_.m.ptr()
+ gp := mp.curg
+
+ gp.preempt = true // 抢占标志
+ gp.stackguard0 = stackPreempt // 栈保护区特殊值
+ return true
+}
+```
+
+G 在执行函数调用时(尤其是触发栈扩容的 `newstack`),会检查 `stackguard0`:
+
+```go
+func newstack() {
+ stackguard0 := atomic.Loaduintptr(&gp.stackguard0)
+ if stackguard0 == stackPreempt {
+ if canPreemptM(thisg.m) {
+ gopreempt_m(gp) // 响应抢占,殊途同归 goschedImpl()
+ }
+ }
+}
+```
+
+**缺点**:如果一个 G 一直在跑无函数调用的纯计算死循环,永远不检查 `stackguard0`,就不会响应抢占意图。
+
+#### 5.3.2 非协作式抢占(Go ≥ 1.14)
+
+为解决上述短板,Go 1.14 引入基于 POSIX 信号的硬抢占机制:
+
+```go
+func preemptone(_p_ *p) bool {
+ // ... 上面设置协作标记的代码不变 ...
+
+ if preemptMSupported && debug.asyncpreemptoff == 0 {
+ preemptM(mp) // 向目标线程发送 sigPreempt 信号
+ }
+ return true
+}
+
+func signalM(mp *m, sig int) {
+ pthread_kill(pthread(mp.procid), uint32(sig)) // 底层 syscall
+}
+```
+
+信号到达后,操作系统的信号处理函数 `sighandler` → `doSigPreempt` 会通过修改寄存器的"指令注入"方式强行接管执行流:
+
+```mermaid
+flowchart TD
+ A["sigPreempt 信号到达"] --> B["sighandler 检查 safepoint"]
+ B --> C["pushCall: 修改 PC + SP"]
+ C --> D["下一条指令跳入 asyncPreempt"]
+ D --> E["mcall gopreempt_m"]
+ E --> F["goschedImpl: 状态→Grunnable → GRQ"]
+ style A fill:#ffebee
+ style D fill:#fff9c4
+ style F fill:#e8f5e9
+```
+
+```go
+func doSigPreempt(gp *g, ctxt *sigctxt) {
+ if wantAsyncPreempt(gp) {
+ if ok, newpc := isAsyncSafePoint(...); ok {
+ ctxt.pushCall(abi.FuncPCABI0(asyncPreempt), newpc)
+ }
+ }
+}
+
+func pushCall(targetPC, resumePC uintptr) {
+ sp -= goarch.PtrSize
+ *(*uintptr)(unsafe.Pointer(sp)) = resumePC // 压入返回地址
+ c.set_rsp(uint64(sp)) // 更新栈指针
+ c.set_rip(uint64(targetPC)) // 劫持程序计数器
+}
+```
+
+这条链路的特点是:**无论 G 在做什么**——不管有没有函数调用、是不是死循环——只要收到信号并被确认为安全中断点,就强制执行抢占。这是操作系统级别的强制手段,Go runtime 无法绕过。
+
+### 5.4 小结对比
+
+| 抢占类型 | 触发条件 | 方式 | 生效时机 |
+|----------|----------|------|----------|
+| 系统调用抢占 | P 处于 `_Psyscall` > 10ms | `handoffp` 夺回 P | sysmon 定期检查 |
+| 协作式抢占 | G 运行 > 10ms | 设置 `stackPreempt` 标记 | G 下次函数调用/栈检查时 |
+| 非协作式抢占 | G 运行 > 10ms | 发送 `sigPreempt` 信号并注入代码 | 信号中断后立即执行 |
+
+> [!question] ❓ 为什么保留协作式抢占?
+> 信号机制有平台限制(Windows 不支持),协作式作为兜底方案始终有效;同时对于大多数有 IO 或 channel 操作的 G,协作式抢占已经足够及时。
+
+## 关联笔记
+
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview]] — GMP 概览
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures]] — G/M/P/Schedt 数据结构
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle]] — Goroutine 生命周期
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary]] — 知识卡片
+- [[hzh/GolangStar/Go语言原理/垃圾回收]] — sysmon 如何触发 GC
diff --git a/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary.md b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary.md
new file mode 100644
index 0000000..feefa5a
--- /dev/null
+++ b/hzh/GolangStar/Go语言原理/gmp调度原理/gmp-summary.md
@@ -0,0 +1,91 @@
+---
+tags: [go, golang, go-principle, gmp-scheduler, summary, cheat-sheet]
+create time: 2026-06-07 16:00
+---
+
+# GMP 调度原理 — 知识卡片
+
+## 概述
+
+本节汇总 GMP 调度模型的全景流程与核心要点,适合作为复习回顾的速查卡片。涵盖 §6:完整生命周期流程图和关键概念总结。
+
+## 正文
+
+### 6.1 GMP 全景流程
+
+```mermaid
+flowchart TD
+ subgraph Create["创建 goroutine"]
+ NewProc["runtime.newproc
systemstack → newproc1
runqput → LRQ/GRQ"]
+ end
+
+ subgraph Schedule["调度循环"]
+ ScheduleFn["schedule → findRunnable"]
+ FindR["findRunnable: LRQ → GRQ → netpoll → steal"]
+ Execute["execute → gogo(g)"]
+ end
+
+ subgraph Yield["让出执行权"]
+ End["goexit1 → goexit0
status=Gdead, gfput"]
+ Gosched["Gosched → gosched_m
status=Grunnable, globrunqput"]
+ Park["gopark → park_m
status=Gwaiting, 上层管理"]
+ end
+
+ subgraph Preempt["抢占 sysmon"]
+ Sysmon["sysmon 线程"]
+ Retake["retake: syscall + timeout"]
+ Collab["协作式: stackPreempt"]
+ Signal["非协作式: sigPreempt"]
+ end
+
+ subgraph Recover["恢复执行"]
+ Ready["goready → ready
status=Grunnable, runqput"]
+ end
+
+ Create --> Schedule
+ Schedule --> Yield
+ Yield --> Recover
+ Recover --> Schedule
+ Sysmon --> Preempt
+ Preempt --> Yield
+ style Create fill:#e3f2fd
+ style Schedule fill:#e8f5e9
+ style Yield fill:#fff3e0
+ style Preempt fill:#ffebee
+ style Recover fill:#e8f5e9
+```
+
+### 6.2 核心要点速查
+
+| 维度 | 要点 |
+|------|------|
+| **角色分工** | G = 任务(goroutine),M = 工人(OS 线程),P = 主管(逻辑处理器) |
+| **队列优先级** | LRQ(无锁 CAS)> GRQ(加锁)> netpoll(IO)> steal(工作窃取) |
+| **防饥饿** | 每 61 次调度强制检查一次 GRQ |
+| **LRQ 容量** | 256 个 G;满时触发 `runqputslow` 批量迁移至 GRQ |
+| **runnext** | VIP 位置,新创建的 G 优先放入,下次调度直接执行 |
+| **协程状态机** | `_Gidle → _Grunnable → _Grunning → { _Gdead / _Gwaiting / _Gsyscall }` |
+| **让渡方式** | 结束→回收到 `gfree`;`Gosched`→入 GRQ;`gopark`→`_Gwaiting` 由上层保管 |
+| **唤醒机制** | `goready → ready`:改状态→`runqput`→`wakep()` |
+| **系统调用抢占** | `reentersyscall` 解绑 P/M;exitsyscall 快速路径复用 oldP / 慢速路径重新分配 |
+| **协作式抢占** | 设置 `stackPreempt`,在函数调用/栈检查时响应 |
+| **非协作式抢占** | Go ≥ 1.14,通过 POSIX 信号注入 `asyncPreempt`,绕过函数调用依赖 |
+| **sysmon 三板斧** | netpoll(IO 轮询)→ retake(抢占检查)→ GC 触发 |
+
+### 6.3 关键数据记忆点
+
+| 数字 | 含义 |
+|------|------|
+| **256** | LRQ 最大容量 |
+| **61** | 每次 GRQ 强制检查间隔(schedtick) |
+| **10ms** | syscall 超时阈值、运行抢占阈值(`forcePreemptNS`) |
+| **4** | work-stealing 最大试探轮数 |
+| **128** | netpoll epoll_wait 单次最多返回事件数 |
+
+## 关联笔记
+
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-overview]] — GMP 概览
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-datastructures]] — G/M/P/Schedt 数据结构
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-lifecycle]] — Goroutine 生命周期
+- [[hzh/GolangStar/Go语言原理/gmp调度原理/gmp-preemption]] — 抢占式调度机制
+- [[hzh/GolangStar/Go面试题库/GMP面试题]] — 高频面试题
diff --git a/hzh/GolangStar/Go语言进阶/并发概述.md b/hzh/GolangStar/Go语言进阶/并发概述.md
index dfa8aff..04f44d5 100644
--- a/hzh/GolangStar/Go语言进阶/并发概述.md
+++ b/hzh/GolangStar/Go语言进阶/并发概述.md
@@ -74,8 +74,8 @@ timeline
Task A : 执行 : 执行 : 执行
Task B : 执行 : 执行 : 执行
section 并发 (单核)
- Task A : 执行1 : : 执行3
- Task B : : 执行2 :
+ Task A : 执行1 : 空闲 : 执行3
+ Task B : 空闲 : 执行2 : 空闲
```
如图所示: