vault backup: 2026-06-07 12:14:39
This commit is contained in:

+139
-124
@@ -1,164 +1,179 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- map
|
||||
- 面试题
|
||||
- map面试题
|
||||
tags: [go, golang, interview, map-questions]
|
||||
create time: 2026-06-07 14:30
|
||||
---
|
||||
|
||||
# Map面试题
|
||||
# Map 面试题 🗺️
|
||||
|
||||
## 1. Go语言Map的底层实现原理是怎样的?
|
||||
## 概述
|
||||
|
||||
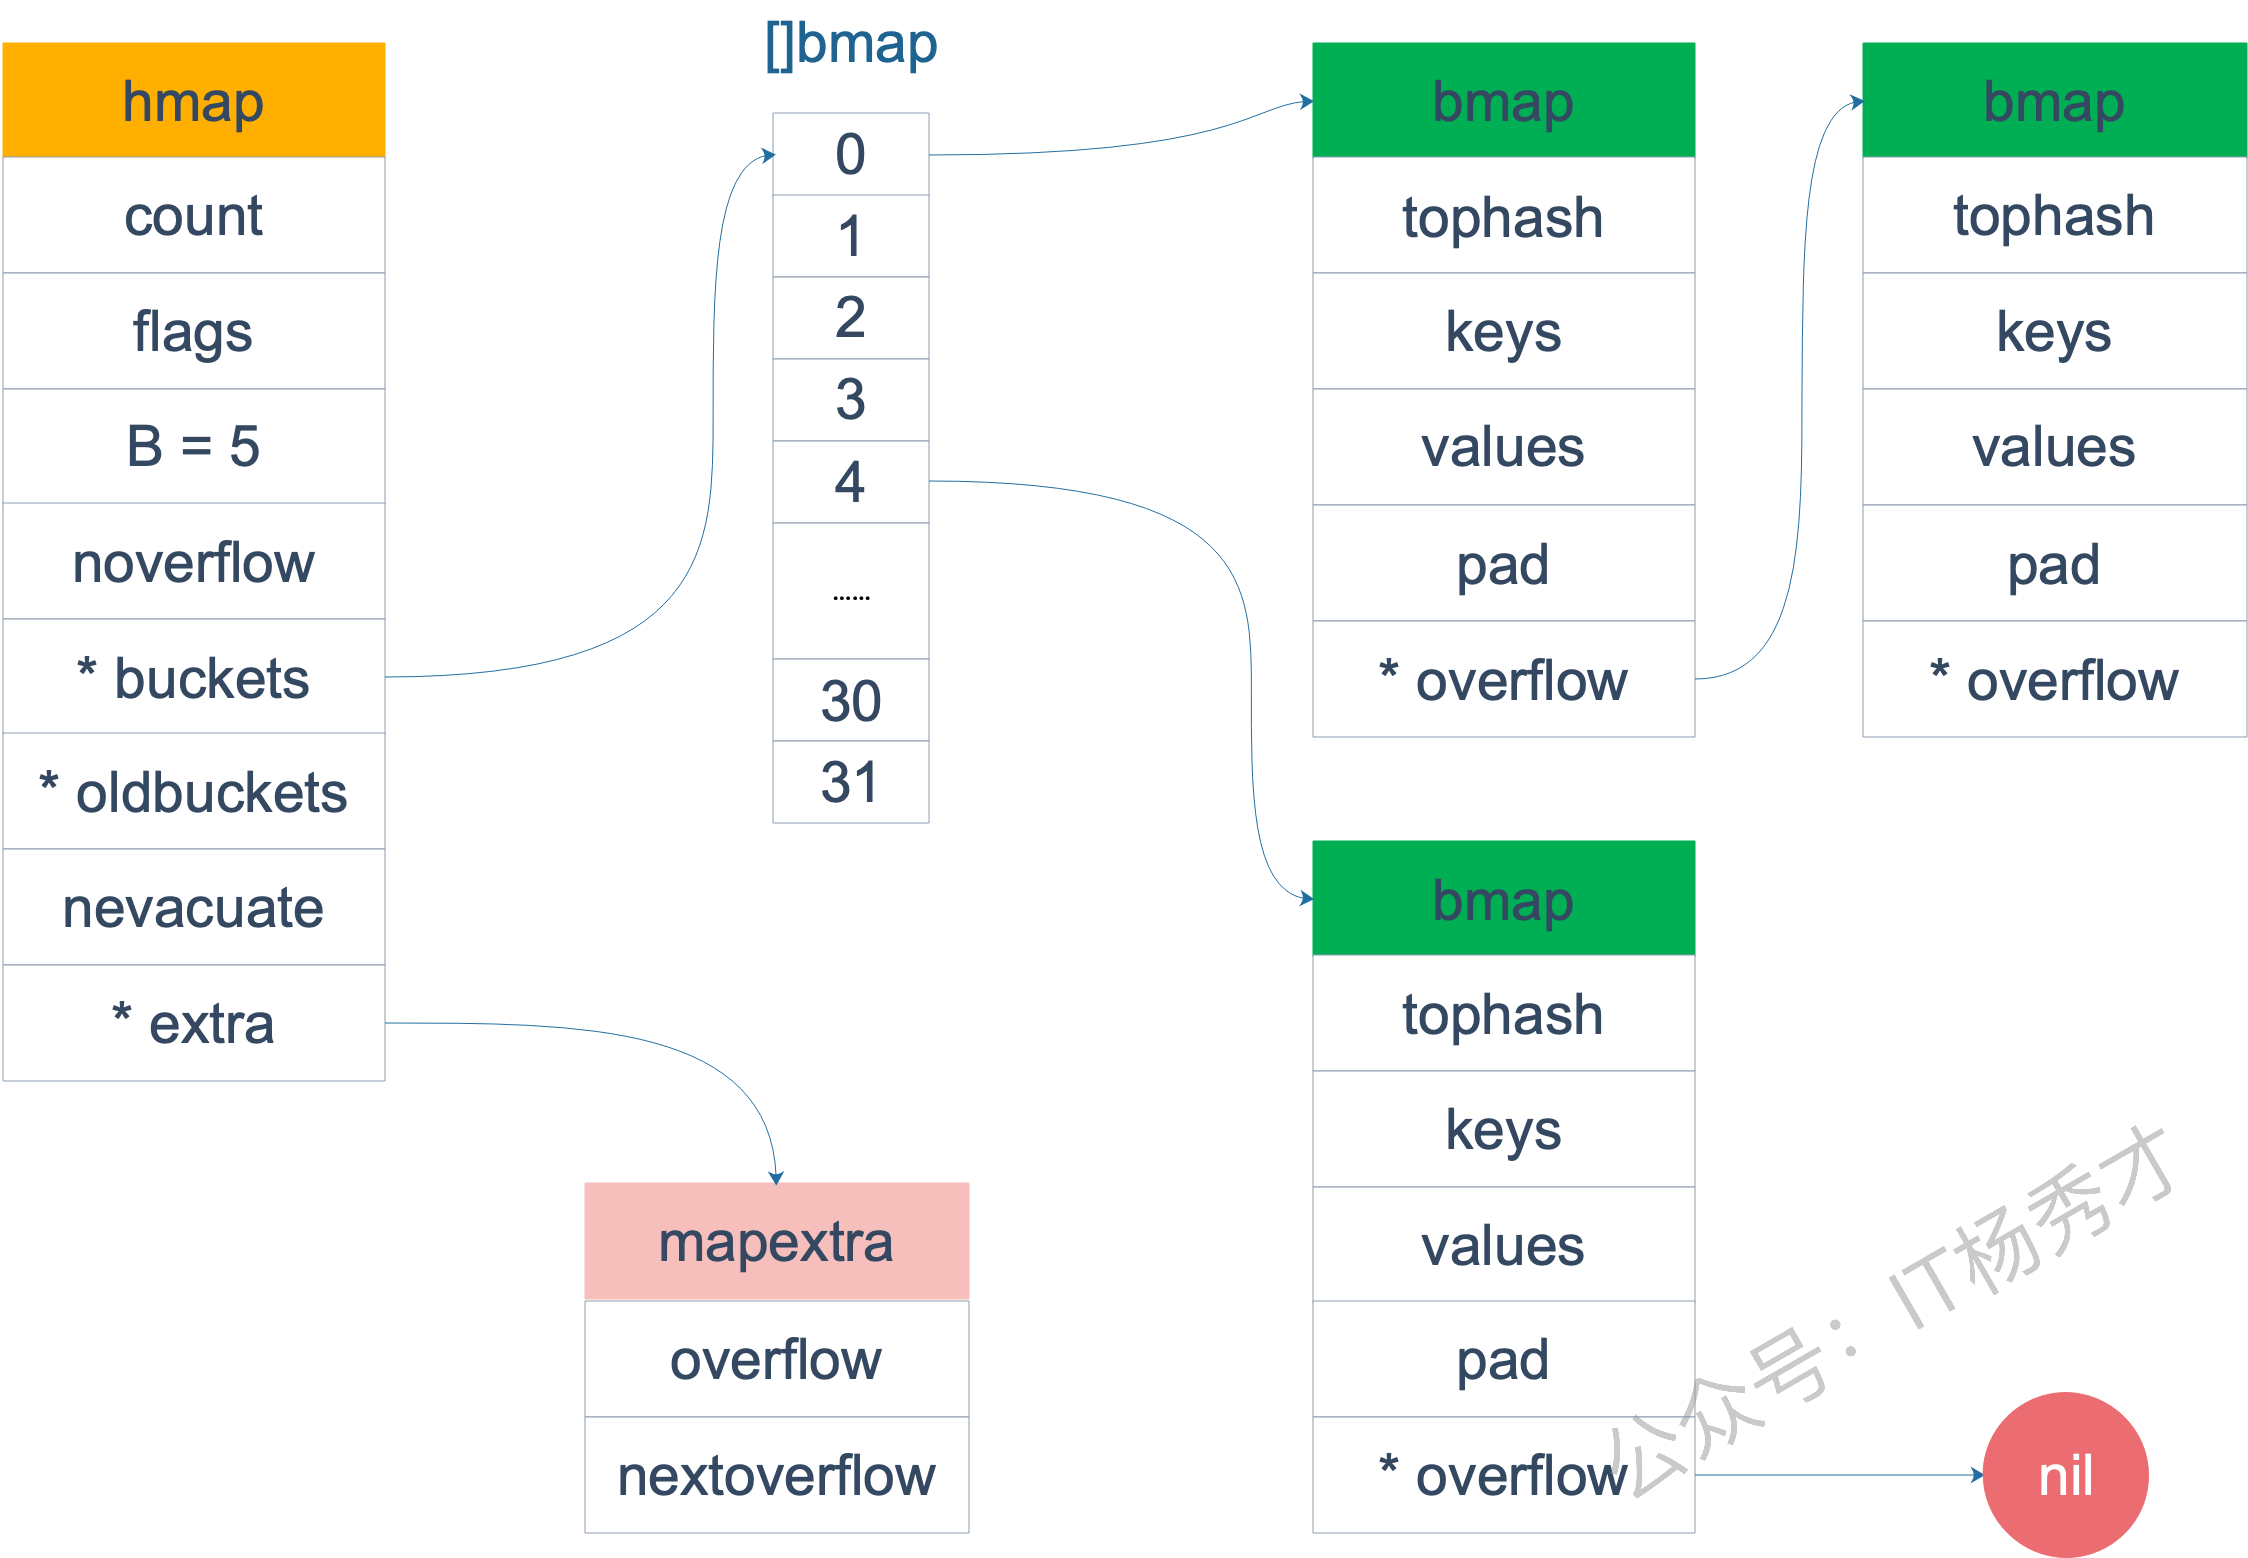
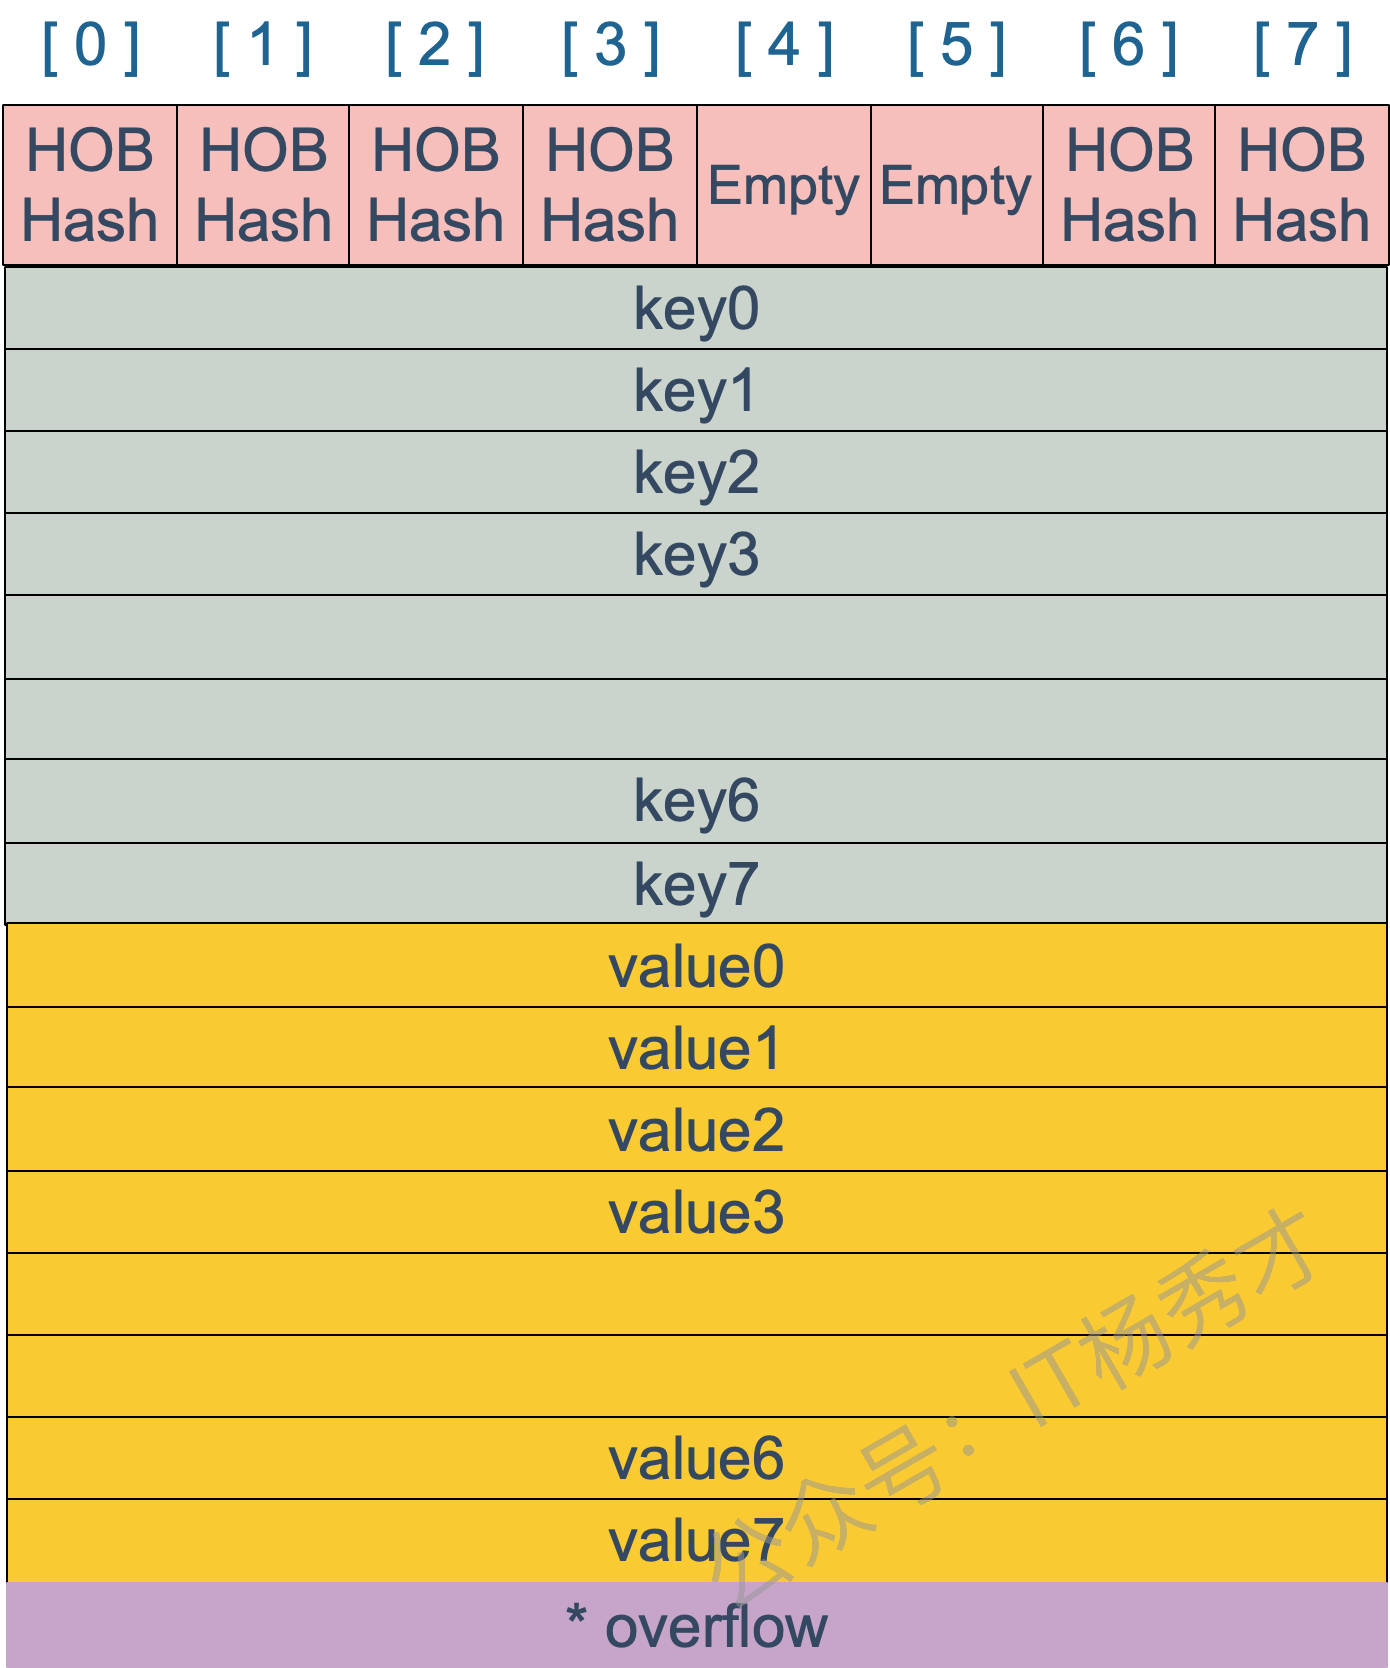
map的就是一个hmap的结构。Go Map的底层实现是一个**哈希表**。它在运行时表现为一个指向`hmap`结构体的指针,`hmap`中记录了**桶数组指针`buckets`**、**溢出桶指针**以及**元素个数**等字段。每个桶是一个`bmap`结构体,能存储**8个键值对**和**8个`tophash`**,并有指向下一个**溢出桶的指针`overflow`**。为了**内存紧凑**,`bmap`中采用的是先存8个键再存8个值的存储方式。
|
||||
本文件涵盖 Go Map 的 11 道高频面试题,涉及底层原理、遍历顺序、并发安全、扩容机制等核心考点。Map 是 Go 中使用频率最高的数据结构之一,也是面试中的"常客"。
|
||||
|
||||
## 关联笔记
|
||||
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言Map]] — Map 基础用法
|
||||
- [[hzh/GolangStar/Go语言原理/map原理]] — Map 底层源码详解
|
||||
- [[hzh/GolangStar/Go面试题库/Sync面试题]] — sync.Map 替代方案
|
||||
- [[hzh/GolangStar/Go面试题库/内存管理面试题]] — Map 删除不释放内存
|
||||
|
||||
## 正文
|
||||
|
||||
### Q1:Map 的底层实现原理? 🟡中等
|
||||
|
||||
> [!question] ❓ 思考一下
|
||||
> 如果让你设计一个哈希表,你会怎么组织存储结构来兼顾查找速度和内存利用率?
|
||||
|
||||
## 参考答案
|
||||
|
||||
Go Map 的底层是一个指向 `hmap` 结构体的指针,本质是**哈希表**。
|
||||
|
||||
**分析:**
|
||||
hmap结构定义:
|
||||
```go
|
||||
// A header for a Go map.
|
||||
type hmap struct {
|
||||
count int // map中元素个数
|
||||
flags uint8 // 状态标志位,标记map的一些状态
|
||||
B uint8 // 桶数以2为底的对数,即B=log_2(len(buckets)),比如B=3,那么桶数为2^3=8
|
||||
noverflow uint16 //溢出桶数量近似值
|
||||
hash0 uint32 // 哈希种子
|
||||
|
||||
buckets unsafe.Pointer // 指向buckets数组的指针
|
||||
oldbuckets unsafe.Pointer // 是一个指向buckets数组的指针,在扩容时,oldbuckets 指向老的buckets数组(大小为新buckets数组的一半),非扩容时,oldbuckets 为空
|
||||
nevacuate uintptr // 表示扩容进度的一个计数器,小于该值的桶已经完成迁移
|
||||
|
||||
extra *mapextra // 指向mapextra 结构的指针,mapextra 存储map中的溢出桶
|
||||
count int // 元素个数
|
||||
flags uint8 // 状态标志位
|
||||
B uint8 // 桶数 = 2^B
|
||||
noverflow uint16 // 溢出桶数量
|
||||
hash0 uint32 // 哈希种子
|
||||
buckets unsafe.Pointer // 主桶数组
|
||||
oldbuckets unsafe.Pointer // 扩容时的旧桶数组
|
||||
nevacuate uintptr // 扩容进度计数器
|
||||
extra *mapextra // 溢出桶(key/value 较大时)
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
每个桶(`bmap`)能存储 **8 个键值对** + **8 个 tophash**,采用先存 8 个 key 再存 8 个 value 的紧凑布局。
|
||||
|
||||
bmap结构如下:
|
||||
> [!note] 📝 核心考点
|
||||
> 面试官追问时要点出:**tohash 高位优化**——每次比较前先对比 tophash 而不是直接比 key,减少昂贵的 key 比较次数。
|
||||
|
||||
|
||||
> [!info] 🔗 延伸阅读
|
||||
> - [[hzh/GolangStar/Go语言原理/map原理]] — 完整的 bucket/bmap 结构图解
|
||||
|
||||
## 2. Go语言Map的遍历是有序的还是无序的?
|
||||
---
|
||||
|
||||
Go语言里Map的遍历是**完全随机**的,并没有固定的顺序。map每次遍历,都会从一个随机值序号的桶,在每个桶中,再从按照之前选定随机槽位开始遍历,所以是无序的。
|
||||
### Q2-Q3:Map 遍历为什么是无序的? 🟢简单
|
||||
|
||||
## 3. Go语言Map的遍历为什么要设计成无序的?
|
||||
## 参考答案
|
||||
|
||||
map 在扩容后,会发生 key 的搬迁,原来落在同一个 bucket 中的 key,搬迁后,有些 key 就要远走高飞了(bucket 序号加上了 2^B)。而遍历的过程,就是按顺序遍历 bucket,同时按顺序遍历 bucket 中的 key。搬迁后,key 的位置发生了重大的变化,有些 key 飞上高枝,有些 key 则原地不动。这样,遍历 map 的结果就不可能按原来的顺序了。
|
||||
Go Map 遍历时会选择一个**随机起始桶**和**随机起始槽位**开始遍历,因此每次遍历的顺序都不同。
|
||||
|
||||
Go团队为了避免开发者写出依赖底层实现细节的脆弱代码,而**有意为之**的一个设计。通过在遍历时引入随机数,Go从根本上杜绝了程序员依赖特定遍历顺序的可能性,强制我们写出更健壮的代码。
|
||||
**设计原因**:Go 团队**有意为之**——避免开发者写出依赖特定遍历顺序的脆弱代码,强制写出更健壮的代码。
|
||||
|
||||
## 4. Map如何实现顺序读取?
|
||||
|
||||
如果业务上确实需要有序遍历,最规范的做法就是将Map的键(Key)取出来放入一个切片(Slice)中,用`sort`包对切片进行排序,然后根据这个有序的切片去遍历Map。
|
||||
> [!tip] 💡 面试技巧
|
||||
> 如果面试官问"如何有序遍历 Map",回答:"将 key 取出放入 slice,用 sort 排序后再按序读取。"并给出示例代码。
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sort"
|
||||
)
|
||||
|
||||
func main() {
|
||||
keyList := make([]int, 0)
|
||||
m := map[int]int{
|
||||
3: 200,
|
||||
4: 200,
|
||||
1: 100,
|
||||
8: 800,
|
||||
5: 500,
|
||||
2: 200,
|
||||
}
|
||||
for key := range m {
|
||||
keyList = append(keyList, key)
|
||||
}
|
||||
sort.Ints(keyList)
|
||||
for _, key := range keyList {
|
||||
fmt.Println(key, m[key])
|
||||
}
|
||||
}
|
||||
// 有序遍历 Map
|
||||
keys := make([]int, 0, len(m))
|
||||
for k := range m { keys = append(keys, k) }
|
||||
sort.Ints(keys)
|
||||
for _, k := range keys { fmt.Println(k, m[k]) }
|
||||
```
|
||||
|
||||
## 5. Go语言的Map是否是并发安全的?
|
||||
---
|
||||
|
||||
map 不是线程安全的。
|
||||
### Q4:Map 是否线程安全? 🟢简单
|
||||
|
||||
在查找、赋值、遍历、删除的过程中都会检测写标志,一旦发现写标志置位(等于1),则直接 panic。赋值和删除函数在检测完写标志是复位之后,先将写标志位置位,才会进行之后的操作。
|
||||
## 参考答案
|
||||
|
||||
检测写标志:
|
||||
**不安全。** concurrent read + write 会导致 panic。
|
||||
|
||||
```go
|
||||
if h.flags&hashWriting == 0 {
|
||||
throw("concurrent map writes")
|
||||
}
|
||||
```
|
||||
|
||||
设置写标志:
|
||||
|
||||
```go
|
||||
h.flags |= hashWriting
|
||||
```
|
||||
|
||||
## 6. Map的Key一定要是可比较的吗?为什么?
|
||||
|
||||
Map的Key必须要可比较。
|
||||
|
||||
首先,Map会对我们提供的Key进行哈希运算,得到一个哈希值。这个哈希值决定了这个键值对大概存储在哪个位置(也就是哪个“桶”里)。然而,不同的Key可能会产生相同的哈希值,这就是“哈希冲突”。当多个Key被定位到同一个“桶”里时,Map就没法只靠哈希值来区分它们了。此时,它必须在桶内进行逐个遍历,用我们传入的Key和桶里已有的每一个Key进行\*\*相等(==)\*\*比较。这样才能确保我们操作的是正确的键值对。
|
||||
|
||||
## 7. Go语言Map的扩容时机是怎样的?
|
||||
|
||||
向 map 插入新 key 的时候,会进行条件检测,符合下面这 2 个条件,就会触发扩容
|
||||
|
||||
1. 装载因子超过阈值,源码里定义的阈值是 6.5,这个时候会触发双倍扩容
|
||||
|
||||
2. overflow 的 bucket 数量过多:
|
||||
|
||||
1. 当 B 小于 15,也就是 bucket 总数 2^B 小于 2^15 时,如果 overflow 的 bucket 数量超过 2^B;
|
||||
|
||||
2. 当 B >= 15,也就是 bucket 总数 2^B 大于等于 2^15,如果 overflow 的 bucket 数量超过 2^15
|
||||
|
||||
这两种情况下会触发双倍扩容
|
||||
|
||||
## 8. Go语言Map的扩容过程是怎样的?
|
||||
|
||||
Go的扩容是**渐进式(gradual**)的。它不会在触发扩容时“stop the world”来一次性把所有数据搬迁到新空间,而是只分配新空间,然后在后续的每一次插入、修改或删除操作时,才会顺便搬迁一两个旧桶的数据。这种设计将庞大的扩容成本分摊到了多次操作中,极大地减少了服务的瞬间延迟(STW),保证了性能的平滑性。
|
||||
|
||||
如果是触发双倍扩容,会新建一个buckets数组,新的buckets数量大小是原来的2倍,然后旧buckets数据搬迁到新的buckets。如果是等量扩容,buckets数量维持不变,重新做一遍类似双倍扩容的搬迁动作,把松散的键值对重新排列一次,使得同一个 bucket 中的 key 排列地更紧密,这样节省空间,存取效率更高
|
||||
|
||||
## 9. 可以对Map的元素取地址吗?
|
||||
|
||||
无法对 map 的 key 或 value 进行取址。会发生编译报错,这样设计主要是因为map一旦发生扩容,key 和 value 的位置就会改变,之前保存的地址也就失效了。
|
||||
|
||||
示例:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import "fmt"
|
||||
|
||||
func main() {
|
||||
m := make(map[string]int)
|
||||
|
||||
fmt.Println(&m["qcrao"])
|
||||
throw("concurrent map writes") // 检测到并发写就 panic
|
||||
}
|
||||
h.flags |= hashWriting // 设置写标志
|
||||
```
|
||||
|
||||
会出现编译报错:
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> **多个 goroutine 同时读同一个 map 是安全的**,但"读+写"或"写+写"都会 panic。如果需要并发读写,使用 `sync.Map` 或加 `RWMutex`。
|
||||
|
||||
```go
|
||||
./main.go:8:14: cannot take the address of m["qcrao"]
|
||||
```
|
||||
---
|
||||
|
||||
## 10. Map 中删除一个 key,它的内存会释放么?
|
||||
### Q5:Map 的 Key 一定要可比较吗?为什么? 🟢简单
|
||||
|
||||
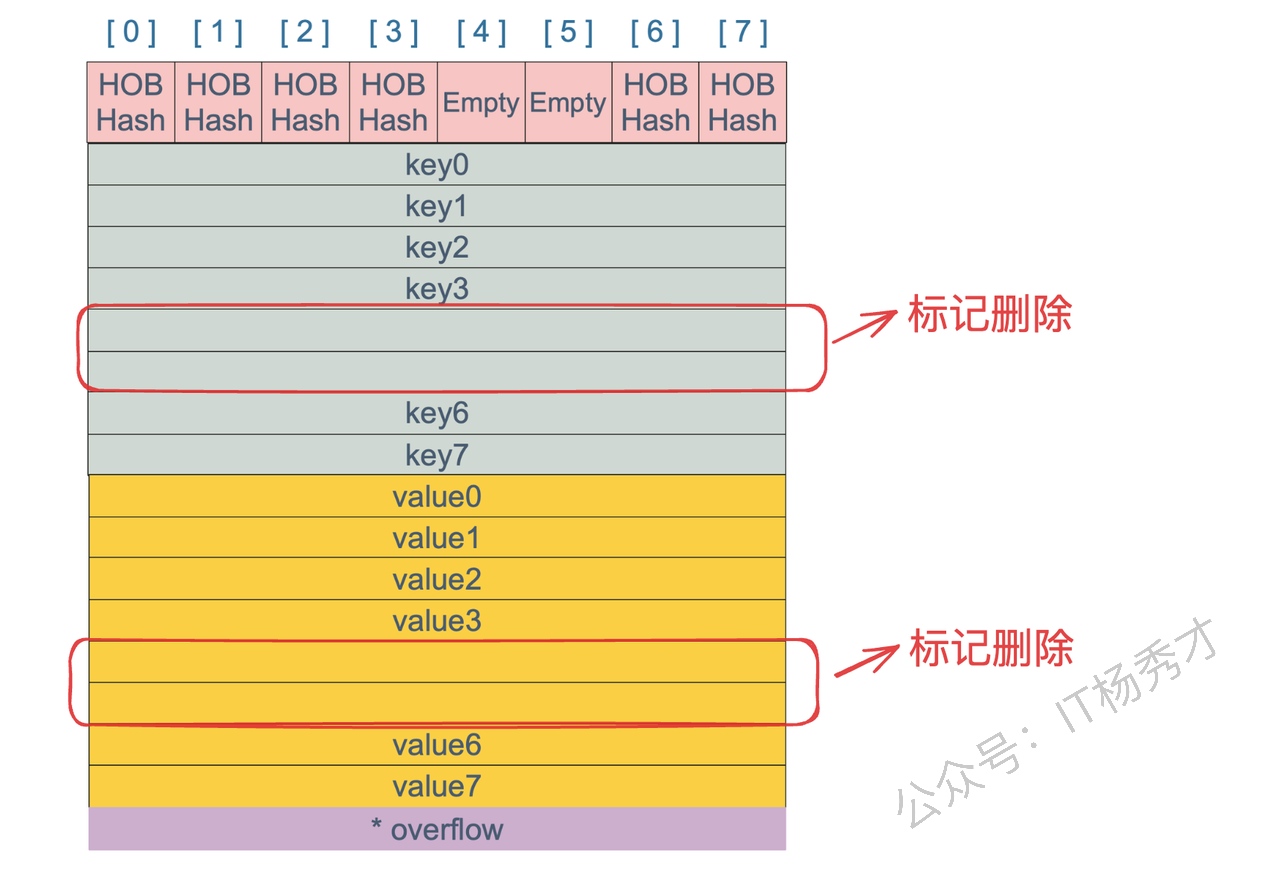
不会,`delete`一个key,并不会立刻释放或收缩Map占用的内存。具体来说,`delete(m, key)` 这个操作,只是把key和value对应的内存块标记为“空闲”,让它们的内容可以被后续的垃圾回收(GC)处理掉。但是,Map底层为了存储这些键值对而分配的“桶”(buckets)数组,它的规模是不会缩小的。只有在置空这个map的时候,整个map的空间才会被垃圾回后释放
|
||||
## 参考答案
|
||||
|
||||
|
||||
**必须可比较。** 原因有二:
|
||||
|
||||
## 11. Map可以边遍历边删除吗
|
||||
1. **哈希运算**:Key 需要被哈希以确定存储在哪个桶
|
||||
2. **冲突解决**:同一桶内可能存在多个 key,需要通过 `==` 逐个比较找到目标 key
|
||||
|
||||
map 并不是一个线程安全的数据结构。如果多个线程边遍历,边删除,同时读写一个 map 是未定义的行为,如果被检测到,会直接 panic。
|
||||
> [!note] 📝 核心考点
|
||||
> slice、map、function 类型**不能作为 Map 的 Key**,因为它们不可比较。
|
||||
|
||||
如果是发生在多个协程同时读写同一个 map 的情况下。 如果在同一个协程内边遍历边删除,并不会检测到同时读写,理论上是可以这样做的。但是,遍历的结果就可能不会是相同的了,有可能结果遍历结果集中包含了删除的 key,也有可能不包含,这取决于删除 key 的时间:是在遍历到 key 所在的 bucket 时刻前或者后。这种情况下,可以通过加读写锁sync.RWMutex来保证
|
||||
---
|
||||
|
||||
### Q6:Map 的扩容时机? 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
向 Map 插入新 key 时触发以下任一条件即扩容:
|
||||
|
||||
| 条件 | 说明 |
|
||||
|------|------|
|
||||
| 装载因子 > 6.5 | 源码阈值,触发双倍扩容 |
|
||||
| overflow 过多(B < 15) | overflow 数量 > 2^B |
|
||||
| overflow 过多(B >= 15) | overflow 数量 > 2^15 |
|
||||
|
||||
> [!info] 🔗 延伸阅读
|
||||
> - [[hzh/GolangStar/Go语言原理/map原理]] — 渐进式扩容的详细流程分析
|
||||
|
||||
---
|
||||
|
||||
### Q7:Map 的扩容过程是怎样的? 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
Go Map 采用**渐进式扩容**,不会 STW 一次性搬迁:
|
||||
|
||||
1. 分配新的 buckets 数组(双倍大小)
|
||||
2. 在后续每次**插入/修改/删除**操作时,顺便搬迁一两个旧桶的数据
|
||||
3. `oldbuckets` 指向旧数组,`nevacuate` 记录已搬迁进度
|
||||
|
||||
> [!tip] 💡 面试技巧
|
||||
> 强调"渐进式"三个字。面试官最想知道的是:Go 如何在不停止用户代码的情况下完成大规模数据搬迁。
|
||||
|
||||
---
|
||||
|
||||
### Q8:可以对 Map 的元素取地址吗? 🟢简单
|
||||
|
||||
## 参考答案
|
||||
|
||||
**不能。** 编译报错:`cannot take the address of m["key"]`
|
||||
|
||||
**原因**:Map 扩容时 key/value 的位置会改变,之前保存的地址就会失效。
|
||||
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> 如果你需要在 Map 中存储可变数据,可以存指针:`map[string]*MyStruct`,这样即使 Map 扩容,指针本身仍然有效。
|
||||
|
||||
---
|
||||
|
||||
### Q9:Map 删除 key 后内存会释放吗? 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
**不会立即释放。** `delete(m, key)` 只是将对应内存块标记为"空闲",允许后续写入复用,但桶数组规模不会缩小。只有将 Map 置空时,整个空间才会被 GC 回收。
|
||||
|
||||
> [!tip] 💡 面试技巧
|
||||
> 如果面试官问"如何真正释放 Map 内存",回答:"`m = make(map[K]V)` 创建新 Map,旧 Map 被 GC 回收。"
|
||||
|
||||
---
|
||||
|
||||
### Q10:Map 可以边遍历边删除吗? 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
| 场景 | 能否边遍历边删除 | 说明 |
|
||||
|------|----------------|------|
|
||||
| 单协程 | **可以** | 理论上可行,但遍历结果不确定 |
|
||||
| 多协程 | **不行** | 会 panic(concurrent map writes) |
|
||||
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> 即使是单协程,边遍历边删除的结果也不确定——取决于删除发生在遍历到该 bucket 之前还是之后。如需确定性行为,建议收集待删除的 key 后再批量删除。
|
||||
|
||||
## 关联笔记
|
||||
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言Map]]
|
||||
- [[hzh/GolangStar/Go语言原理/map原理]]
|
||||
- [[hzh/GolangStar/Go面试题库/Sync面试题]]
|
||||
|
||||
Reference in New Issue
Block a user