vault backup: 2026-06-07 12:14:39
This commit is contained in:

+292
-327
@@ -1,459 +1,424 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go语言基础
|
||||
- 面试题
|
||||
- 基础面试题
|
||||
tags: [go, golang, interview, basic-questions]
|
||||
create time: 2026-06-07 14:30
|
||||
---
|
||||
|
||||
# 基础面试题
|
||||
# 基础面试题 🧱
|
||||
|
||||
## 1. 与其他语言相比,使用 Go 有什么好处?
|
||||
## 概述
|
||||
|
||||
* 与其他语言不同,Go 代码的设计是务实的,Go的语法更简洁。每个功能和语法决策都旨在让程序员的开发效率更高
|
||||
本文件涵盖 Go 语言基础语法的 22 道高频面试题,包括变量、类型、控制流、内存分配等核心概念。每道题都附有思考引导和面试答题技巧。
|
||||
|
||||
* Golang 针对并发进行了优化,支持协程,并且实现了高效的GMP调度模型。
|
||||
> [!tip] 💡 使用建议
|
||||
> 先遮住答案自己思考,再对照解析学习。遇到不确定的题目,标记后在对应原理篇中寻找更深入的解释。
|
||||
|
||||
* 由于单一的标准代码格式,Golang 通常被认为比其他语言更具可读性。
|
||||
## 关联笔记
|
||||
|
||||
* 有高效的垃圾回收机制,支持并行垃圾回收,垃圾回收效率比比 Java 或 Python 更高
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言变量]] — 变量声明与零值
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言指针]] — new/make 区别
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言defer]] — defer 执行顺序
|
||||
- [[hzh/GolangStar/Go语言进阶/反射]] — 反射机制
|
||||
- [[hzh/GolangStar/Go语言原理/逃逸分析]] — 栈 vs 堆分配
|
||||
|
||||
## 2. 什么是协程?
|
||||
## 正文
|
||||
|
||||
协程是用户态轻量级线程,它是线程调度的基本单位。通常在函数前加上go关键字就能实现并发。一个Goroutine会以一个很小的栈启动2KB或4KB,当遇到栈空间不足时,栈会自动伸缩, 因此可以轻易实现成千上万个goroutine同时启动。
|
||||
### Q1:与其他语言相比,使用 Go 有什么好处? 🟢简单
|
||||
|
||||
## 3. 协程和线程和进程的区别?
|
||||
> [!question] ❓ 思考一下
|
||||
> 如果让你向面试官介绍 Go 的四大优势,你会怎么组织语言?试着用自己的话概括。
|
||||
|
||||
* 进程:进程是具有一定独立功能的程序,进程是系统资源分配和调度的最小单位。 每个进程都有自己的独立内存空间,不同进程通过进程间通信来通信。由于进程比较重量,占据独立的内存,所以上下文进程间的切换开销(栈、寄存器、虚拟内存、文件句柄等)比较大,但相对比较稳定安全。
|
||||
## 参考答案
|
||||
|
||||
* 线程:线程是进程的一个实体,线程是内核态,而且是 CPU 调度和分派的基本单位,它是比进程更小的能独立运行的基本单位。线程间通信主要通过共享内存,上下文切换很快,资源开销较少,但相比进程不够稳定容易丢失数据。
|
||||
1. **语法简洁务实**:每个功能设计都以提升开发效率为目标
|
||||
2. **原生并发支持**:Goroutine + Channel 实现高效的 GMP 调度模型
|
||||
3. **代码风格统一**:单一标准格式(`gofmt`),可读性高
|
||||
4. **高效垃圾回收**:支持并行 GC,效率优于 Java 或 Python
|
||||
|
||||
* 协程:协程是一种用户态的轻量级线程,协程的调度完全是由用户来控制的。协程拥有自己的寄存器上下文和栈。 协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈,直接操作栈则基本没有内核切换的开销,可以不加锁的访问全局变量,所以上下文的切换非常快。
|
||||
> [!tip] 💡 面试技巧
|
||||
> 回答时按照"语法 -> 并发 -> 工具链 -> 运行时"的逻辑展开,显得条理清晰。如果能提到"Go 的设计哲学是少即是多(less is more)",会给面试官留下深刻印象。
|
||||
|
||||
## 4. Golang 中 make 和 new 的区别?
|
||||
> [!note] 📝 核心考点
|
||||
> Go 的核心竞争力在于:**简洁语法 + 原生并发 + 快速编译 + 高效 GC**。面试官希望确认你理解 Go 的设计哲学,而非死记硬背特性。
|
||||
|
||||
**回答:**
|
||||
---
|
||||
|
||||
`make` 和 `new` 都是用于内存分配的内建函数,但它们的使用场景和功能有所不同:
|
||||
### Q2:什么是协程? 🟢简单
|
||||
|
||||
1. **`make`**:
|
||||
## 参考答案
|
||||
|
||||
* 用于初始化并分配内存,只能用于创建 `slice`、`map` 和 `channel` 三种类型。
|
||||
协程是**用户态轻量级线程**,是线程调度的基本单位。通常在函数前加上 `go` 关键字即可实现并发。一个 Goroutine 以极小的栈启动(2KB 或 4KB),栈空间不足时自动伸缩,因此可以轻松启动成千上万个 Goroutine。
|
||||
|
||||
* 返回的是初始化后的数据结构,而不是指针。
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> Goroutine 不是操作系统线程!它是用户态线程,由 Go 运行时(runtime)调度,而不是由操作系统内核调度。这是 Goroutine 轻量级的根本原因。
|
||||
|
||||
2. **`new`**:
|
||||
> [!info] 🔗 延伸阅读
|
||||
> - [[hzh/GolangStar/Go语言进阶/Goroutine]] — Goroutine 详细讲解
|
||||
> - [[hzh/GolangStar/Go语言原理/gmp调度原理]] — GMP 调度模型
|
||||
|
||||
* 用于分配内存,但不初始化,返回的是指向该内存的指针。
|
||||
---
|
||||
|
||||
* 可以用于任何类型的内存分配。
|
||||
### Q3:协程和线程、进程的区别? 🟢简单
|
||||
|
||||
**分析:**
|
||||
## 参考答案
|
||||
|
||||
| 维度 | 进程 | 线程 | 协程(Goroutine) |
|
||||
|------|------|------|------------------|
|
||||
| 调度单位 | 系统资源分配最小单位 | CPU 调度基本单位 | 用户态调度 |
|
||||
| 内存空间 | 独立内存空间 | 共享所属进程内存 | 独立栈,共享堆 |
|
||||
| 切换开销 | 大(上下文复杂) | 中等(内核态切换) | 极小(用户态切换) |
|
||||
| 通信方式 | IPC(管道/消息队列等) | 共享内存 | Channel / 共享变量 |
|
||||
| 数量级 | 几十个 | 几百个 | 数十万到百万级 |
|
||||
|
||||
> [!tip] 💡 面试技巧
|
||||
> 可以用一句话总结:"进程重、线程中、协程轻。Go 用极小的栈空间(2KB)+ 用户态调度 = 海量并发。"
|
||||
|
||||
---
|
||||
|
||||
### Q4:Go 中 make 和 new 的区别? 🟢简单
|
||||
|
||||
> [!question] ❓ 思考一下
|
||||
> 如果你要创建一个长度为 5 的 slice,你会用 `make` 还是 `new`?为什么?
|
||||
|
||||
## 参考答案
|
||||
|
||||
`make` 和 `new` 都是内存分配的内建函数,但使用场景不同:
|
||||
|
||||
| | make | new |
|
||||
|--|------|-----|
|
||||
| 用途 | 初始化并分配内存 | 仅分配内存,不初始化 |
|
||||
| 适用类型 | 仅限 `slice`、`map`、`channel` | 任何类型 |
|
||||
| 返回值 | 初始化后的数据结构本身 | 指向零值的指针 |
|
||||
|
||||
```go
|
||||
// 使用 make 创建 slice
|
||||
s := make([]int, 5) // 创建一个长度为 5 的 slice
|
||||
fmt.Println(s) // 输出: [0 0 0 0 0]// 使用 new 创建 int 指针
|
||||
p := new(int) // 分配内存给 int 类型
|
||||
fmt.Println(*p) // 输出: 0 (初始值)
|
||||
// make:创建已初始化的 slice
|
||||
s := make([]int, 5) // [0 0 0 0 0]
|
||||
|
||||
// new:分配内存,返回 *int 指针
|
||||
p := new(int) // *p == 0
|
||||
```
|
||||
|
||||
`make` 函数创建的是数据结构(`slice`、`map`、`channel`)本身,且返回初始化后的值。而`new` 函数创建的是可以指向任意类型的指针,返回指向未初始化零值的内存地址。
|
||||
> [!note] 📝 核心考点
|
||||
> `make` 返回的是**初始化后的值**(非指针),`new` 返回的是**指向零值的指针**。这是面试中最常混淆的点之一。
|
||||
|
||||
## 5. Golang 中数组和切片的区别?
|
||||
---
|
||||
|
||||
**数组: **
|
||||
### Q5:Go 中数组和切片的区别? 🟡中等
|
||||
|
||||
数组固定长度。数组长度是数组类型的一部分,所以\[3]int 和\[4]int 是两种不 同的数组类型数组需要指定大小,不指定也会根据初始化,自动推算出大小, 大小不可改变。数组是通过值传递的
|
||||
**切片: **
|
||||
## 参考答案
|
||||
|
||||
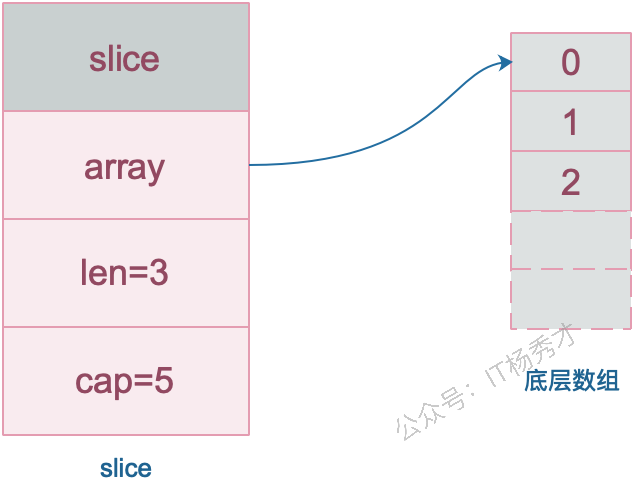
切片可以改变长度。切片是轻量级的数据结构,三个属性,指针,长度,容量 不需要指定大小切片是地址传递(引用传递)可以通过数组来初始化,也可以通过内置函数 make()来初始化,初始化的时候 len=cap,然后进行扩容 
|
||||
|
||||
**分析:**
|
||||
|
||||
slice 的底层数据其实也是数组,slice 是对数组的封装,它描述一个数组的片段。slice 实际上是一个结构体,包含三个字段:长度、容量、底层数组。
|
||||
| | 数组 | 切片(Slice) |
|
||||
|--|------|-------------|
|
||||
| 长度 | 固定,是类型的一部分 | 可变长 |
|
||||
| 传递方式 | 值传递 | 引用传递(地址传递) |
|
||||
| 底层结构 | 连续内存块 | array 指针 + len + cap |
|
||||
| 初始化 | 必须指定大小或推断 | 可用 `make()` 或数组截取 |
|
||||
|
||||
```go
|
||||
// runtime/slice.go
|
||||
type slice struct {
|
||||
array unsafe.Pointer // 元素指针
|
||||
len int // 长度
|
||||
cap int // 容量
|
||||
array unsafe.Pointer // 元素指针
|
||||
len int // 长度
|
||||
cap int // 容量
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> `[3]int` 和 `[4]int` 是两种不同的类型!因为数组的长度是类型的一部分。这意味着你不能将 `[3]int` 赋值给 `[4]int`。
|
||||
|
||||
---
|
||||
|
||||
## 6. 使用for range 的时候,它的地址会发生变化吗?
|
||||
### Q6:for range 迭代变量的地址会变化吗? 🟡中等
|
||||
|
||||
在Go1.22之前,对于 `for range` 循环中的迭代变量,其内存地址是不会发生变化的。但是,Go1.22之后的地址是临时的,是变化的,不一样的,不再是共享内存了
|
||||
> [!question] ❓ 思考一下
|
||||
> 在 for range 循环中取迭代变量的地址,存入 slice 后遍历,Go 1.22 前后行为会有什么不同?
|
||||
|
||||
**分析:**
|
||||
## 参考答案
|
||||
|
||||
Go1.22之前:
|
||||
| Go 版本 | 行为 | 说明 |
|
||||
|---------|------|------|
|
||||
| Go 1.22 之前 | 地址不变 | 每次迭代复用同一块内存 |
|
||||
| Go 1.22 及之后 | 地址变化 | 每次迭代生成新的迭代变量 |
|
||||
|
||||
```go
|
||||
// Go 1.22 之前:所有元素的地址相同
|
||||
// Go 1.22 及之后:每个元素的地址不同
|
||||
for index, value := range collection {
|
||||
// ...
|
||||
_ = &value // 地址行为因版本而异
|
||||
}
|
||||
```
|
||||
|
||||
这里 `value` 是一个**副本**。在每次迭代中,`collection` 中的当前元素值会被**复制**到 `value` 这个变量中。Go 编译器通常会为 `value` 分配一块固定的内存地址,然后在每次迭代时,将当前元素的值覆盖到这块内存中。所以,当你打印 `&value` 时,你会发现它的内存地址在整个循环过程中都是保持不变的。
|
||||
> [!info] 🔗 延伸阅读
|
||||
> Go 1.22 改变了 for range 的语义,使迭代变量每次迭代都有独立的内存地址,避免了经典的"闭包捕获同一变量"陷阱。
|
||||
|
||||
但是在Go1.23及以后,使用 `for range` 遍历一个集合时,**迭代变量的地址会发生变化**。这是因为 `for range` 每次迭代时都会重新生成迭代变量(如 `value`),这些变量在内存中是不同的地址
|
||||
---
|
||||
|
||||
## 7. 如何高效地拼接字符串?
|
||||
### Q7:如何高效地拼接字符串? 🟡中等
|
||||
|
||||
拼接字符串的方式有:`+` , `fmt.Sprintf` , [`strings.Builder`](https://zhida.zhihu.com/search?content_id=192906787\&content_type=Article\&match_order=1\&q=strings.Builder\&zhida_source=entity), [`bytes.Buffer`](https://zhida.zhihu.com/search?content_id=192906787\&content_type=Article\&match_order=1\&q=bytes.Buffer\&zhida_source=entity), `strings.Join`
|
||||
> [!question] ❓ 思考一下
|
||||
> 如果要拼接 10000 个字符串,你会选择哪种方法?为什么不用 `+`?
|
||||
|
||||
1.  "+"
|
||||
## 参考答案
|
||||
|
||||
使用`+`操作符进行拼接时,会对字符串进行遍历,计算并开辟一个新的空间来存储原来的两个字符串。
|
||||
**性能排序**:`strings.Join ≈ strings.Builder > bytes.Buffer > "+" > fmt.Sprintf`
|
||||
|
||||
2.  fmt.Sprintf
|
||||
|
||||
由于采用了接口参数,必须要用反射获取值,因此有性能损耗。
|
||||
|
||||
3. strings.Builder:
|
||||
|
||||
用WriteString()进行拼接,内部实现是指针+切片,同时String()返回拼接后的字符串,它是直接把\[]byte转换为string,从而避免变量拷贝。
|
||||
|
||||
4. bytes.Buffer
|
||||
|
||||
`bytes.Buffer`是一个一个缓冲`byte`类型的缓冲器,这个缓冲器里存放着都是`byte`,
|
||||
|
||||
`bytes.buffer`底层也是一个`[]byte`切片。
|
||||
|
||||
5. strings.join
|
||||
|
||||
`strings.join`也是基于`strings.builder`来实现的,并且可以自定义分隔符,在join方法内调用了b.Grow(n)方法,这个是进行初步的容量分配,而前面计算的n的长度就是我们要拼接的slice的长度,因为我们传入切片长度固定,所以提前进行容量分配可以减少内存分配,很高效。
|
||||
|
||||
**性能比较:**
|
||||
|
||||
strings.Join ≈ strings.Builder > bytes.Buffer > "+" > fmt.Sprintf
|
||||
|
||||
5种拼接方法的实例代码
|
||||
| 方法 | 特点 | 适用场景 |
|
||||
|------|------|---------|
|
||||
| `+` | 每次拼接都遍历+开辟新空间 | 少量字符串拼接 |
|
||||
| `fmt.Sprintf` | 需要反射,有性能损耗 | 需要格式化的场景 |
|
||||
| `strings.Builder` | 指针+切片,避免拷贝 | **大量字符串拼接推荐** |
|
||||
| `bytes.Buffer` | 缓冲 byte 类型数据 | 字节级别操作 |
|
||||
| `strings.Join` | 基于 Builder,可自定义分隔符 | 已知切片长度的场景 |
|
||||
|
||||
```go
|
||||
func main(){
|
||||
a := []string{"a", "b", "c"}
|
||||
//方式1:+
|
||||
ret := a[0] + a[1] + a[2]
|
||||
//方式2:fmt.Sprintf
|
||||
ret := fmt.Sprintf("%s%s%s", a[0],a[1],a[2])
|
||||
//方式3:strings.Builder
|
||||
var sb strings.Builder
|
||||
sb.WriteString(a[0])
|
||||
sb.WriteString(a[1])
|
||||
sb.WriteString(a[2])
|
||||
ret := sb.String()
|
||||
//方式4:bytes.Buffer
|
||||
buf := new(bytes.Buffer)
|
||||
buf.Write(a[0])
|
||||
buf.Write(a[1])
|
||||
buf.Write(a[2])
|
||||
ret := buf.String()
|
||||
//方式5:strings.Join
|
||||
ret := strings.Join(a,"")
|
||||
a := []string{"a", "b", "c"}
|
||||
|
||||
// 推荐:strings.Join(已知长度,预分配容量)
|
||||
ret := strings.Join(a, "")
|
||||
|
||||
// 推荐:strings.Builder(未知长度)
|
||||
var sb strings.Builder
|
||||
for _, s := range a {
|
||||
sb.WriteString(s)
|
||||
}
|
||||
ret := sb.String()
|
||||
```
|
||||
|
||||
## 8. defer 的执行顺序是怎样的?defer 的作用或者使用场景是什么? 
|
||||
> [!tip] 💡 面试技巧
|
||||
> 如果面试官追问"strings.Join 为什么比 + 快",可以回答:"Join 提前计算总长度并一次性分配内存,而 + 每次都要重新分配。"
|
||||
|
||||
defer执行顺序和调用顺序相反,类似于栈后进先出(LIFO)
|
||||
---
|
||||
|
||||
defer 的作用是:当 defer 语句被执行时,跟在 defer 后面的函数会被延迟执行。直到 包含该 defer 语句的函数执行完毕时,defer 后的函数才会被执行,不论包含 defer 语句的函数是通过 return 正常结束,还是由于 panic 导致的异常结束。 你可以在一个函数中执行多条 defer 语句,它们的执行顺序与声明顺序相反。 
|
||||
### Q8:defer 的执行顺序和使用场景? 🟡中等
|
||||
|
||||
defer 的常用场景: 
|
||||
> [!question] ❓ 思考一下
|
||||
> 如果有 3 条 defer 语句,它们以什么顺序执行?有名返回值和匿名返回值对 defer 有什么影响?
|
||||
|
||||
* defer语句经常被用于处理成对的操作,如打开、关闭、连接、断开连接、 加锁、释放锁。 
|
||||
## 参考答案
|
||||
|
||||
* 通过defer机制,不论函数逻辑多复杂,都能保证在任何执行路径下,资 源被释放。 
|
||||
|
||||
* 释放资源的defer应该直接跟在请求资源的语句后。 
|
||||
|
||||
**分析:**
|
||||
**执行顺序**:后进先出(LIFO),与声明顺序相反。
|
||||
|
||||
```go
|
||||
func test() int {
|
||||
i := 0
|
||||
defer func() {
|
||||
fmt.Println("defer1")
|
||||
}()
|
||||
defer func() {
|
||||
i += 1
|
||||
fmt.Println("defer2")
|
||||
}()
|
||||
return i
|
||||
i := 0
|
||||
defer func() { fmt.Println("defer1") }() // 最后执行
|
||||
defer func() { i += 1; fmt.Println("defer2") }() // 最先执行
|
||||
return i
|
||||
}
|
||||
|
||||
func main() {
|
||||
fmt.Println("return", test())
|
||||
}
|
||||
|
||||
// 输出:
|
||||
// defer2
|
||||
// defer1
|
||||
// return 0
|
||||
// 输出:defer2 → defer1 → return 0
|
||||
```
|
||||
|
||||
上面这个例子中,test返回值并没有修改,这是由于Go的返回机制决定的,执行Return语句后,Go会创建一个临时变量保存返回值。如果是有名返回(也就是指明返回值`func test() (i int)`)
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> **有名返回值 vs 匿名返回值**:
|
||||
> - 匿名返回值:return 创建临时变量保存结果,defer 修改不影响返回值
|
||||
> - 有名返回值:return 直接写入命名变量,defer 可以修改返回值
|
||||
|
||||
```go
|
||||
func test() (i int) {
|
||||
i = 0
|
||||
defer func() {
|
||||
i += 1
|
||||
fmt.Println("defer2")
|
||||
}()
|
||||
return i
|
||||
func test() (i int) { // 有名返回值
|
||||
i = 0
|
||||
defer func() { i += 1 }()
|
||||
return i // 实际返回 1
|
||||
}
|
||||
|
||||
func main() {
|
||||
fmt.Println("return", test())
|
||||
}
|
||||
// 输出:
|
||||
// defer2
|
||||
// return 1
|
||||
|
||||
```
|
||||
|
||||
这个例子中,返回值被修改了。对于有名返回值的函数,执行 return 语句时,并不会再创建临时变量保存,因此,defer 语句修改了 i,即对返回值产生了影响。
|
||||
> [!note] 📝 核心考点
|
||||
> defer 的三个关键点:**LIFO 顺序**、**延迟计算**(参数在 defer 声明时就求值)、**有名返回值可被修改**。
|
||||
|
||||
## 9. 什么是 rune 类型?
|
||||
---
|
||||
|
||||
Go 语言的字符有以下两种:
|
||||
### Q9:什么是 rune 类型? 🟢简单
|
||||
|
||||
* uint8 类型,或者叫 byte 型,代表了 ASCII 码的一个字符。
|
||||
## 参考答案
|
||||
|
||||
* rune 类型,代表一个 UTF-8 字符,当需要处理中文、日文或者其他复合字符时,则需要用到 rune 类型。rune 类型等价于 int32 类型。
|
||||
Go 的字符有两种表示:
|
||||
|
||||
| 类型 | 别名 | 含义 | 字节数 |
|
||||
|------|------|------|--------|
|
||||
| `byte` | `uint8` | ASCII 码的一个字符 | 1 |
|
||||
| `rune` | `int32` | UTF-8 字符(Unicode) | 4 |
|
||||
|
||||
```go
|
||||
package main
|
||||
import "fmt"
|
||||
|
||||
func main() {
|
||||
var str = "hello 你好" //思考下 len(str) 的长度是多少?
|
||||
|
||||
//golang中string底层是通过byte数组实现的,直接求len 实际是在按字节长度计算
|
||||
//所以一个汉字占3个字节算了3个长度
|
||||
fmt.Println("len(str):", len(str)) // len(str): 12
|
||||
|
||||
//通过rune类型处理unicode字符
|
||||
fmt.Println("rune:", len([]rune(str))) //rune: 8
|
||||
}
|
||||
str := "hello 你好"
|
||||
fmt.Println(len(str)) // 12(按字节计算:7个英文+5个汉字×3)
|
||||
fmt.Println(len([]rune(str))) // 8(按字符计算)
|
||||
```
|
||||
|
||||
## 10. Go 语言 tag 有什么用?
|
||||
> [!tip] 💡 面试技巧
|
||||
> 记住关键数字:UTF-8 下一个汉字占 **3 个字节**,`len()` 按字节计算,要统计字符数需转为 `[]rune`。
|
||||
|
||||
tag可以为结构体成员提供属性。常见的:
|
||||
---
|
||||
|
||||
1. json序列化或反序列化时字段的名称
|
||||
### Q10:Go 语言 tag 有什么用? 🟢简单
|
||||
|
||||
2. db: sqlx模块中对应的数据库字段名
|
||||
## 参考答案
|
||||
|
||||
3. form: gin框架中对应的前端的数据字段名
|
||||
tag 为结构体成员提供元数据属性,常见用途:
|
||||
|
||||
4. binding: 搭配 form 使用, 默认如果没查找到结构体中的某个字段则不报错值为空, binding为 required 代表没找到返回错误给前端
|
||||
| Tag | 作用 | 示例 |
|
||||
|-----|------|------|
|
||||
| `json` | JSON 序列化/反序列化字段名 | `` `json:"user_name"` `` |
|
||||
| `db` | SQLX 数据库字段名 | `` `db:"id"` `` |
|
||||
| `form` | Gin 框架前端字段映射 | `` `form:"username"` `` |
|
||||
| `binding` | 参数校验规则 | `` `binding:"required"` `` |
|
||||
|
||||
## 11. go 打印时 %v %+v %#v 的区别?
|
||||
---
|
||||
|
||||
* %v 只输出所有的值;
|
||||
### Q11:go 打印时 %v %+v %#v 的区别? 🟢简单
|
||||
|
||||
* %+v 先输出字段名字,再输出该字段的值;
|
||||
|
||||
* %#v 先输出结构体名字值,再输出结构体(字段名字+字段的值);
|
||||
## 参考答案
|
||||
|
||||
```go
|
||||
package main
|
||||
import "fmt"
|
||||
|
||||
type student struct {
|
||||
id int32
|
||||
name string
|
||||
}
|
||||
|
||||
func main() {
|
||||
a := &student{id: 1, name: "微客鸟窝"}
|
||||
type student struct { id int32; name string }
|
||||
a := &student{id: 1, name: "微客鸟窝"}
|
||||
|
||||
fmt.Printf("a=%v \n", a) // a=&{1 微客鸟窝}
|
||||
fmt.Printf("a=%+v \n", a) // a=&{id:1 name:微客鸟窝}
|
||||
fmt.Printf("a=%#v \n", a) // a=&main.student{id:1, name:"微客鸟窝"}
|
||||
}
|
||||
fmt.Printf("%v\n", a) // &{1 微客鸟窝} -- 只输出值
|
||||
fmt.Printf("%+v\n", a) // &{id:1 name:微客鸟窝} -- 显示字段名
|
||||
fmt.Printf("%#v\n", a) // &main.student{id:1,name:"微客鸟窝"} -- 完整类型信息
|
||||
```
|
||||
|
||||
## 12. Go语言中空 struct{} 占用空间么?
|
||||
---
|
||||
|
||||
可以使用 unsafe.Sizeof 计算出一个数据类型实例需要占用的字节数,空struct{}不占用任何空间
|
||||
### Q12-13:空 struct{} 的空间占用和用途 🟢简单
|
||||
|
||||
## 参考答案
|
||||
|
||||
空 struct 不占用任何空间:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"unsafe"
|
||||
)
|
||||
|
||||
func main() {
|
||||
fmt.Println(unsafe.Sizeof(struct{}{})) //0
|
||||
}
|
||||
unsafe.Sizeof(struct{}{}) // 输出: 0
|
||||
```
|
||||
|
||||
## 13. Go语言中,空 struct{} 有什么用?
|
||||
**三大用途:**
|
||||
1. **模拟 Set**:`map[string]struct{}` 代替 `map[string]bool`,节省内存
|
||||
2. **Channel 信号**:`chan struct{}` 仅用于通知,不传数据
|
||||
3. **仅有方法的类型**:如工具类 `type Logger struct{}`
|
||||
|
||||
* 用map模拟一个set,那么就要把值置为struct{},struct{}本身不占任何空间,可以避免任何多余的内存分配。
|
||||
---
|
||||
|
||||
```go
|
||||
type Set map[string]struct{}
|
||||
### Q14:init() 函数什么时候执行? 🟡中等
|
||||
|
||||
func main() {
|
||||
set := make(Set)
|
||||
> [!question] ❓ 思考一下
|
||||
> main 包可以有 init() 吗?多个包的 init() 执行顺序是什么?
|
||||
|
||||
for _, item := range []string{"A", "A", "B", "C"} {
|
||||
set[item] = struct{}{}
|
||||
}
|
||||
fmt.Println(len(set)) // 3
|
||||
if _, ok := set["A"]; ok {
|
||||
fmt.Println("A exists") // A exists
|
||||
}
|
||||
}
|
||||
```
|
||||
## 参考答案
|
||||
|
||||
* 有时候给通道发送一个空结构体,channel<-struct{}{},可以节省空间
|
||||
**执行顺序**:import -> const -> var -> `init()` -> `main()`
|
||||
|
||||
```go
|
||||
func main() {
|
||||
ch := make(chan struct{}, 1)
|
||||
go func() {
|
||||
<-ch
|
||||
// do something
|
||||
}()
|
||||
ch <- struct{}{}
|
||||
// ...
|
||||
}
|
||||
```
|
||||
1. 在 `main()` 之前执行
|
||||
2. 按依赖关系初始化(无依赖的最先初始化)
|
||||
3. 同一个包内可以有多个 `init()`,执行顺序**不保证**
|
||||
4. `init()` 无参数、无返回值、不能被调用
|
||||
|
||||
* 表示仅有方法的结构体
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> 不要在 `init()` 中做耗时操作或依赖外部服务!它应该在编译期就能确定执行逻辑。
|
||||
|
||||
```go
|
||||
type Lamp struct{}
|
||||
```
|
||||
---
|
||||
|
||||
## 14. init() 函数是什么时候执行的?
|
||||
### Q15-16:接口比较与 nil 问题 🟡中等
|
||||
|
||||
**简答:** 在main函数之前执行。
|
||||
## 参考答案
|
||||
|
||||
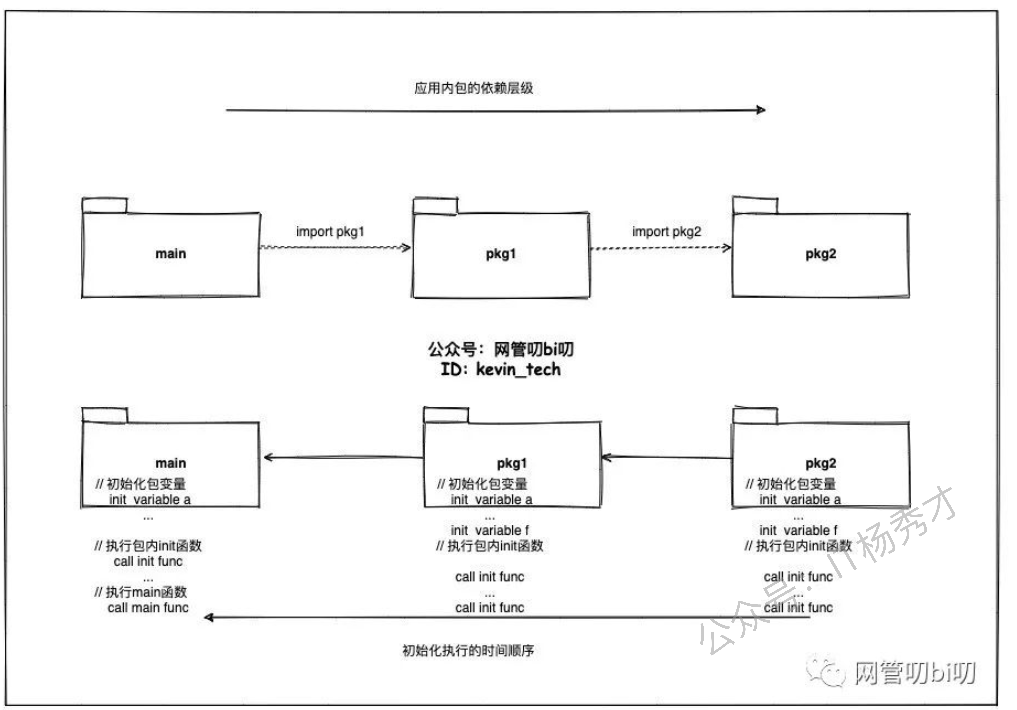
**详细:**init()函数是go初始化的一部分,由runtime初始化每个导入的包,初始化不是按照从上到下的导入顺序,而是按照解析的依赖关系,没有依赖的包最先初始化。
|
||||
**两个 interface 相等的条件:**
|
||||
1. 两者均为 nil
|
||||
2. 类型 T 相同且值 V 相等
|
||||
|
||||
每个包首先初始化包作用域的常量和变量(常量优先于变量),然后执行包的`init()`函数。同一个包,甚至是同一个源文件可以有多个`init()`函数。`init()`函数没有入参和返回值,不能被其他函数调用,同一个包内多个`init()`函数的执行顺序不作保证。
|
||||
|
||||
执行顺序:import –> const –> var –>`init()`–>`main()`
|
||||
|
||||
一个文件可以有多个`init()`函数!
|
||||
|
||||
|
||||
|
||||
## 15. 2 个 interface 可以比较吗 ?
|
||||
|
||||
Go 语言中,interface 的内部实现包含了 2 个字段,类型 `T` 和 值 `V`,interface 可以使用 `==` 或 `!=` 比较。2 个 interface 相等有以下 2 种情况
|
||||
|
||||
1. 两个 interface 均等于 nil(此时 V 和 T 都处于 unset 状态)
|
||||
|
||||
2. 类型 T 相同,且对应的值 V 相等。
|
||||
|
||||
```go
|
||||
type Stu struct {
|
||||
Name string
|
||||
}
|
||||
|
||||
type StuInt interface{}
|
||||
|
||||
func main() {
|
||||
var stu1, stu2 StuInt = &Stu{"Tom"}, &Stu{"Tom"}
|
||||
var stu3, stu4 StuInt = Stu{"Tom"}, Stu{"Tom"}
|
||||
fmt.Println(stu1 == stu2) // false
|
||||
fmt.Println(stu3 == stu4) // true
|
||||
}
|
||||
```
|
||||
|
||||
`stu1` 和 `stu2` 对应的类型是 `*Stu`,值是 Stu 结构体的地址,两个地址不同,因此结果为 false。
|
||||
`stu3` 和 `stu4` 对应的类型是 `Stu`,值是 Stu 结构体,且各字段相等,因此结果为 true。
|
||||
|
||||
## 16. 2 个 nil 可能不相等吗?
|
||||
|
||||
可能不等。interface在运行时绑定值,只有值为nil接口值才为nil,但是与指针的nil不相等。举个例子:
|
||||
**两个 nil 可能不相等!** 只有类型相同时才相等:
|
||||
|
||||
```go
|
||||
var p *int = nil
|
||||
var i interface{} = nil
|
||||
if(p == i){
|
||||
fmt.Println("Equal")
|
||||
}
|
||||
// p == i → false(*int != interface{})
|
||||
```
|
||||
|
||||
两者并不相同。总结:两个nil只有在类型相同时才相等。
|
||||
|
||||
## 17. Go 语言函数传参是值类型还是引用类型?
|
||||
|
||||
* 在 Go 语言中只存在值传递,要么是值的副本,要么是指针的副本。无论是值类型的变量还是引用类型的变量亦或是指针类型的变量作为参数传递都会发生值拷贝,开辟新的内存空间。
|
||||
|
||||
* 另外值传递、引用传递和值类型、引用类型是两个不同的概念,不要混淆了。引用类型作为变量传递可以影响到函数外部是因为发生值拷贝后新旧变量指向了相同的内存地址。
|
||||
|
||||
# 18. 如何知道一个对象是分配在栈上还是堆上?
|
||||
|
||||
Go和C++不同,Go局部变量会进行逃逸分析。如果变量离开作用域后没有被引用,则优先分配到栈上,否则分配到堆上。那么如何判断是否发生了逃逸呢?
|
||||
|
||||
`go build -gcflags '-m -m -l' xxx.go`.
|
||||
|
||||
关于逃逸的可能情况:变量大小不确定,变量类型不确定,变量分配的内存超过用户栈最大值,暴露给了外部指针。
|
||||
|
||||
## 19. Go语言的多返回值是如何实现的?
|
||||
|
||||
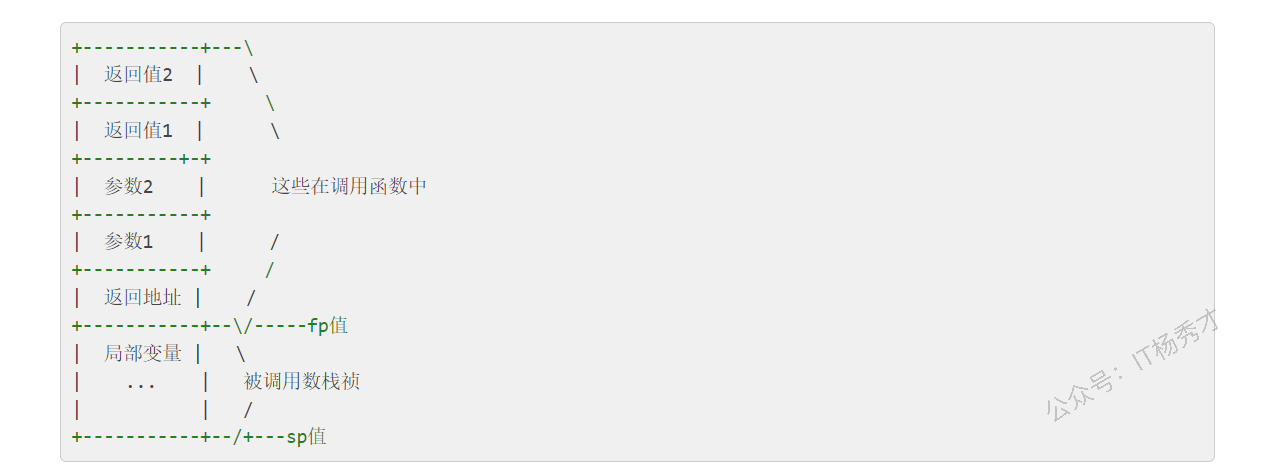
Go 语言的多返回值是通过在函数调用栈帧上预留空间并进行**值复制**来实现的。在函数调用发生时,Go 编译器会计算出函数所有返回值的总大小。在为该函数创建**栈帧**时,就会在调用方(caller)的栈帧上,为这些返回值预留出连续的内存空间。
|
||||
|
||||
当函数执行到 `return` 语句时,它会将其要返回的各个值**复制**到这些预留好的栈空间中。函数执行完毕后,控制权返回给调用方。此时,调用方可以直接从它自己的栈帧上(即之前为返回值预留的空间)获取这些返回的值。
|
||||
|
||||
|
||||
|
||||
## 20. Go语言中"\_"的作用
|
||||
|
||||
1. 忽略多返回值:在 Go 语言中,函数可以返回多个值。如果你只关心其中的一部分返回值,而不需要使用其余的,就可以用 `_` 来忽略它们,从而避免编译器报错
|
||||
|
||||
2. 当你导入一个包时,通常会使用它的某个功能。但有时你可能只想执行包的 `init()` 函数(例如,注册驱动、初始化全局变量等),而不需要直接使用包中的任何导出成员。这时,你就可以使用 `_` 来进行**匿名导入**
|
||||
|
||||
示例:
|
||||
**nil interface 的经典陷阱:**
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
_ "net/http/pprof" // 导入 pprof 包,只为了执行其 init 函数注册 profiling 接口
|
||||
)
|
||||
|
||||
func main() {
|
||||
fmt.Println("Application started. Profiling tools are likely registered.")
|
||||
// 实际应用中,你可能还会启动一个 HTTP 服务器来暴露 pprof 接口
|
||||
// go func() {
|
||||
// log.Println(http.ListenAndServe("localhost:6060", nil))
|
||||
// }()
|
||||
}
|
||||
var c Coder = (*Gopher)(nil) // 动态类型为 *Gopher,值为 nil
|
||||
c == nil // false!因为动态类型不为 nil
|
||||
```
|
||||
|
||||
## 21. Go语言普通指针和unsafe.Pointer有什么区别?
|
||||
> [!note] 📝 核心考点
|
||||
> interface == nil 的条件是**动态类型 AND 动态值都为 nil**,缺一不可。这是 Go 面试中出现频率最高的陷阱题之一。
|
||||
|
||||
普通指针比如`*int`、`*string`,它们有明确的类型信息,编译器会进行类型检查和垃圾回收跟踪。不同类型的指针之间不能直接转换,这是Go类型安全的体现。
|
||||
---
|
||||
|
||||
而**unsafe.Pointer**是Go的通用指针类型,可以理解为C语言中的`void*`,它绕过了Go的类型系统。unsafe.Pointer可以与任意类型的指针相互转换,也可以与uintptr进行转换来做指针运算。
|
||||
### Q17:Go 函数传参是值传递还是引用传递? 🟢简单
|
||||
|
||||
另外,通指针受GC管理和类型约束,unsafe.Pointer不受类型约束但仍受GC跟踪
|
||||
## 参考答案
|
||||
|
||||
## 22. unsafe.Pointer与uintptr有什么区别和联系
|
||||
**Go 只有值传递。** 无论是值类型、引用类型还是指针类型,传递的都是副本:
|
||||
|
||||
unsafe.Pointer和uintptr可以相互转换,这是Go提供的唯一合法的指针运算方式。典型用法是先将unsafe.Pointer转为uintptr做算术运算,然后再转回unsafe.Pointer使用。
|
||||
- 值类型:复制实际值
|
||||
- 引用类型(slice/map/chan):复制指向底层数据的指针
|
||||
- 指针类型:复制指针的值
|
||||
|
||||
最关键的区别在于**GC跟踪**。unsafe.Pointer会被垃圾回收器跟踪,它指向的内存不会被错误回收;而uintptr只是一个普通整数,GC完全不知道它指向什么,如果没有其他引用,对应内存可能随时被回收。
|
||||
> [!tip] 💡 面试技巧
|
||||
> "引用类型能修改外部数据不是因为引用传递,而是因为复制了指针,新旧变量指向同一块内存。"
|
||||
|
||||
所以记住:unsafe.Pointer有GC保护,uintptr没有,这是它们最本质的区别。
|
||||
---
|
||||
|
||||
### Q18:如何判断变量分配在栈上还是堆上? 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
通过**逃逸分析**判断:
|
||||
|
||||
```bash
|
||||
go build -gcflags '-m -m -l' xxx.go
|
||||
```
|
||||
|
||||
**逃逸场景:**
|
||||
- 返回局部变量指针
|
||||
- 传递给 `interface{}` 参数
|
||||
- 被闭包引用
|
||||
- 超过栈大小限制的大对象
|
||||
|
||||
---
|
||||
|
||||
### Q19:Go 多返回值如何实现? 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
Go 的多返回值通过在**调用方栈帧上预留空间**实现:
|
||||
|
||||
1. 编译器计算所有返回值的总大小
|
||||
2. 在 caller 的栈帧上预留连续空间
|
||||
3. callee 执行 return 时将值复制到预留空间
|
||||
4. caller 直接从自己的栈帧读取
|
||||
|
||||
> [!info] 🔗 延伸阅读
|
||||
> - [[hzh/GolangStar/Go语言原理/defer原理]] — defer 与有名返回值的交互
|
||||
> - [[hzh/GolangStar/Go面试题库/代码面试题]] — 多返回值实战
|
||||
|
||||
---
|
||||
|
||||
### Q20:Go 中 `_` 的作用 🟢简单
|
||||
|
||||
## 参考答案
|
||||
|
||||
1. **忽略返回值**:`x, _ := m["key"]`
|
||||
2. **匿名导入**:`_ "net/http/pprof"`(仅执行 init 注册 profiling)
|
||||
3. **忽略循环变量**:`for _, v := range slice`
|
||||
|
||||
---
|
||||
|
||||
### Q21-22:指针相关概念 🟡中等
|
||||
|
||||
## 参考答案
|
||||
|
||||
| 对比项 | 普通指针 (`*int`) | `unsafe.Pointer` | `uintptr` |
|
||||
|--------|------------------|-----------------|-----------|
|
||||
| 类型安全 | 是,受编译器检查 | 否,通用指针 | 是(整数类型) |
|
||||
| GC 跟踪 | 是 | 是 | **否** |
|
||||
| 指针运算 | 不支持 | 不支持 | 支持(需转回 Pointer) |
|
||||
| 类比 C | 强类型指针 | `void*` | 裸整数地址 |
|
||||
|
||||
> [!warning] ⚠️ 高频陷阱
|
||||
> `uintptr` 只是一个整数,GC 不知道它指向内存,对应内存可能被回收。`unsafe.Pointer` 受 GC 保护。这是最本质的区别。
|
||||
|
||||
## 关联笔记
|
||||
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言变量]]
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言指针]]
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言defer]]
|
||||
- [[hzh/GolangStar/Go语言进阶/反射]]
|
||||
- [[hzh/GolangStar/Go语言原理/逃逸分析]]
|
||||
|
||||
Reference in New Issue
Block a user