vault backup: 2026-06-07 12:14:39
This commit is contained in:

+151
-268
@@ -1,298 +1,181 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go原理深入
|
||||
- slice原理
|
||||
tags: [go, golang, go-principle, slice]
|
||||
create time: 2026-06-07 15:10
|
||||
---
|
||||
|
||||
# slice原理
|
||||
# Slice 底层原理
|
||||
|
||||
## slice是什么
|
||||
## 概述
|
||||
|
||||
go语言中slice可以理解为动态数组,区别于数组,其长度不是固定的,在使用时,我们不必担心其容量大小不够。当需要往切片追加元素时,如果切片容量大小不足,会自动扩容。基于其这个特性,我们在真正编程过程中,更多的会使用切片,而不是数组。
|
||||
本文从 runtime 源码角度深入解析 Go Slice 的三字段结构、扩容策略(含 1.18 版本变更),以及截取、复制、append 等操作背后的内存行为。Slice 是 Go 中最常用的数据结构之一,理解其底层机制能有效避免常见的"切片共享数组"陷阱。
|
||||
|
||||
在使用过程中,区别于数组,声明切片时,也只需要制定声明数据类型,而不需要指定大小
|
||||
|
||||
```go
|
||||
var arrs []int
|
||||
```
|
||||
|
||||
## slice的数据结构
|
||||
|
||||
切片的底层数据结构定义如下:
|
||||
> [!question] ❓ 思考
|
||||
> 为什么 `arr2 := arr1[1:3]` 之后修改 `arr2[0]` 会影响 `arr1`?Slice 赋值到底是深拷贝还是浅拷贝?如果容量满了再 append,Go 会怎么做?
|
||||
|
||||
## 正文
|
||||
|
||||
### 一、Slice 的结构:一个指针 + 两个长度
|
||||
|
||||
Slice 在 runtime 层面的定义非常简洁:
|
||||
|
||||
```go
|
||||
// src/runtime/slice.go
|
||||
type slice struct {
|
||||
array unsafe.Pointer
|
||||
len int
|
||||
cap int
|
||||
array unsafe.Pointer // 指向底层数组
|
||||
len int // 当前已使用的元素个数
|
||||
cap int // 底层数组的总容量
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
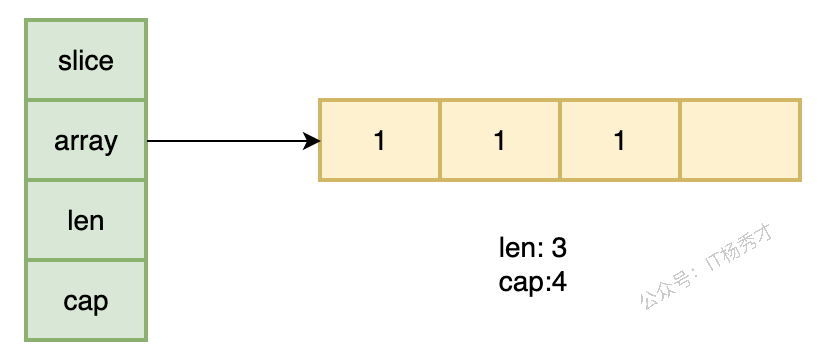
三个字段共 24 字节(64 位系统)。用一个图来描述:
|
||||
|
||||
slice结构 包含三个字段,array 类型为unsafe.Pointer,还有两个int类型的字段len和cap。
|
||||
|
||||
* **array:是一个指针变量,指向一块连续的内存空间,即底层数组结构**
|
||||
|
||||
* **len:当前切片中数据长度**
|
||||
|
||||
* **cap:切片的容量**
|
||||
|
||||
**注意:cap是大于等于len的,当cap大于len的时候,说明切片未满,它们之间的元素并不属于当前切片。**
|
||||
|
||||
## slice初始化
|
||||
|
||||
切片的初始化有三种方式:
|
||||
|
||||
1. 通过已有切片初始化(通过 : 操作进行截取)
|
||||
|
||||
2. 通过字面量初始化
|
||||
|
||||
3. 通过make关键字初始化
|
||||
|
||||
```go
|
||||
slice := slice1[1:5] // 从切片slice1初始化一个新的切片slice,slice的元素为slice1中的下标为1到下标为4的元素
|
||||
slice := []int{1,1,1}
|
||||
slice := make([]int, 3) // 第一个参数为类型,第二个参数为len
|
||||
slice := make([]int, 3, 4) // 第一个参数为类型,第二个参数为len,第三个参数为cap
|
||||
```mermaid
|
||||
graph LR
|
||||
S["slice struct<br/>array | len=3 | cap=5"] --> A["底层数组<br/>[1][2][3][4][5]"]
|
||||
style S fill:#e1f5fe
|
||||
style A fill:#fff9c4
|
||||
```
|
||||
|
||||
注意这里两种make创建的方式,当传递了容量参数时,若传递的参数比前面len的参数值大,那么实际创建的切片大小时是多余元素个数的,说明预留了空间。如果不指定cap,则默认创建cap和len大小相同的切片。
|
||||
| 字段 | 含义 | 示例值 |
|
||||
|------|------|--------|
|
||||
| `array` | 指向底层连续内存的指针 | `0xc00001a180` |
|
||||
| `len` | 可访问的元素数量 | `3` |
|
||||
| `cap` | 底层数组总大小(不含偏移) | `5` |
|
||||
|
||||
示例:
|
||||
> [!tip] 💡 理解要点
|
||||
> `cap >= len` 始终成立。`cap - len` 表示还能追加多少个元素而不触发扩容。
|
||||
|
||||
### 二、Slice 的三种初始化方式
|
||||
|
||||
```go
|
||||
package main
|
||||
// 1. 从已有切片截取
|
||||
s1 := s[low : high : max]
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
)
|
||||
// 2. 字面量初始化
|
||||
s2 := []int{1, 2, 3}
|
||||
|
||||
func main(){
|
||||
arr1 := make([]int,3,5)
|
||||
arr2 := make([]int,3)
|
||||
fmt.Printf("arr1,len=%d, cap=%d\n",len(arr1),cap(arr1))
|
||||
fmt.Printf("arr2,len=%d, cap=%d\n",len(arr2),cap(arr2))
|
||||
// 3. make 创建
|
||||
s3 := make([]int, 3) // len=3, cap=3
|
||||
s4 := make([]int, 3, 5) // len=3, cap=5
|
||||
```
|
||||
|
||||
arr3 := []int{1,2,3,4,5}
|
||||
arr4 := arr3[1:3]
|
||||
fmt.Printf("arr3=%v\n",arr3)
|
||||
fmt.Printf("arr4=%v\n",arr4)
|
||||
注意截取操作 `s[low : high : max]` 中:
|
||||
- 新切片的 `len = high - low`
|
||||
- 新切片的 `cap = max - low`
|
||||
- 新切片与原切片**共享同一块底层数组**
|
||||
|
||||
### 三、截取与赋值:共享底层数组
|
||||
|
||||
这是初学者最容易踩坑的地方——截取和赋值都不会复制底层数据:
|
||||
|
||||
```go
|
||||
src := []int{1, 2, 3, 4, 5}
|
||||
dst := src[1:3] // dst 指向 src 的底层数组
|
||||
dst[0] = 100 // src 变成了 [1, 100, 3, 4, 5]
|
||||
```
|
||||
|
||||
这是因为 slice 赋值实际上只是复制了三个字段(24 字节),其中 `array` 指针指向同一片内存区域:
|
||||
|
||||
```mermaid
|
||||
flowchart LR
|
||||
src["slice[src]<br/>array→▲"] --> A["底层数组<br/>[1][100][3][4][5]"]
|
||||
dst["slice[dst]<br/>array→▲"] --> A
|
||||
style A fill:#fff9c4
|
||||
```
|
||||
|
||||
> [!warning] ⚠️ 常见陷阱
|
||||
> 函数间传递 slice 时,接收方对元素的修改会影响调用方。如果需要完全独立的副本,必须用 `copy()` 或手动分配新切片。
|
||||
|
||||
#### 如何真正复制一个 slice
|
||||
|
||||
```go
|
||||
src := []int{1, 2, 3, 4, 5}
|
||||
dst := make([]int, len(src))
|
||||
copy(dst, src) // 真正的独立副本
|
||||
dst[0] = 100 // src 不受影响
|
||||
```
|
||||
|
||||
### 四、Append 与扩容策略
|
||||
|
||||
#### 4.1 Append 的行为
|
||||
|
||||
`append` 的本质是对 slice 结构体的**值拷贝**——每次调用都产生一个新的 slice 结构体(但共享底层数组),然后写入新元素:
|
||||
|
||||
```go
|
||||
arr1 := make([]int, 0, 4)
|
||||
arr1 = append(arr1, 1) // arr1=[1]
|
||||
arr2 := append(arr1, 2) // arr2=[1,2]
|
||||
arr3 := append(arr1, 3) // arr3=[1,3] — arr2 被覆盖了!
|
||||
```
|
||||
|
||||
为什么 `arr2` 变成了 `[1, 3]`?因为 `arr1`、`arr2`、`arr3` 共享同一底层数组,`arr3` 的写入覆盖了 `arr2` 写入的位置。
|
||||
|
||||
#### 4.2 扩容公式
|
||||
|
||||
当 `len == cap` 时,`append` 需要分配更大的底层数组。扩容策略经历了版本变化:
|
||||
|
||||
**Go 1.17 及之前:**
|
||||
|
||||
```mermaid
|
||||
flowchart TD
|
||||
Start["cap < 1024?"] -->|是| Doubles["newCap = oldCap * 2"]
|
||||
Start -->|否| Quarter["newCap = oldCap + oldCap/4"]
|
||||
Doubles --> Check{"newCap < 需要的容量?"}
|
||||
Quarter --> Check
|
||||
Check -->|是| Doubles2["newCap = newCap * 2"]
|
||||
Check -->|否| Final["newCap = 需要的容量"]
|
||||
Doubles2 --> Final
|
||||
```
|
||||
|
||||
**Go 1.18 及之后(更平滑的增长曲线):**
|
||||
|
||||
```
|
||||
newCap = oldCap + (oldCap + 3*256) / 4
|
||||
```
|
||||
|
||||
这个公式让小容量时接近翻倍,大容量时逐渐趋近于 1.25 倍,避免了大切片扩容时的内存浪费。
|
||||
|
||||
> [!note] 📝 源码要点
|
||||
> 扩容逻辑位于 `src/runtime/slice.go` 的 `growslice` 函数。它会根据元素类型(是否包含指针)选择不同的内存分配策略,并在某些情况下直接复用旧数组(当容量增长不超过 2 倍时)。
|
||||
|
||||
#### 4.3 growslice 核心流程
|
||||
|
||||
```go
|
||||
// src/runtime/slice.go (伪代码简化)
|
||||
func growslice(et *_type, old slice, cap int) slice {
|
||||
if et.ptrdata == 0 {
|
||||
// 无指针类型:一次 mallocgc 分配 hchan + buf
|
||||
newBuf = mallocgc(newSize, nil, true)
|
||||
memmove(newBuf, old.array, old.len) // 拷贝旧数据
|
||||
} else {
|
||||
// 有指针类型:分别分配
|
||||
newBuf = mallocgc(newSize, et, true)
|
||||
memmove(newBuf, old.array, old.len)
|
||||
}
|
||||
return slice{array: newBuf, len: old.len, cap: newCap}
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
关键点:
|
||||
- 扩容一定会**分配新内存并拷贝旧数据**
|
||||
- 如果元素包含指针,GC 会在拷贝后的新区间上重新扫描
|
||||
- 当请求的新容量不超过旧容量的 2 倍时,Go 会尝试直接扩展原有内存(零拷贝扩容)
|
||||
|
||||
```go
|
||||
arr1,len=3, cap=5
|
||||
arr2,len=3, cap=3
|
||||
arr3=[1 2 3 4 5]
|
||||
arr4=[2 3]
|
||||
```
|
||||
### 五、性能建议
|
||||
|
||||
1. **预分配容量**:已知最终大小的场景,用 `make([]T, 0, n)` 避免多次扩容
|
||||
2. **截取慎用**:截取后原数组无法被 GC 回收整片内存(只要有一个切片引用着)
|
||||
3. **深拷贝需求**:用 `copy()` 而非切片赋值,避免隐式共享
|
||||
|
||||
## 小结
|
||||
|
||||
## Slice操作
|
||||
|
||||
#### slice截取
|
||||
|
||||
从前面切片的数据结构分析我们可以知道切片在内存底层其实是一块连续的内存空间,跟数组一样,所以也可以通过下标的方式对切片进行截取。
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
)
|
||||
|
||||
func main(){
|
||||
arr1 := []int{1,2,3,4,5,6,7,8}
|
||||
arr2 := arr1[2:4] // 前闭后开,不包括下标为4的元素
|
||||
fmt.Printf("arr1=%v, cap=%d\n",arr1,cap(arr1))
|
||||
fmt.Printf("arr2=%v, cap=%d\n",arr2,cap(arr2))
|
||||
arr2[0] = 100
|
||||
fmt.Printf("arr1=%v, cap=%d\n",arr1,cap(arr1))
|
||||
fmt.Printf("arr2=%v, cap=%d\n",arr2,cap(arr2))
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
|
||||
```go
|
||||
arr1=[1 2 3 4 5 6 7 8], cap=8
|
||||
arr2=[3 4], cap=6
|
||||
arr1=[1 2 100 4 5 6 7 8], cap=8
|
||||
arr2=[100 4], cap=6
|
||||
```
|
||||
|
||||
可以看到,在切片截取的时候遵循的原则是前闭后开的,且截取之后的切片,容量大小为从新切片的第一个元素开始算,到原切片的容量末尾。
|
||||
|
||||
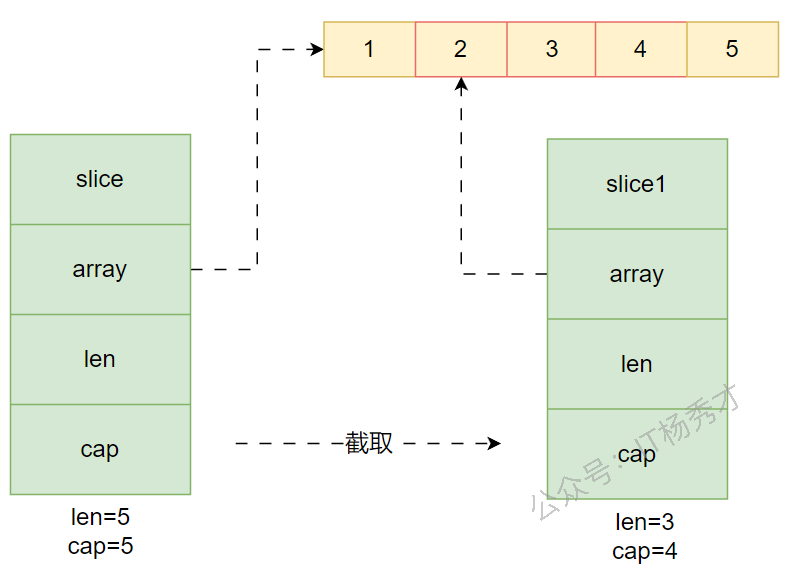
注意:被截取出来的新切片底层仍然指向原切片的底层数据
|
||||
|
||||
这一点尤其需要注意,在我们更改新切片的值的时候,可能会改变原切片。
|
||||
|
||||
|
||||
|
||||
如上图所示,比如通过截取的方式由slice派生出一个新额的切片slice1,其实底层他们都是指向的同一块数据区域,只是两个切片的下表对应的底层数组的数据不同,`slice[1]=`2,而`slice1[0]=`2,他们指向同一个元素,所以当修改`slice1[0]`的值,势必会影响原始数组。
|
||||
|
||||
#### slice复制
|
||||
|
||||
下面来看一下slice的复制操作,在前面分析中我们知道,通过截取创建的新的切片其底层指向的是同一块内存区域,那么通过复制创建的切片是否也是这样呢?
|
||||
|
||||
看个具体示例:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import "fmt"
|
||||
|
||||
func main() {
|
||||
arr1 := []int{1, 2, 3, 4, 5}
|
||||
arr2 := arr1
|
||||
arr2[0] = 100
|
||||
fmt.Printf("arr1=%v\n", arr1)
|
||||
fmt.Printf("arr2=%v\n", arr2)
|
||||
|
||||
arr3 := [3]int{1, 2, 3}
|
||||
arr4 := arr3
|
||||
arr4[0] = 100
|
||||
fmt.Printf("arr3=%v\n", arr3)
|
||||
fmt.Printf("arr4=%v\n", arr4)
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
|
||||
```go
|
||||
arr1=[100 2 3 4 5]
|
||||
arr2=[100 2 3 4 5]
|
||||
arr3=[1 2 3]
|
||||
arr4=[100 2 3]
|
||||
```
|
||||
|
||||
从程序结果可以看到,修改arr2影响了arr1,复制后的切片也和原切片指向同一块内存区域,会互相影响。但是数组的复制却不会出现这种情况,说明数组的复制会在底层会连同复制一块内存区域,与原数组互不影响
|
||||
|
||||
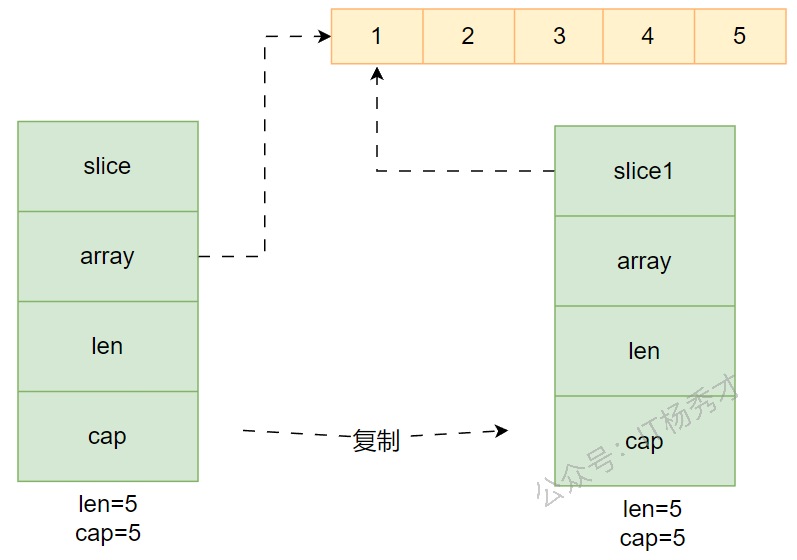
切片的赋值可以这样理解,如下如
|
||||
|
||||
|
||||
|
||||
复制操作原理其实很好理解,复制其实是复制了前面所说的slice 这个结构体,而在slice结构中真正与数据相关的其实是一个只想指向底层数组的一个array指针,所以这里其实是复制了一个指针而已,但是两个不同的指针还是指向同一块区域,所以对一个切片的修改会影响到另一个。
|
||||
|
||||
但是两个不同的指针还是指向同一块区域,所以对一个切片的修改会影响到另一个。
|
||||
|
||||
#### slice追加扩容
|
||||
|
||||
slice是动态数组,大小不固定,可以往后追加元素,追加的方法是通过append函数来实现,看一个有意思的例子:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import "fmt"
|
||||
|
||||
func main() {
|
||||
arr1 := make([]int, 0, 4)
|
||||
arr1 = append(arr1, 1)
|
||||
arr2 := append(arr1, 2)
|
||||
arr3 := append(arr1, 3)
|
||||
fmt.Printf("arr1=%v, addr1=%p\n", arr1, &arr1)
|
||||
fmt.Printf("arr2=%v, addr2=%p\n", arr2, &arr2)
|
||||
fmt.Printf("arr3=%v, addr3=%p\n", arr3, &arr3)
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
|
||||
```go
|
||||
arr1=[1], addr1=0xc000098060
|
||||
arr2=[1 3], addr2=0xc000098078
|
||||
arr3=[1 3], addr3=0xc000098090
|
||||
```
|
||||
|
||||
这里为什么arr2和arr3的结果是一样都是`[1,3]`呢,为什么arr2不是`[1,2]`?
|
||||
|
||||
|
||||
|
||||
原理是这样的,在前面的分析中我们知道了切片的结构定义,`type slice struct {...}`, Go 语言内置函数 append 参数是值传递,所以 append 函数在追加新元素到切片时,append 会生成一个新切片,并且将原切片的值拷贝到新切片。注意这里的新切片并不是指底层的数据结构,而是指`slice `这个结构体。所以我们每调用一次append函数,都会产生一个新的slice结构体,但是他们底层都指向同一块连续的内存区域,即共享底层数组,所以执行`arr3 := append(arr1, 3)`将`arr2`底层的数据`1,2`给覆盖了。
|
||||
|
||||
原理是这样的,在前面的分析中我们知道了切片的结构定义,`type slice struct {...}`, Go 语言内置函数 append 参数是值传递,所以 append 函数在追加新元素到切片时,append 会生成一个新切片,并且将原切片的值拷贝到新切片。注意这里的新切片并不是指底层的数据结构,而是指`slice `这个结构体。所以我们每调用一次append函数,都会产生一个新的slice结构体,但是他们底层都指向同一块连续的内存区域,即共享底层数组,所以执行`arr3 := append(arr1, 3)`将`arr2`底层的数据`1,2`给覆盖了。
|
||||
|
||||
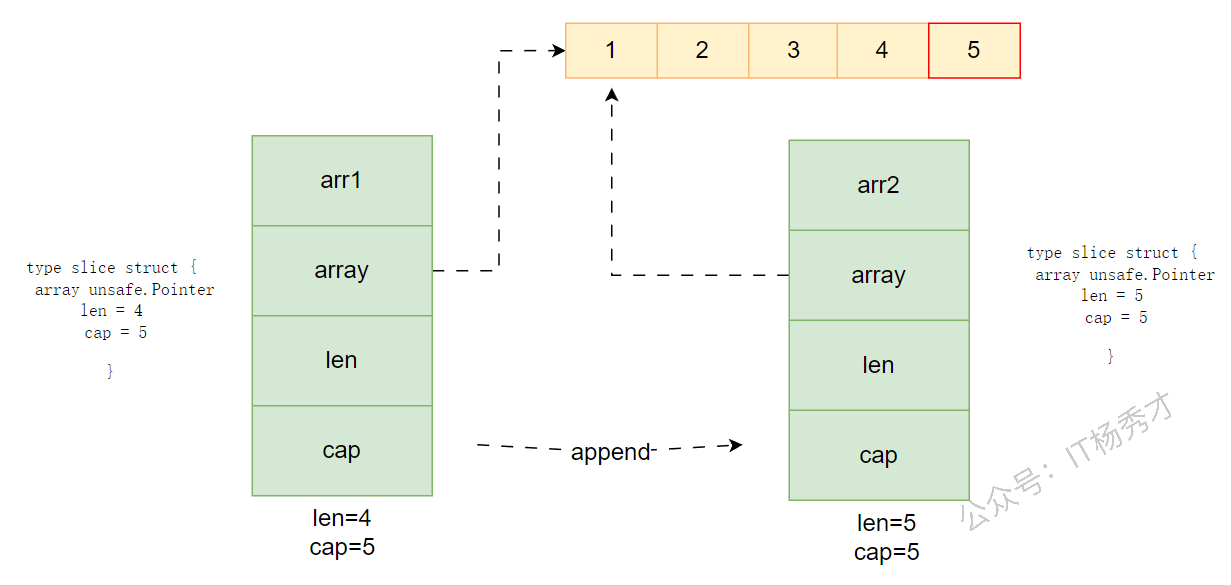
假设原切片`arr1`中由4个元素`1,2,3,4`,我们执行语句`arr2=append(arr1,5)`,其过程如下图:
|
||||
|
||||
|
||||
|
||||
最终会有两个slice结构体,但是他们都指向同一块内存区域。
|
||||
|
||||
###### **在追加元素时,slice容量不足怎么办?**
|
||||
|
||||
当往切片追加元素时,如果切片容量不足,会自动扩容,具体的扩容策略如下:
|
||||
|
||||
1.17之前
|
||||
|
||||
1. 首先看新的容量是否超过原容量的两倍,若超过原容量两倍,则扩容后的容量是用新容量大小
|
||||
|
||||
2. 新容量未超过原容量两倍,则看原切片容量是否小于1024,若小于1024,则新切片容量为原切片容量的两倍,若大于等于1024,则会反复地再原切片容量上增加1/4,直到新容量大于等于需要的容量
|
||||
|
||||
1.18及以后
|
||||
|
||||
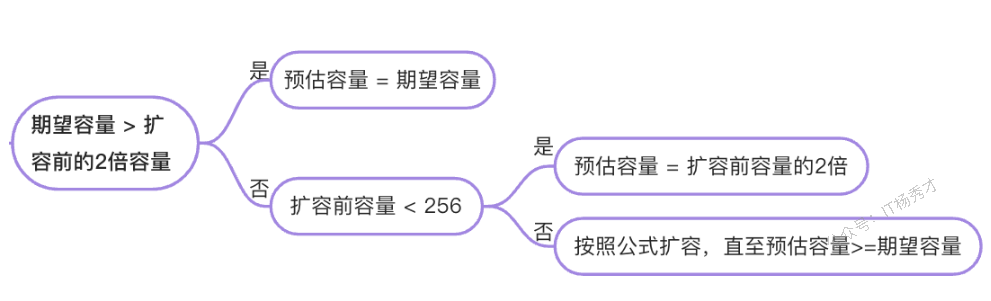
|
||||
|
||||
扩容公式:
|
||||
```
|
||||
newcap = oldcap+(oldcap+3*256)/4
|
||||
```
|
||||
|
||||
|
||||
简单看个样例:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import "fmt"
|
||||
|
||||
func main() {
|
||||
arr := make([]int, 4, 4)
|
||||
fmt.Printf("cap = %d\n", cap(arr))
|
||||
arr = append(arr, 1)
|
||||
fmt.Printf("cap = %d\n", cap(arr))
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
|
||||
```go
|
||||
cap = 4
|
||||
cap = 8
|
||||
```
|
||||
|
||||
容量做了翻倍
|
||||
|
||||
#### slice完全复制
|
||||
|
||||
在前面我们分析了slice的复制其底层仍然执行同一块内存区域,这样在使用中可能会带来问题,比如有时候我们想要完全复制出一个新的切片,二者用不同的底层数组,这样使用起来互不干扰,我们可以使用copy函数实现这个功能。
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import "fmt"
|
||||
|
||||
func main() {
|
||||
arr := []int{1, 2, 3, 4}
|
||||
arr1 := make([]int, 3)
|
||||
cnt := copy(arr1, arr)
|
||||
fmt.Printf("cnt=%d\n", cnt)
|
||||
fmt.Printf("arr1=%v\n", arr1)
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
|
||||
```go
|
||||
cnt=3
|
||||
arr1=[1 2 3]
|
||||
```
|
||||
|
||||
copy函数将第二个参数切片中的元素拷贝到第一个参数切片中,如果第一个参数切片容量不够,则返回的cnt的值为第一个切片容量大小,只会成功复制cnt个元素。
|
||||
- Slice 是 `(ptr, len, cap)` 三字段结构,本质是一个"窗口"指向底层数组
|
||||
- 截取和赋值都是浅操作,共享底层数组;深拷贝需用 `copy()`
|
||||
- 扩容策略因版本而异:1.17 前是小容量翻倍/大容量加 1/4,1.18+ 用平滑公式
|
||||
- 预分配容量能显著减少扩容带来的开销
|
||||
|
||||
## 关联笔记
|
||||
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言数组与切片]] — Slice 的基础用法
|
||||
- [[hzh/GolangStar/Go语言原理/string原理]] — String 的底层结构与转换
|
||||
- [[hzh/GolangStar/Go面试题库/Slice面试题]] — Slice 相关高频面试题
|
||||
|
||||
Reference in New Issue
Block a user