vault backup: 2026-06-07 12:14:39
This commit is contained in:

+161
-279
@@ -1,321 +1,203 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go原理深入
|
||||
- defer原理
|
||||
tags: [go, golang, go-principle, defer]
|
||||
create time: 2026-06-07 15:35
|
||||
---
|
||||
|
||||
# defer原理
|
||||
# Defer 执行原理
|
||||
|
||||
## defer是什么
|
||||
## 概述
|
||||
|
||||
defer是go语言的一个关键字,用来修饰函数,其作用是让defer后面跟的函数或者方法调用能够延迟到当前所在函数return或者panic的时候再执行。
|
||||
本文从编译期和运行期两个层面解析 Go `defer` 的底层实现:_defer 链表结构、三种分配方式(堆/栈/开放编码)、以及 LIFO 执行机制。理解 defer 的原理能帮你避免循环中的性能陷阱,也能更深入地理解 panic/recover 的行为。
|
||||
|
||||
## defer的使用形式
|
||||
> [!question] ❓ 思考
|
||||
> 为什么多个 defer 按后进先出(LIFO)顺序执行?defer 注册的函数参数是在注册时求值还是执行时求值?Go 1.14 引入的"开放编码"优化了什么?
|
||||
|
||||
```go
|
||||
defer func(args)
|
||||
```
|
||||
## 正文
|
||||
|
||||
defer在使用的时候,只需要在其后面加上具体的函数调用即可,这样就会注册一个延迟执行的函数func,并且会把函数名和参数都确定,等到从当前函数退出的时候在执行
|
||||
### 一、Defer 的存储结构:_defer 链表
|
||||
|
||||
## defer的底层结构
|
||||
|
||||
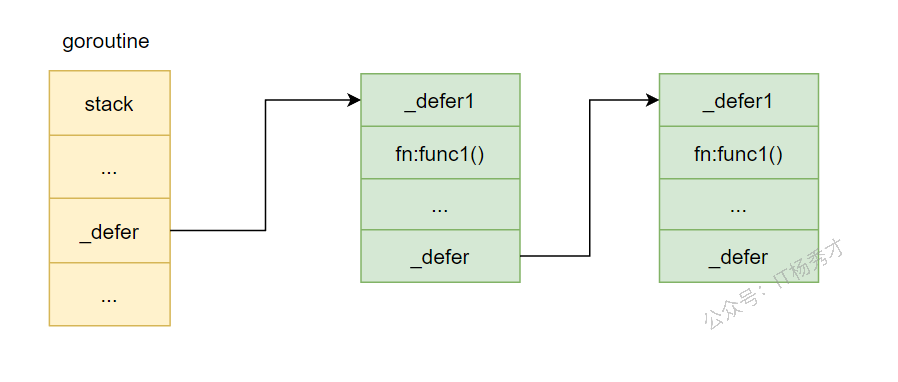
进行defer 函数调用的时候其实会生成一个\_defer结构,一个函数中可能有多次defer调用,所以会生成多个这样的\_defer结构,这些\_defer结构链式存储构成一个\_defer链表,当前goroutine的\_defer指向这个链表的头节点,
|
||||
|
||||
\_defer 的结构定义在src/src/runtime/runtime2.go中,源码如下:
|
||||
每次使用 `defer` 关键字都会创建一个 `_defer` 结构,同一函数中的多个 defer 通过链表串联:
|
||||
|
||||
```go
|
||||
type _defer struct {
|
||||
started bool // 标志位,标识defer函数是否已经开始执行,默认为false
|
||||
heap bool // 标记位,标志当前defer结构是否是分配在堆上
|
||||
openDefer bool // 标记位,标识当前defer是否以开放编码的方式实现
|
||||
sp uintptr // 调用方的sp寄存器指针,即栈指针
|
||||
pc uintptr // 调用方的程序计数器指针
|
||||
fn func() // defer注册的延迟执行的函数
|
||||
_panic *_panic // 标识是否panic时触发,非panic触发时,为nil
|
||||
link *_defer // defer链表
|
||||
fd unsafe.Pointer // defer调用的相关参数
|
||||
varp uintptr // value of varp for the stack frame
|
||||
framepc uintptr
|
||||
started bool // 是否已开始执行
|
||||
heap bool // 是否分配在堆上
|
||||
openDefer bool // 是否使用开放编码模式
|
||||
sp uintptr // 调用方栈指针
|
||||
pc uintptr // 调用方程序计数器
|
||||
fn func() // 延迟执行的函数(注意:已经是 bound 过的)
|
||||
_panic *_panic // 关联的 panic 对象
|
||||
link *_defer // 链表下一个节点
|
||||
fd unsafe.Pointer // defer 相关参数
|
||||
}
|
||||
```
|
||||
|
||||
底层存储如下图:
|
||||
存储示意:
|
||||
|
||||
|
||||
|
||||
defer函数在注册的时候,创建的\_defer结构会依次插入到\_defer链表的表头,在当前函数return的时候,依次从\_defer链表的表头取出\_defer结构执行里面的fn函数
|
||||
|
||||
## defer的执行过程
|
||||
|
||||
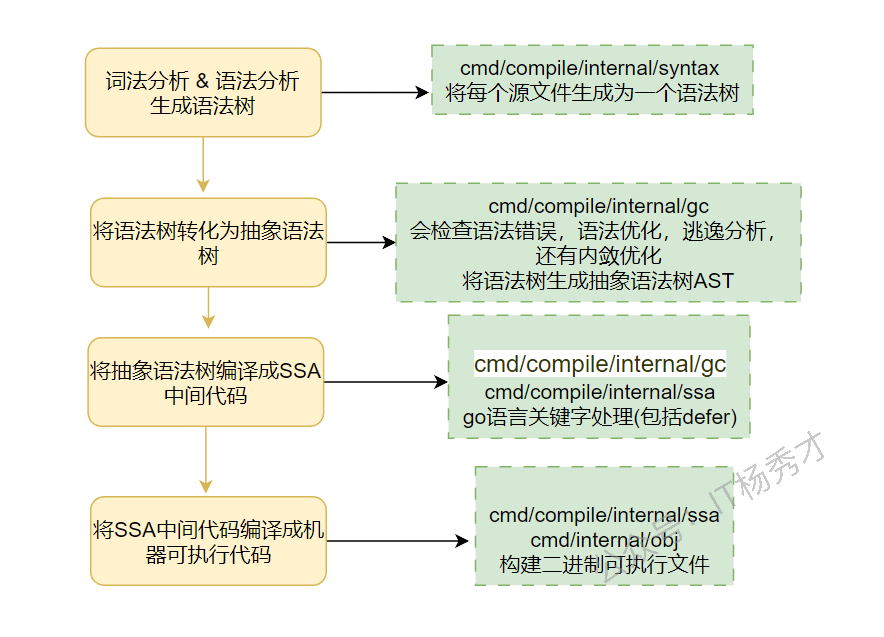
在探究defer的执行过程之前,先简单看一下go语言程序的编译过程,go语言程序由.go文件编译成最终的二进制机器码主要有以下结果步骤
|
||||
|
||||
|
||||
|
||||
defer关键字的处理在生成SSA中间代码阶段,编译器遇到 defer 语句的时候,会插入两种函数:
|
||||
|
||||
1. defer内存分配函数:`deferproc`(堆分配) 或 `deferprocStack`(栈分配) 
|
||||
|
||||
2. 执行函数:`deferreturn` 
|
||||
|
||||
下面分别看一下这两种函数的执行过程
|
||||
|
||||
defer的处理逻辑在cmd/compile/internal/ssagen/ssa.go文件中的state.stmt()方法中,由于源码过长,这里只贴部分重要代码:
|
||||
|
||||
```go
|
||||
case ir.ODEFER: // 如果节点时defer节点
|
||||
n := n.(*ir.GoDeferStmt)
|
||||
if base.Debug.Defer > 0 {
|
||||
var defertype string
|
||||
if s.hasOpenDefers {
|
||||
defertype = "open-coded" // 开放编码
|
||||
} else if n.Esc() == ir.EscNever {
|
||||
defertype = "stack-allocated" // 栈分配
|
||||
} else {
|
||||
defertype = "heap-allocated" // 堆分配
|
||||
}
|
||||
base.WarnfAt(n.Pos(), "%s defer", defertype)
|
||||
}
|
||||
if s.hasOpenDefers { // 如果可以开放编码,即内联实现
|
||||
s.openDeferRecord(n.Call.(*ir.CallExpr)) // 就使用开放编码这种方式
|
||||
} else {
|
||||
d := callDefer // 否则先默认使用堆分配的模式
|
||||
if n.Esc() == ir.EscNever { // 没有内存逃逸,使用栈分配的方式实现
|
||||
d = callDeferStack
|
||||
}
|
||||
s.callResult(n.Call.(*ir.CallExpr), d)
|
||||
}
|
||||
```mermaid
|
||||
flowchart LR
|
||||
GP["goroutine._defer"] --> D1["_defer #3<br/>fn: Close()"]
|
||||
D1 --> D2["_defer #2<br/>fn: Unlock()"]
|
||||
D2 --> D3["_defer #1<br/>fn: Log()"]
|
||||
D3 --> nil["nil"]
|
||||
style GP fill:#e3f2fd
|
||||
style D1 fill:#ffebee
|
||||
style D2 fill:#fff9c4
|
||||
style D3 fill:#e8f5e9
|
||||
```
|
||||
|
||||
从上述代码可以看出,defer的是现有三种实现方式,在栈上分配内存,在堆上分配内存以及使用开放编码的方式。会优先使用内联方式,当内联不满足,且没有发生内存逃逸的情况下,使用栈分配的方式,这两种情况都不符合的情况下在使用堆分配,这样做的好处是提升性能。
|
||||
每个新的 defer 插入到链表**头部**,执行时也从头部取出——这就是 LIFO 顺序的由来。
|
||||
|
||||
### \_defer内存分配
|
||||
### 二、编译期处理:三种实现方式
|
||||
|
||||
在上面的分析中我们可以看出在不同的情况下,\_defer结构分配在不同的地方,可能分配在堆上也可能分配在栈上,这两种分配方式调用的函数是不同的,堆上分配实际调用的是`runtime.deferproc`函数,栈上分配内存调用的是`runtime.deferprocStack`函数,下面分别来看看这两个函数都做了些什么工作?
|
||||
Go 编译器在 SSA 阶段遇到 `defer` 时,会决定用哪种方式实现:
|
||||
|
||||
#### 堆上分配
|
||||
```mermaid
|
||||
flowchart TD
|
||||
CanOpen{"可开放编码?<br/>函数≤8个defer<br/>不在循环中<br/>返回值数×defer数≤15"}
|
||||
CanOpen -->|是| OpenCoded["开放编码: 内联到每个 exit path"]
|
||||
CanOpen -->|否| NoEscape{内存逃逸?}
|
||||
NoEscape -->|否 - 栈上| StackAlloc["栈分配: deferprocStack"]
|
||||
NoEscape -->|是 - 堆上| HeapAlloc["堆分配: deferproc"]
|
||||
style OpenCoded fill:#e8f5e9
|
||||
style StackAlloc fill:#fff9c4
|
||||
style HeapAlloc fill:#ffebee
|
||||
```
|
||||
|
||||
`先看deferproc`函数,在堆上分配内存,go 1.13 之前只有这个函数,说明go 1.13 之前,\_defer只能在堆上分配。
|
||||
#### 方式 1:开放编码(Open-Coded Defer)— Go 1.14+
|
||||
|
||||
src/runtime/panic.go
|
||||
当满足条件时,编译器将 defer 逻辑直接内联到函数的每个 return 路径中,省去了函数调用的开销。
|
||||
|
||||
```go
|
||||
// 原始代码
|
||||
func f() (int, int) {
|
||||
defer fmt.Println("first")
|
||||
defer fmt.Println("second")
|
||||
return 1, 2
|
||||
}
|
||||
// 编译后等效于:
|
||||
func f() (int, int) {
|
||||
fmt.Println("second")
|
||||
fmt.Println("first")
|
||||
return 1, 2
|
||||
}
|
||||
```
|
||||
|
||||
适用条件:
|
||||
- 函数中 defer 数量 ≤ 8
|
||||
- 不在 for/while 循环体内
|
||||
- 返回值个数 × defer 个数 ≤ 15
|
||||
- 未使用 `-N` 编译标志
|
||||
|
||||
#### 方式 2:栈分配 — Go 1.13+
|
||||
|
||||
当 defer 不逃逸时,_defer 结构直接在函数调用栈上分配:
|
||||
|
||||
```go
|
||||
func deferprocStack(d *_defer) {
|
||||
gp := getg()
|
||||
d.started = false
|
||||
d.heap = false
|
||||
d.sp = getcallersp()
|
||||
d.pc = getcallerpc()
|
||||
// 链入 goroutine 的 _defer 链表头部
|
||||
*(*uintptr)(unsafe.Pointer(&d.link)) = uintptr(unsafe.Pointer(gp._defer))
|
||||
*(*uintptr)(unsafe.Pointer(&gp._defer)) = uintptr(unsafe.Pointer(d))
|
||||
}
|
||||
```
|
||||
|
||||
栈分配避免了堆上的 malloc/free,性能优于堆分配。
|
||||
|
||||
#### 方式 3:堆分配 — 传统方式
|
||||
|
||||
当 defer 发生逃逸(如在循环中),_defer 分配在堆上:
|
||||
|
||||
```go
|
||||
func deferproc(fn func()) {
|
||||
gp := getg() // 获取goroutine,defer在哪个goroutine中执行
|
||||
if gp.m.curg != gp {
|
||||
// go code on the system stack can't defer
|
||||
throw("defer on system stack")
|
||||
}
|
||||
|
||||
d := newdefer() // 在堆中新建一个_defer对象
|
||||
if d._panic != nil {
|
||||
throw("deferproc: d.panic != nil after newdefer")
|
||||
}
|
||||
d.link = gp._defer // 将这个新建的defer对象加入到goroutine的defer链表头部
|
||||
gp._defer = d
|
||||
d.fn = fn
|
||||
d.pc = getcallerpc()
|
||||
d.sp = getcallersp()
|
||||
return0()
|
||||
|
||||
gp := getg()
|
||||
d := newdefer() // 从 P 或全局 deferpool 获取,无则 mallocgc
|
||||
d.link = gp._defer
|
||||
gp._defer = d
|
||||
d.fn = fn
|
||||
}
|
||||
```
|
||||
|
||||
重点看一下newdefer()这个函数
|
||||
> [!warning] ⚠️ 重要
|
||||
> **不要在循环中使用 defer!** 循环中的 defer 无法使用开放编码,且必定逃逸到堆上,导致每次迭代都触发 malloc/free。如果需要清理资源,手动在循环内调用 cleanup 函数。
|
||||
|
||||
```go
|
||||
func newdefer() *_defer {
|
||||
var d *_defer
|
||||
mp := acquirem()
|
||||
pp := mp.p.ptr() // 获取逻辑处理器p
|
||||
// p的本地defer缓存池为空且全局defer缓存池不为空,从全局defer缓存池取出一个defer结构加入到p的本地defer缓存池
|
||||
if len(pp.deferpool) == 0 && sched.deferpool != nil {
|
||||
lock(&sched.deferlock)
|
||||
for len(pp.deferpool) < cap(pp.deferpool)/2 && sched.deferpool != nil {
|
||||
d := sched.deferpool
|
||||
sched.deferpool = d.link
|
||||
d.link = nil
|
||||
pp.deferpool = append(pp.deferpool, d)
|
||||
}
|
||||
unlock(&sched.deferlock)
|
||||
}
|
||||
// p的本地defer缓存池取出一个defer结构
|
||||
if n := len(pp.deferpool); n > 0 {
|
||||
d = pp.deferpool[n-1]
|
||||
pp.deferpool[n-1] = nil
|
||||
pp.deferpool = pp.deferpool[:n-1]
|
||||
}
|
||||
releasem(mp)
|
||||
mp, pp = nil, nil
|
||||
// p的本地defer缓存池和全局defer缓存池都没有可用的defer结构,在堆上创建一个
|
||||
if d == nil {
|
||||
// Allocate new defer.
|
||||
d = new(_defer)
|
||||
}
|
||||
d.heap = true
|
||||
return d
|
||||
}
|
||||
```
|
||||
### 三、运行期执行:deferreturn
|
||||
|
||||
可以看出堆上defer的创建思想借助了内存复用,用到了内存池的思想,创建defer的过程是:优先在p的本地和全局的defer缓存池里找到一个可用的defer结构返回,找不到在去堆上创建
|
||||
|
||||
#### 栈上分配
|
||||
|
||||
下面看一下`runtime.deferprocStack`函数,在栈上分配\_defer,这个函数是go 1.13 之后引入的,优化defer性能的,显然在栈上分配的效率更高。`runtime.deferprocStack`源码如下:
|
||||
|
||||
```go
|
||||
// 在调用这个函数之前,defer结构已经站在栈上创建好,这里只是作为参数传进来赋值
|
||||
func deferprocStack(d *_defer) {
|
||||
gp := getg() // // 获取goroutine,defer在哪个goroutine中执行
|
||||
if gp.m.curg != gp {
|
||||
// go code on the system stack can't defer
|
||||
throw("defer on system stack")
|
||||
}
|
||||
d.started = false
|
||||
d.heap = false // 堆上分配置为false
|
||||
d.openDefer = false
|
||||
d.sp = getcallersp()
|
||||
d.pc = getcallerpc()
|
||||
d.framepc = 0
|
||||
d.varp = 0
|
||||
*(*uintptr)(unsafe.Pointer(&d._panic)) = 0
|
||||
*(*uintptr)(unsafe.Pointer(&d.fd)) = 0
|
||||
*(*uintptr)(unsafe.Pointer(&d.link)) = uintptr(unsafe.Pointer(gp._defer))
|
||||
*(*uintptr)(unsafe.Pointer(&gp._defer)) = uintptr(unsafe.Pointer(d))
|
||||
return0()
|
||||
|
||||
}
|
||||
```
|
||||
|
||||
Go 在编译的时候在 SSA中间代码阶段,如果判断出\_defer需要在站上分配,则编译器会直接在函数调用栈上初始化 \_defer 记录,并作为参数传递给 deferprocStack函数。
|
||||
|
||||
#### 开放编码
|
||||
|
||||
再看一下defer的第三种实现方式,开放编码。这种方式是在go1.14 引入的继续优化defer实现性能的方式。在go1.14 中通过代码内联优化,使得函数末尾直接对`defer`函数进行调用,减少了函数调用开销。其主要逻辑位于 cmd/compile/internal/walk/stmt.go文件的 walkStmt()函数和 cmd/compile/internal/ssagen/ssa.go 的 buildssa()函数,函数较长,这里看下关键代码。
|
||||
|
||||
walkStmt()函数:
|
||||
|
||||
```go
|
||||
case ir.ODEFER:
|
||||
n := n.(*ir.GoDeferStmt)
|
||||
ir.CurFunc.SetHasDefer(true)
|
||||
ir.CurFunc.NumDefers++
|
||||
if ir.CurFunc.NumDefers > maxOpenDefers { // maxOpenDefers = 8
|
||||
// defer函数的个数多余8个时,不能用开放编码模式
|
||||
ir.CurFunc.SetOpenCodedDeferDisallowed(true)
|
||||
}
|
||||
if n.Esc() != ir.EscNever {
|
||||
// If n.Esc is not EscNever, then this defer occurs in a loop,
|
||||
// so open-coded defers cannot be used in this function.
|
||||
ir.CurFunc.SetOpenCodedDeferDisallowed(true)
|
||||
}
|
||||
fallthrough
|
||||
```
|
||||
|
||||
 这里分析一下`n.Esc() != ir.EscNever`这个条件:
|
||||
|
||||
通过源码注释可以看到,这里其实就是判断defer是否在循环体内,因为 defer 在 for 循环中调用,编译器不确定会执行多少次,会逃逸到堆上,这样defer就只能分配在堆中了。所以在使用defer 延迟调用的时候,尽量不要在循环中使用,否则可能导致性能问题。
|
||||
|
||||
buildssa()函数:
|
||||
|
||||
```go
|
||||
// build时候的没有设置-N,允许内联
|
||||
s.hasOpenDefers = base.Flag.N == 0 && s.hasdefer && !s.curfn.OpenCodedDeferDisallowed()
|
||||
switch {
|
||||
case base.Debug.NoOpenDefer != 0:
|
||||
s.hasOpenDefers = false
|
||||
case s.hasOpenDefers && (base.Ctxt.Flag_shared || base.Ctxt.Flag_dynlink) && base.Ctxt.Arch.Name == "386":
|
||||
// Don't support open-coded defers for 386 ONLY when using shared
|
||||
// libraries, because there is extra code (added by rewriteToUseGot())
|
||||
// preceding the deferreturn/ret code that we don't track correctly.
|
||||
s.hasOpenDefers = false
|
||||
}
|
||||
if s.hasOpenDefers && len(s.curfn.Exit) > 0 {
|
||||
// Skip doing open defers if there is any extra exit code (likely
|
||||
// race detection), since we will not generate that code in the
|
||||
// case of the extra deferreturn/ret segment.
|
||||
s.hasOpenDefers = false
|
||||
}
|
||||
if s.hasOpenDefers {
|
||||
// Similarly, skip if there are any heap-allocated result
|
||||
// parameters that need to be copied back to their stack slots.
|
||||
for _, f := range s.curfn.Type().Results().FieldSlice() {
|
||||
if !f.Nname.(*ir.Name).OnStack() {
|
||||
s.hasOpenDefers = false
|
||||
break
|
||||
}
|
||||
}
|
||||
}
|
||||
if s.hasOpenDefers &&
|
||||
// defer所在函数返回值个数和defer函数个数乘积不能大于15
|
||||
s.curfn.NumReturns*s.curfn.NumDefers > 15 {
|
||||
// Since we are generating defer calls at every exit for
|
||||
// open-coded defers, skip doing open-coded defers if there are
|
||||
// too many returns (especially if there are multiple defers).
|
||||
// Open-coded defers are most important for improving performance
|
||||
// for smaller functions (which don't have many returns).
|
||||
s
|
||||
```
|
||||
|
||||
总结一下:在g1.14之后,go会优先采用内联的方式处理defer函数调用,但是需要满足以下几个条件:
|
||||
|
||||
* build编译的时候没有设置-N
|
||||
|
||||
* defer 函数个数没有超过 8 个
|
||||
|
||||
* defer所在函数返回值个数和defer函数个数乘积不超过15
|
||||
|
||||
* defer没有出现在循环语句中时
|
||||
|
||||
### defer函数执行
|
||||
|
||||
在给defer分配好内存之后,剩下的就是执行了。在函数退出的时候,`deferreturn` 来执行defer链表上的各个defer函数。函数源码如下:
|
||||
函数返回前,编译器插入 `deferreturn()` 调用:
|
||||
|
||||
```go
|
||||
func deferreturn() {
|
||||
gp := getg()
|
||||
// 遍历goroutine的defer链表
|
||||
for {
|
||||
d := gp._defer
|
||||
if d == nil {
|
||||
return
|
||||
}
|
||||
sp := getcallersp() // 获取调用栈的栈顶指针
|
||||
if d.sp != sp {
|
||||
return
|
||||
}
|
||||
// 开放编码模式,内联处理
|
||||
if d.openDefer {
|
||||
done := runOpenDeferFrame(gp, d)
|
||||
if !done {
|
||||
throw("unfinished open-coded defers in deferreturn")
|
||||
}
|
||||
gp._defer = d.link
|
||||
freedefer(d)
|
||||
// If this frame uses open defers, then this
|
||||
// must be the only defer record for the
|
||||
// frame, so we can just return.
|
||||
return
|
||||
}
|
||||
// 非内联模式
|
||||
fn := d.fn // 获取defer的执行函数
|
||||
d.fn = nil // defer上的函数指针置空
|
||||
gp._defer = d.link // 遍历下一个defer结构
|
||||
freedefer(d) // 释放defer结构,优先归还到defer缓冲池中
|
||||
fn() // 执行函数调用
|
||||
}
|
||||
gp := getg()
|
||||
for {
|
||||
d := gp._defer
|
||||
if d == nil { return }
|
||||
if d.sp != getcallersp() { return } // 跨帧保护
|
||||
|
||||
if d.openDefer {
|
||||
runOpenDeferFrame(gp, d)
|
||||
gp._defer = d.link
|
||||
freedefer(d)
|
||||
return
|
||||
}
|
||||
|
||||
fn := d.fn // 取出函数指针
|
||||
d.fn = nil // 置空
|
||||
gp._defer = d.link // 移到下一个
|
||||
freedefer(d) // 释放(优先归还到 deferpool)
|
||||
fn() // 执行
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
当 go函数 的 `return` 关键字执行的时候,触发 `call` 调用 `deferreturn`函数,deferreturn函数的执行逻辑也很简单,就是遍历goroutine上的defer链表,从表头开始遍历,依次取出defer结构执行defer结构中的函数执行。
|
||||
执行流程:
|
||||
|
||||
总结:
|
||||
```mermaid
|
||||
flowchart TD
|
||||
F["函数 return"] --> DR["deferreturn()"]
|
||||
DR --> Loop{"有 _defer?"}
|
||||
Loop -->|否| Ret["正常返回"]
|
||||
Loop -->|是| Next["取头部 _defer"]
|
||||
Next --> Exec{"开放编码?"}
|
||||
Exec -->|是| RunOpen["runOpenDeferFrame"]
|
||||
Exec -->|否| Call["fn() 调用函数"]
|
||||
RunOpen --> Free["freedefer 释放"]
|
||||
Call --> Free
|
||||
Free --> Loop
|
||||
style DR fill:#e3f2fd
|
||||
style Call fill:#fff9c4
|
||||
style Ret fill:#e8f5e9
|
||||
```
|
||||
|
||||
1. 遇到defer关键字,编译器会在编译阶段注册defer函数的时候插入`deferproc()`函数或者`deferprocStack`函数,在return之前插入deferreturn()函数
|
||||
### 四、DeferPool:内存复用
|
||||
|
||||
2. defer函数的执行顺序是LIFO的,因为每次创建的defer结构都是插入到goroutine的defer链表表头
|
||||
`newdefer` 不会每次都分配新内存,而是采用三层缓存策略:
|
||||
|
||||
3. defer结构的有三种实现方式,堆上分配,栈上分配还有内联实现
|
||||
```
|
||||
P.local deferpool → sched.global deferpool → heap malloc
|
||||
```
|
||||
|
||||
1. 先从当前 P 的本地 deferpool 中取
|
||||
2. 如果本地为空且全局池非空,批量从全局池迁移到本地
|
||||
3. 如果都没有,才在堆上 `new(_defer)`
|
||||
|
||||
执行完毕后,`freedefer` 会将 _defer 放回 P 的本地 deferpool 复用。
|
||||
|
||||
> [!tip] 💡 理解要点
|
||||
> 这个设计类似于 TCMalloc 的 ThreadCache 思想——通过本地缓存减少锁竞争和 GC 压力。
|
||||
|
||||
## 小结
|
||||
|
||||
- Defer 用 _defer 链表实现,新节点插入头部 → LIFO 执行顺序
|
||||
- 三种实现方式:开放编码(最快)> 栈分配 > 堆分配(最慢)
|
||||
- 循环中用 defer 会导致逃逸到堆,应避免
|
||||
- defer 注册的函数和参数在**注册时即已确定**(包括命名返回值的快照)
|
||||
|
||||
## 关联笔记
|
||||
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言defer]] — Defer 的基础用法
|
||||
- [[hzh/GolangStar/Go语言基础/Go语言异常捕获]] — Panic/Recover 与 Defer 的关系
|
||||
- [[hzh/GolangStar/Go语言原理/逃逸分析]] — 变量何时逃逸到堆
|
||||
|
||||
Reference in New Issue
Block a user