vault backup: 2026-06-07 11:08:10
This commit is contained in:

@@ -0,0 +1,287 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶语法
|
||||
- Channel
|
||||
---
|
||||
|
||||
# Channel
|
||||
我们知道可以通过`go`关键字来开启一个`goroutine`,我们的样例代码逻辑很简单,都是在各个`goroutine`各自处理自己的逻辑,但有时候我们需要不同的`goroutine`之间能够通信,这里就要用到`channel`。
|
||||
|
||||
## channel是什么
|
||||
官方定义:
|
||||
Channels are a typed conduit through which you can send and receive values with the channel operator
|
||||
Channel是一个可以收发数据的管道
|
||||
|
||||
## channel初始化
|
||||
channel的声明方式如下:
|
||||
```go
|
||||
var channel_name chan channel_type
|
||||
var channel_name [size]chan channel_type // 声明一个channel,其容量大小为size
|
||||
```
|
||||
声明之后的管道,并没有进行初始化为其分配空间,其值是`nil`,我们要使用还要配合`make`函数来对其初始化,之后才可以在程序中使用该管道。
|
||||
```go
|
||||
channel_name := make(chan channel_type)
|
||||
channel_name := make(chan channel_type, size)
|
||||
```
|
||||
或者我们可以直接一步完成声明和初始化,如下:
|
||||
```go
|
||||
channel_name := make(chan channel_type)
|
||||
channel_name := make(chan channel_type, size) //创建带有缓存的管道,size为缓存大小
|
||||
```
|
||||
|
||||
## channel操作
|
||||
channel的操作主要有以下几种
|
||||
```go
|
||||
ch := make(chan int) // 创建一个管道ch
|
||||
ch <- v // 向管道ch中发送数据v.
|
||||
v := <-ch // 从管道中读取数据存储到变量v
|
||||
close(ch) // 关闭管道ch
|
||||
```
|
||||
在这里需要注意`close(ch)`这个操作,管道用完了,需要对其进行关闭,避免程序一直在等待以及资源的浪费。但是关闭的管道,仍然可以从中接收数据,只是接收到的的数据永远是零值。
|
||||
看下面例子:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch := make(chan int, 5)
|
||||
ch <- 1
|
||||
close(ch)
|
||||
go func() {
|
||||
for i := 0; i < 5; i++ {
|
||||
v := <-ch
|
||||
fmt.Printf("v=%d\n", v)
|
||||
}
|
||||
}()
|
||||
time.Sleep(2 * time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
v=1
|
||||
v=0
|
||||
v=0
|
||||
v=0
|
||||
v=0
|
||||
```
|
||||
创建一个缓存为`5`的`int`类型的管道,向管道里写入一个`1`之后,将管道关闭,然后开启一个`gortoutine`从管道读取数据,读取`5`次,可以看到即便管道关闭之后,他仍然可以读取数据,在读完数据之后,将一直读取零值。
|
||||
但是,上述读取方式还有一个问题?比如我们创建一个`int`类型的`channel`,我们需要往里面写入零值,用另一个`goroutine`读取,此时我们就无法区两种常用的读取方式
|
||||
|
||||
### 判定读取
|
||||
还是以上面的例子来看,稍作修改
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch := make(chan int, 5)
|
||||
ch <- 1
|
||||
close(ch)
|
||||
go func() {
|
||||
for i := 0; i < 5; i++ {
|
||||
v, ok := <-ch // 判断句式读取
|
||||
if ok {
|
||||
fmt.Printf("v=%d\n", v)
|
||||
} else {
|
||||
fmt.Printf("channel数据已读完,v=%d\n", v)
|
||||
}
|
||||
}
|
||||
}()
|
||||
time.Sleep(2 * time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
v=1
|
||||
channel数据已读完,v=0
|
||||
channel数据已读完,v=0
|
||||
channel数据已读完,v=0
|
||||
channel数据已读完,v=0
|
||||
```
|
||||
在读取`channel`数据的时候,用`ok`做了判断,当管道内还有数据能读取的时候,`ok`为`true`,当管道关闭后,`ok`为`false`。
|
||||
|
||||
### for range读取
|
||||
在上面例子中,我们明确了读取的次数是5次,但是我们往往在更多的时候,是不明确读取次数的,只是在`channel`的一端读取数据,有数据我们就读,直到另一端关闭了这个`channel`,这样就可以用`for range`这种优雅的方式来读取`channel`中的数据了
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch := make(chan int, 5)
|
||||
ch <- 1
|
||||
ch <- 2
|
||||
close(ch)
|
||||
go func() {
|
||||
for v := range ch {
|
||||
fmt.Printf("v=%d\n", v)
|
||||
}
|
||||
}()
|
||||
time.Sleep(2 * time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
v=1
|
||||
v=2
|
||||
```
|
||||
主`goroutine`往`channel`里写了两个数据`1`和`2`,然后关闭,子`goroutine`也只能读取到`1`和`2`。这里在主`goroutine`关闭了`channel`之后,子`goroutine`里的`for range`循环才会结束。
|
||||
|
||||
## 双向channel和单向channel
|
||||
channel根据其功能又可以分为双向`channel`和单向`channel`,双向`channel`即可发送数据又可接收数据,单向`channel`要么只能发送数据,要么只能接收数据。
|
||||
定义单向读`channel`
|
||||
```go
|
||||
var ch = make(chan int)
|
||||
type RChannel= <-chan int // 定义类型
|
||||
var rec RChannel = ch
|
||||
```
|
||||
定义单向写`channel`
|
||||
```go
|
||||
var ch = make(chan int)
|
||||
type SChannel = chan<- int // 定义类型
|
||||
var send SChannel = ch
|
||||
```
|
||||
注意写`channel`与读`channel`在定义的时候只是`<-`的位置不同,前者在`chan`关键字后面,后者在`chan`关键字前面。
|
||||
代码示例:
|
||||
```go
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
type SChannel = chan<- int
|
||||
type RChannel = <-chan int
|
||||
|
||||
func main() {
|
||||
var ch = make(chan int) // 创建channel
|
||||
|
||||
go func() {
|
||||
var send SChannel = ch
|
||||
fmt.Println("send: 100")
|
||||
send <- 100
|
||||
}()
|
||||
|
||||
go func() {
|
||||
var rec RChannel = ch
|
||||
num := <- rec
|
||||
fmt.Printf("receive: %d", num)
|
||||
}()
|
||||
time.Sleep(2*time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
send: 100
|
||||
receive: 100
|
||||
```
|
||||
创建一个`channel ch`,分别定义两个单向`channel`类型`SChannel`和`RChannel` ,根据别名类型给`ch`定义两个别名`send`和`rec`,一个只用于发送,一个只用于读取。
|
||||
|
||||
## 扩展
|
||||
`channel`非常重要,Go语言中有个重要思想:不以共享内存来通信,而以通信来共享内存。
|
||||
说得更直接点,协程之间可以利用`channel`来传递数据,如下的例子,可以看出父子协程如何通信的,父协程通过`channel`拿到了子协程执行的结果。
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func sum(s []int, c chan int) {
|
||||
sum := 0
|
||||
for _, v := range s {
|
||||
sum += v
|
||||
}
|
||||
c <- sum // send sum to c
|
||||
}
|
||||
|
||||
func main() {
|
||||
s := []int{7, 2, 8, -9, 4, 0}
|
||||
|
||||
c := make(chan int)
|
||||
go func() {
|
||||
sum(s[:len(s)/2], c)
|
||||
//time.Sleep(1 * time.Second)
|
||||
}()
|
||||
go sum(s[len(s)/2:], c)
|
||||
x, y := <-c, <-c // receive from c
|
||||
|
||||
fmt.Println(x, y, x+y)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
-5 17 12
|
||||
```
|
||||
`channel`又分为两类:有缓冲`channel` 和无缓冲`channel`,这个在前面的代码示例中也有简单的描述了。为了协程安全,无论是有无缓冲的`channel`,内部都会有一把锁来控制并发访问。同时`channel`底层一定有一个队列,来存储数据。
|
||||
无缓冲`channel`可以理解为同步模式,即写入一个,如果没有消费者在消费,写入就会阻塞。
|
||||
有缓冲`channel`可以理解为异步模式。即写入消息之后,即使还没被消费,只要队列没满,就可继续写入。如图所示:
|
||||
|
||||

|
||||
|
||||
这里可能会问,如果有缓冲`channel`队列满了,那不就退化到同步了么?是的,如果队列满了,发送还是会阻塞。
|
||||
|
||||

|
||||
|
||||
但是我们来反向思考下,如果有缓冲`channel`长期都处于满队列情况,那何必用有缓冲。所以预期在正常情况下,有缓冲`channel`都是异步交互的。
|
||||
|
||||
## channel实现锁操作
|
||||
前面分析了当缓冲队列满了以后,继续往`channel`里面写数据,就会阻塞,那么利用这个特性,我们可以实现一个`goroutine`之间的锁。(对并发安全比较模糊的可以把后面`sync`小节看完再来看这里)
|
||||
直接看示例
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func add(ch chan bool, num *int) {
|
||||
ch <- true
|
||||
*num = *num + 1
|
||||
<-ch
|
||||
}
|
||||
|
||||
func main() {
|
||||
// 创建一个size为1的channel
|
||||
ch := make(chan bool, 1)
|
||||
|
||||
var num int
|
||||
for i := 0; i < 100; i++ {
|
||||
go add(ch, &num)
|
||||
}
|
||||
|
||||
time.Sleep(2)
|
||||
fmt.Println("num 的值:", num)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
num 的值: 100
|
||||
```
|
||||
`ch <- true`和`<- ch`就相当于一个锁,将 `*num = *num + 1`这个操作锁住了。因为`ch`管道的容量是1,在每个`add`函数里都会往`channel`放置一个`true`,直到执行完+1操作之后才将`channel`里的`true`取出。由于`channel`的`size`是1,所以当一个`goroutine`在执行`add`函数的时候,其他`goroutine`执行`add`函数,执行到`ch <- true`的时候就会阻塞,`*num = *num + 1`不会成功,直到前一个+1操作完成,`<-ch`,读出了管道的元素,这样就实现了并发安全
|
||||
|
||||
|
||||
|
||||
## 小结
|
||||
- 关闭一个未初始化的`channel` 会产生`panic`
|
||||
- `channel`只能被关闭一次,对同一个`channel`重复关闭会产生`panic`
|
||||
- 向一个已关闭的 `channel` 发送消息会产生 `panic`
|
||||
- 从一个已关闭的`channel`读取消息不会发生`panic`,会一直读取所有数据,直到零值
|
||||
- `channel`可以读端和写端都可有多个`goroutine`操作,在一端关闭`channel`的时候,该`channel`读端的所有`goroutine` 都会收到`channel`已关闭的消息
|
||||
- `channel`是并发安全的,多个`goroutine`同时读取`channel`中的数据,不会产生并发安全问题
|
||||
|
||||
`channel`在我们的并发编程中发挥着巨大作用,使用起来也很方便,关于`channel`的具体实现原理可以到后面的Go语言原理篇学习。本章只介绍`channel`的具体用法
|
||||
@@ -0,0 +1,267 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- context
|
||||
- 并发
|
||||
---
|
||||
|
||||
# Context
|
||||
|
||||
## Context是什么
|
||||
`context`是Go语言在1.7版本中引入的一个标准库接口,其定义如下:
|
||||
```go
|
||||
type Context interface {
|
||||
Deadline() (deadline time.Time, ok bool)
|
||||
Done() <-chan struct{}
|
||||
Err() error
|
||||
Value(key interface{}) interface{}
|
||||
}
|
||||
```
|
||||
这个接口定义了四个方法:
|
||||
- `Deadline`: 设置 `context.Context` 被取消的时间,即截止时间
|
||||
- `Done`: 返回一个只读`Channel`,当Context被取消或者到达截止时间,这个`Channel`就会被关闭,表示Context的链路结束,多次调用`Done`方法会返回同一个`Channel`
|
||||
- `Err`: 返回`context.Context`结束的原因,它只会在`Done`返回的`Channel`被关闭时才会返回非空的值,返回值有以下两种情况:
|
||||
- 如果是`context.Context`被取消,返回`Canceled`
|
||||
- 如果是`context.Context`超时,返回`DeadlineExceeded`
|
||||
- `Value`: 从`context.Context`中获取键对应的值,类似于map的get方法,对于同一个context,多次调用`Value`并传入相同的Key会返回相同的结果,如果没有对应的key,则返回nil,键值对是通过`WithValue`方法写入的
|
||||
|
||||
## Context创建
|
||||
### 根Context创建
|
||||
主要有以下两种方式创建根context:
|
||||
```go
|
||||
context.Background()
|
||||
context.TODO()
|
||||
```
|
||||
|
||||
从源代码分析`context.Background`和`context.TODO`并没有太多的区别,都是用于创建根context,根context是一个空的context,不具备任何功能。但是一般情况下,如果当前函数没有上下文作为入参,我们都会使用`context.Background`创建一个根context作为起始的上下文向下传递。
|
||||
|
||||
### Context派生
|
||||
根`context`在创建之后,不具备任何的功能,为了让`context`在我们的程序中发挥作用,我们要依靠`context`包提供的`With`系列函数来进行派生。
|
||||
主要有以下几个派生函数:
|
||||
```go
|
||||
func WithCancel(parent Context) (ctx Context, cancel CancelFunc)
|
||||
func WithDeadline(parent Context, deadline time.Time) (Context, CancelFunc)
|
||||
func WithTimeout(parent Context, timeout time.Duration) (Context, CancelFunc)
|
||||
func WithValue(parent Context, key, val interface{}) Context
|
||||
```
|
||||
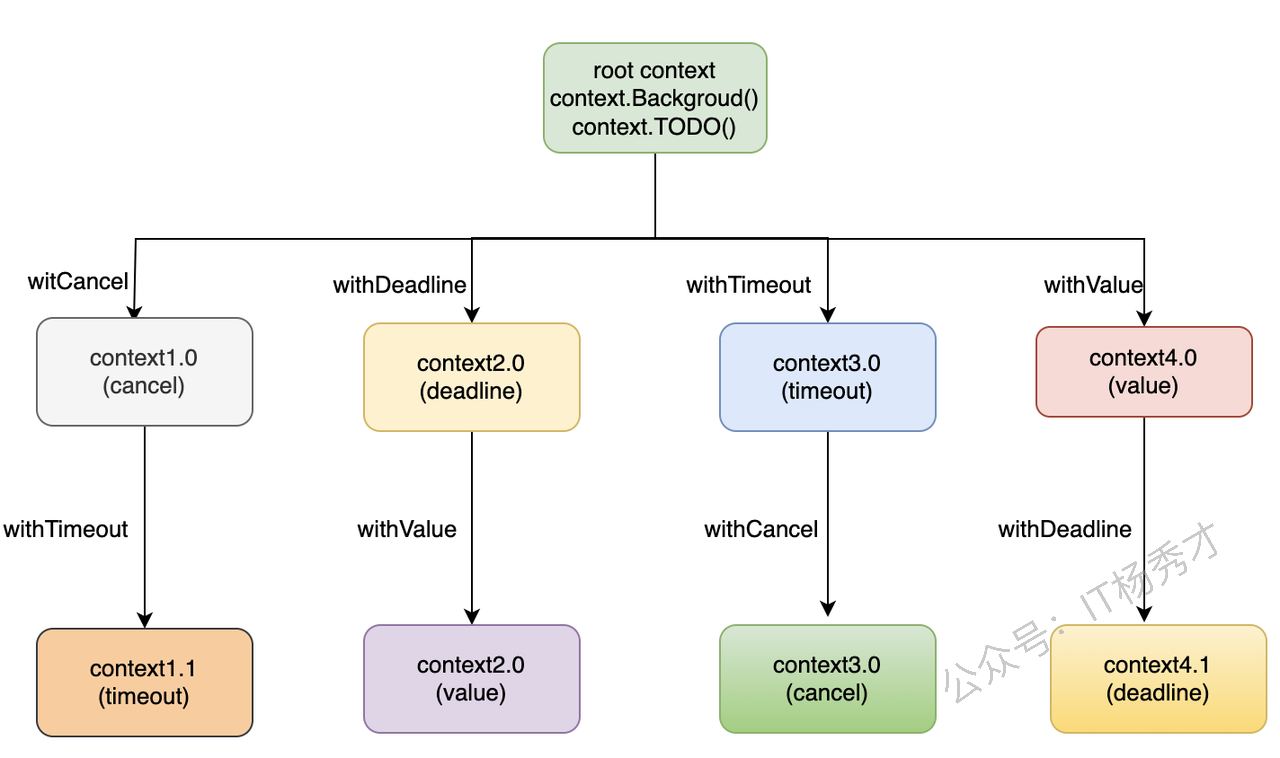
基于当前`context`,每个`with`函数都会创建出一个新的`context`,这样类似于我们熟悉的树结构,当前`context`称为父`context`,派生出的新`context`称为子`context`。就像下面的`context`树结构:
|
||||
|
||||
|
||||
|
||||
通过根`context`,通过四个`with`系列方法可以派生出四种类型的`context`,每种`context`又可以通过同样的方式调用`with`系列方法继续向下派生新的`context`,整个结构像一棵树。
|
||||
|
||||
## Context有什么用
|
||||
`context`主要有两个用途,也是在项目中经常使用的:
|
||||
1. 用于并发控制,控制协程的优雅退出
|
||||
2. 上下文的信息传递
|
||||
总的来说,`context`就是用来在父子`goroutine`间进行值传递以及发送`cancel`信号的一种机制。
|
||||
|
||||
### 并发控制
|
||||
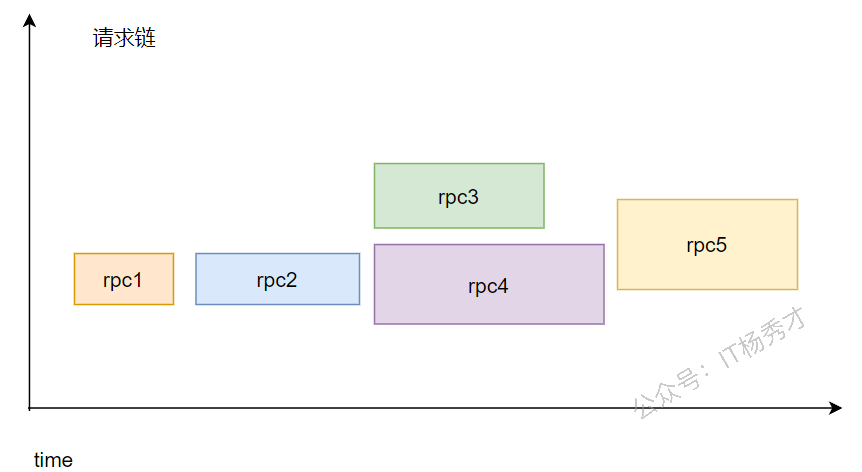
对于一般的服务器而言,都是一致运行着的,等待接收来自客户端或者浏览器的请求做出响应,思考这样一种场景,后台微服务架构中,一般服务器在收到一个请求之后,如果逻辑复杂,不会在一个`goroutine`中完成,而是会创建出很多的`goroutine`共同完成这个请求,就像下面这种情况:
|
||||
|
||||
|
||||
|
||||
有一个请求过来之后,先经过第一次`rpc`调用,然后再到`rpc2`,后面创建执行两个`rpc`,`rpc4`里又有一次`rpc`调用`rpc5`,等所有`rpc`调用成功后,返回结果。假如在整个调用过程中,`rpc1`发生了错误,如果没有`context`存在的话,我们还是得等所有的`rpc`都执行完才能返回结果,这样其实浪费了不少时间,因为一旦出错,我们完全可以直接在`rpc1`这里就返回结果了,不用等到后续的`rpc`都执行完。
|
||||
假设我们在`rpc1`直接返回失败,不等后续的`rpc`继续执行,那么其实后续的`rpc`执行就是没有意义的,浪费计算和IO资源而已。引入`context`之后,就可以很好的处理这个问题,在不需要子`goroutine`执行的时候,可以通过`context`通知子`goroutine`优雅的关闭。
|
||||
|
||||
#### context.WithCancel
|
||||
方法定义如下:
|
||||
```go
|
||||
func WithCancel(parent Context) (ctx Context, cancel CancelFunc)
|
||||
```
|
||||
`context.WithCancel`函数是一个取消控制函数,只需要一个`context`作为参数,能够从`context.Context`中衍生出一个新的子`context`和取消函数`CancelFunc`,通过将这个子`context`传递到新的`goroutine`中来控制这些`goroutine`的关闭,一旦我们执行返回的取消函数`CancelFunc`,当前上下文以及它的子上下文都会被取消,所有的`Goroutine`都会同步收到取消信号。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"context"
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ctx, cancel := context.WithCancel(context.Background())
|
||||
go Watch(ctx, "goroutine1")
|
||||
go Watch(ctx, "goroutine2")
|
||||
|
||||
time.Sleep(6 * time.Second) // 让goroutine1和goroutine2执行6s
|
||||
fmt.Println("end watching!!!")
|
||||
cancel() // 通知goroutine1和goroutine2关闭
|
||||
time.Sleep(1 * time.Second)
|
||||
}
|
||||
|
||||
func Watch(ctx context.Context, name string) {
|
||||
for {
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
fmt.Printf("%s exit!\n", name) // 主goroutine调用cancel后,会发送一个信号到ctx.Done()这个channel,这里就会收到信息
|
||||
return
|
||||
default:
|
||||
fmt.Printf("%s watching...\n", name)
|
||||
time.Sleep(time.Second)
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
goroutine2 watching...
|
||||
goroutine1 watching...
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
goroutine2 watching...
|
||||
goroutine1 watching...
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
goroutine2 watching...
|
||||
goroutine1 watching...
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
end watching!!!
|
||||
goroutine1 exit!
|
||||
goroutine2 exit!
|
||||
```
|
||||
`ctx, cancel := context.WithCancel(context.Background())`派生出了一个带有返回函数`cancel`的`ctx`,并把它传入到子`goroutine`中,接下来在6s时间内,由于没有执行`cancel`函数,子`goroutine`将一直执行`default`语句,打印监控。6s之后,调用`cancel`,此时子`goroutine`会从`ctx.Done()`这个`channel`中收到消息,执行`return`结束。
|
||||
|
||||
#### context.WithDeadline
|
||||
方法定义如下:
|
||||
```go
|
||||
func WithDeadline(parent Context, d time.Time) (Context, CancelFunc)
|
||||
```
|
||||
`context.WithDeadline`也是一个取消控制函数,方法有两个参数,第一个参数是一个`context`,第二个参数是截止时间,同样会返回一个子`context`和一个取消函数`CancelFunc`。在使用的时候,没有到截止时间,我们可以通过手动调用`CancelFunc`来取消子`context`,控制子`goroutine`的退出,如果到了截止时间,我们都没有调用`CancelFunc`,子`context`的`Done()`管道也会收到一个取消信号,用来控制子`goroutine`退出。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"context"
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ctx, cancel := context.WithDeadline(context.Background(),time.Now().Add(4*time.Second)) // 设置超时时间4当前时间4s之后
|
||||
defer cancel()
|
||||
go Watch(ctx, "goroutine1")
|
||||
go Watch(ctx, "goroutine2")
|
||||
|
||||
time.Sleep(6 * time.Second) // 让goroutine1和goroutine2执行6s
|
||||
fmt.Println("end watching!!!")
|
||||
}
|
||||
|
||||
func Watch(ctx context.Context, name string) {
|
||||
for {
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
fmt.Printf("%s exit!\n", name) // 4s之后收到信号
|
||||
return
|
||||
default:
|
||||
fmt.Printf("%s watching...\n", name)
|
||||
time.Sleep(time.Second)
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
goroutine2 watching...
|
||||
goroutine1 watching...
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
goroutine1 exit!
|
||||
goroutine2 exit!
|
||||
end watching!!!
|
||||
```
|
||||
我们并没有调用`cancel`函数,但是在过了4s之后,子`groutine`里`ctx.Done()`收到了信号,打印出`exit`,子`goroutine`退出,这就是`WithDeadline`派生子`context`的用法。
|
||||
|
||||
#### context.WithTimeout
|
||||
方法定义:
|
||||
```go
|
||||
func WithTimeout(parent Context, timeout time.Duration) (Context, CancelFunc)
|
||||
```
|
||||
`context.WithTimeout`和`context.WithDeadline`的作用类似,都是用于超时取消子`context`,只是传递的第二个参数有所不同,`context.WithTimeout`传递的第二个参数不是具体时间,而是时间长度。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"context"
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ctx, cancel := context.WithTimeout(context.Background(), 4*time.Second)
|
||||
defer cancel()
|
||||
go Watch(ctx, "goroutine1")
|
||||
go Watch(ctx, "goroutine2")
|
||||
|
||||
time.Sleep(6 * time.Second) // 让goroutine1和goroutine2执行6s
|
||||
fmt.Println("end watching!!!")
|
||||
}
|
||||
|
||||
func Watch(ctx context.Context, name string) {
|
||||
for {
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
fmt.Printf("%s exit!\n", name) // 主goroutine调用cancel后,会发送一个信号到ctx.Done()这个channel,这里就会收到信息
|
||||
return
|
||||
default:
|
||||
fmt.Printf("%s watching...\n", name)
|
||||
time.Sleep(time.Second)
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
goroutine2 watching...
|
||||
goroutine1 watching...
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
goroutine2 watching...
|
||||
goroutine1 watching...
|
||||
goroutine1 watching...
|
||||
goroutine2 watching...
|
||||
goroutine1 exit!
|
||||
goroutine2 exit!
|
||||
end watching!!!
|
||||
```
|
||||
程序很简单,与上个`context.WithDeadline`的样例代码基本一样,只是改变了下派生`context`的方法为`context.WithTimeout`,具体体现在第二个参数不再是具体时间,而是变为了4s这个具体的时间长度,执行结果也是一样。
|
||||
|
||||
#### context.WithValue
|
||||
方法定义:
|
||||
```go
|
||||
func WithValue(parent Context, key, val interface{}) Context
|
||||
```
|
||||
`context.WithValue`函数从父`context`中创建一个子`context`用于传值,函数参数是父`context`,`key`,`val`键值对。返回一个`context`。
|
||||
项目中这个方法一般用于上下文信息的传递,比如请求唯一`id`,以及`trace_id`等,用于链路追踪以及配置透传。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"context"
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func func1(ctx context.Context) {
|
||||
fmt.Printf("name is: %s", ctx.Value("name").(string))
|
||||
}
|
||||
|
||||
func main() {
|
||||
ctx := context.WithValue(context.Background(), "name", "zhangsan")
|
||||
go func1(ctx)
|
||||
time.Sleep(time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
name is: zhangsan
|
||||
```
|
||||
@@ -0,0 +1,112 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶语法
|
||||
- Goroutine
|
||||
---
|
||||
|
||||
# Goroutine
|
||||
`goroutine`是Go语言对于协程的支持,可以把它理解为Go语言的协程。这是一个Go语言并发编程的终极杀器,它让我们的并发编程变得简单。
|
||||
|
||||
Go语言的并发只会用到`goroutine`,并不需要我们去考虑用多进程或者是多线程。有过C++或者Java经验的同学可能知道,线程本身是有一定大小的,一般OS线程栈大小为2MB,且线程在创建和上下文切换的时候是需要消耗资源的,会带来性能损耗,所以在我们用到多线程技术的时候,我们往往会通过池化技术,即创建线程池来管理一定数量的线程。
|
||||
在Go语言中,一个`goroutine`栈在其生命周期开始时占用空间很小(一般2KB),并且栈大小可以按需增大和缩小,`goroutine`的栈大小限制可以达到1GB,但是一般不会用到这么大。所以在Go语言中一次创建成千上万,甚至十万左右的`goroutine`理论上也是可以的。
|
||||
在Go语言中,我们用多`goroutine`来完成并发,在某个任务需要并发执行的时候,只需要把这个任务包装成一个函数,开启一个`goroutine`去执行这个函数就可以了。并不需要我们来维护一个类似于线程池的东西,也不需要我们去关心协程是怎么切换和调度的,因为这些都已经有Go语言内置的调度器帮我们做了,并且效率还非常高。
|
||||
|
||||
## Goroutine使用
|
||||
`goroutine`使用起来非常方便,通常我们会将需要并发的任务封装成一个函数,然后再该函数前加上`go`关键字就行了,这样就开启了一个`goroutine`。
|
||||
```go
|
||||
func()
|
||||
go func() // 会并发执行这个函数
|
||||
```
|
||||
|
||||
## 主协程
|
||||
和其它语言一样,Go程序的入口也是`main`函数。在程序开始执行的时候,Go程序会为`main`函数创建一个默认的`goroutine`,我们称之为主协程,我们后来人为的创建的一些`goroutine`,都是在这个主`goroutine`的基础上进行的。
|
||||
下面请看个例子:
|
||||
```go
|
||||
package main
|
||||
|
||||
import "fmt"
|
||||
|
||||
func myGroutine() {
|
||||
fmt.Println("myGroutine")
|
||||
}
|
||||
|
||||
func main() {
|
||||
go myGroutine()
|
||||
fmt.Println("end!!!")
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
end!!!
|
||||
myGroutine
|
||||
```
|
||||
很奇怪,明明是多协程任务,为什么只打印了主协程里的"end!!!",而没有打印我们开启的协程里的输出"myGroutine",按理不是应该都打印出来吗?
|
||||
这是因为:当`main`函数返回的时候该`goroutine`就结束了,当主协程退出的时候,其他剩余的`goroutine`不管是否运行完,都会跟着结束。所以,这里主协程打印完"end!!!"之后就退出了,`myGroutine`协程可能还没运行到`fmt.Println("myGroutine")`语句也跟着退出了。
|
||||
接下来我们让主`goroutine`执行完`fmt.Println("end!!!")`之后不立刻退出,而是等待2s,看一下运行结果:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func myGroutine() {
|
||||
fmt.Println("myGroutine")
|
||||
}
|
||||
|
||||
func main() {
|
||||
go myGroutine()
|
||||
fmt.Println("end!!!")
|
||||
time.Sleep(2*time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
end!!!
|
||||
myGroutine
|
||||
```
|
||||
此时打印出了我们想要的结果,这里我们通过让主协程睡眠2s来等待子协程执行完了之后再退出,后面我们会学习到更好的方法,这里就不再过多阐述。
|
||||
|
||||
## 多协程调用
|
||||
在Go语言中,我们可以通过`go`关键字来开启多个协程,每个协程可以并发执行,互不干扰。
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
"time"
|
||||
)
|
||||
|
||||
func myGoroutine(name string, wg *sync.WaitGroup) {
|
||||
defer wg.Done()
|
||||
|
||||
for i := 0; i < 5; i++ {
|
||||
fmt.Printf("myGroutine %s\n", name)
|
||||
time.Sleep(10 * time.Millisecond)
|
||||
}
|
||||
}
|
||||
|
||||
func main() {
|
||||
var wg sync.WaitGroup
|
||||
wg.Add(2)
|
||||
|
||||
go myGoroutine("goroutine1", &wg)
|
||||
go myGoroutine("goroutine2", &wg)
|
||||
|
||||
wg.Wait()
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
myGroutine goroutine1
|
||||
myGroutine goroutine2
|
||||
```
|
||||
从结果中可以看到,两个协程并发执行,互不干扰。注意在上述例子中,我们使用了`sync.WaitGroup`来等待所有协程执行完毕之后再退出。关于`sync.WaitGroup`的详细介绍,可以参考[sync.WaitGroup](https://pkg.go.dev/sync#WaitGroup)。后续也会在`sync`章节详细介绍。
|
||||
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,190 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- select
|
||||
- 并发
|
||||
---
|
||||
|
||||
# Select
|
||||
|
||||
## select是什么
|
||||
`select`是Go语言层面提供的一种多路复用机制,用于检测当前`goroutine`连接的多个`channel`是否有数据准备完毕,可用于读或写。
|
||||
|
||||
## IO多路复用
|
||||
看到`select`,很自然的会联想到Linux提供的IO多路复用模型:`select`、`poll`、`epoll`,IO复用主要用于提升程序处理IO事件的性能。Go语言中的`select`与Linux中的`select`有一定的区别。操作系统中的IO多路复用简单理解就是用一个或者是少量线程处理多个IO事件。
|
||||
|
||||
### 传统阻塞IO vs IO多路复用
|
||||
|
||||
#### 传统阻塞IO
|
||||
对于每一个网络IO事件,操作系统都会起一个线程去处理,在IO事件没准备好的时候,当前线程就会一直阻塞。
|
||||
|
||||

|
||||
|
||||
优缺点:
|
||||
- 优点:逻辑简单,在阻塞等待期间线程会挂起,不会占用 CPU 资源
|
||||
- 缺点:每个连接需要独立的线程单独处理,当并发请求量大时为了维护程序,内存、线程切换开销较大
|
||||
|
||||
#### IO多路复用
|
||||
IO多路复用的基本原理如下图所示:
|
||||
|
||||

|
||||
|
||||
优缺点:
|
||||
- 优点:通过复用一个线程处理了多个IO事件,无需对额外过多的线程维护管理,资源和效率上都获得了提升
|
||||
- 缺点:当连接数较少时效率相比多线程+阻塞 I/O 模型效率较低
|
||||
|
||||
Go语言的`select`语句,是用来起一个`goroutine`监听多个`Channel`的读写事件,提高从多个`Channel`获取信息的效率,相当于也是单线程处理多个IO事件,其思想基本相同。
|
||||
|
||||
## select用法
|
||||
`select`的基本使用模式如下:
|
||||
```go
|
||||
select {
|
||||
case <- channel1: // 如果从channel1读取数据成功,执行case语句
|
||||
do ...
|
||||
case channel2 <- 1: // 如果向channel2写入数据成功,执行case语句
|
||||
do ...
|
||||
default: // 如果上面都没有成功,进入default处理流程
|
||||
do ...
|
||||
}
|
||||
```
|
||||
可以看到,`select`的用法形式类似于`switch`,但是区别于`switch`的是,`select`各个`case`的表达式必须都是`channel`的读写操作。`select`通过多个`case`语句监听多个`channel`的读写操作是否准备好可以执行,其中任何一个`case`可以执行了则选择该`case`语句执行,如果没有可以执行的`case`,则执行`default`语句,如果没有`default`,则当前`goroutine`会阻塞。
|
||||
|
||||
### 空select永久阻塞
|
||||
当一个`select`中什么语句都没有,没有任何`case`,将会永久阻塞:
|
||||
```go
|
||||
package main
|
||||
|
||||
func main() {
|
||||
select {
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
fatal error: all goroutines are asleep - deadlock!
|
||||
```
|
||||
程序因为`select`语句导致永久阻塞,当前`goroutine`阻塞之后,由于Go语言自带死锁检测机制,发现当前`goroutine`永远不会被唤醒,会报上述死锁错误。
|
||||
|
||||
### 没有default且case无法执行的select永久阻塞
|
||||
看下面示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch1 := make(chan int, 1)
|
||||
ch2 := make(chan int, 1)
|
||||
select {
|
||||
case <-ch1:
|
||||
fmt.Printf("received from ch1")
|
||||
case num := <-ch2:
|
||||
fmt.Printf("num is: %d", num)
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
fatal error: all goroutines are asleep - deadlock!
|
||||
```
|
||||
程序中 `select`从两个`channel`,`ch1`和`ch2`中读取数据,但是两个`channel`都没有数据,且没有`goroutine`往里面写数据,所以不可能读到数据,这两个`case`永远无法执行到,`select`也没有`default`,所以会出现永久阻塞,报死锁。
|
||||
|
||||
### 有单一case和default的select
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch := make(chan int, 1)
|
||||
select {
|
||||
case <-ch:
|
||||
fmt.Println("received from ch")
|
||||
default:
|
||||
fmt.Println("default!!!")
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
default!!!
|
||||
```
|
||||
执行到`select`语句的时候,由于`ch`中没有数据,且没有`goroutine`往`channel`中写数据,所以`case`不可能执行到,就会执行`default`语句,打印出`default!!!`。
|
||||
|
||||
### 有多个case和default的select
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch1 := make(chan int, 1)
|
||||
ch2 := make(chan int, 1)
|
||||
go func() {
|
||||
time.Sleep(time.Second)
|
||||
for i := 0; i < 3; i++ {
|
||||
select {
|
||||
case v := <-ch1:
|
||||
fmt.Printf("Received from ch1, val = %d\n", v)
|
||||
case v := <-ch2:
|
||||
fmt.Printf("Received from ch2, val = %d\n", v)
|
||||
default:
|
||||
fmt.Println("default!!!")
|
||||
}
|
||||
time.Sleep(time.Second)
|
||||
}
|
||||
}()
|
||||
ch1 <- 1
|
||||
time.Sleep(time.Second)
|
||||
ch2 <- 2
|
||||
time.Sleep(4 * time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
Received from ch1, val = 1
|
||||
Received from ch2, val = 2
|
||||
default!!!
|
||||
```
|
||||
主`goroutine`中向后往管道`ch1`和`ch2`中发送数据,在子`goroutine`中执行两个`select`,可以看到,在执行`select`的时候,那个`case`准备好了就会执行当下`case`的语句,最后没有数据可接受了,没有`case`可以执行,则执行`default`语句。
|
||||
|
||||
> 注意:当多个case都准备好了的时候,会随机选择一个执行
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch1 := make(chan int, 1)
|
||||
ch2 := make(chan int, 1)
|
||||
ch1 <- 5
|
||||
ch2 <- 6
|
||||
select {
|
||||
case v := <-ch1:
|
||||
fmt.Printf("Received from ch1, val = %d\n", v)
|
||||
case v := <-ch2:
|
||||
fmt.Printf("Received from ch2, val = %d\n", v)
|
||||
default:
|
||||
fmt.Println("default!!!")
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
Received from ch2, val = 6
|
||||
```
|
||||
多次执行,2个`case`都有可能打印,这就是`select`选择的随机性。
|
||||
|
||||
|
||||
@@ -0,0 +1,768 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- sync
|
||||
- 并发安全
|
||||
---
|
||||
|
||||
# sync包
|
||||
在前面学习`channel`的时候,我们说到在Go语言并发编程中,倡导使用通信共享内存,不要使用共享内存通信,`goroutine`之间尽量通过`channel`来协作。而在其他的传统语言中,都是通过共享内存加上锁机制来保证并发安全的,同样Go语言也提供了对共享内存并发安全机制的支持,这些功能都存在于`sync`包下。
|
||||
|
||||
## sync.WaitGroup
|
||||
在前面很多`goroutine`的示例中,我们都是通过`time.Sleep()`方法让主`goroutine`等待一段时间以便子`gortoutine`能够执行完打印结果,显然这不是一个很好的办法,因为我们不知道所有的子`gortoutine`要多久才能执行完,不能确切的知道需要等待多久。那要怎么处理呢?
|
||||
|
||||
### 使用channel实现等待
|
||||
看下面例子:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch := make(chan struct{}, 10)
|
||||
for i := 0; i < 10; i++ {
|
||||
go func(i int) {
|
||||
fmt.Printf("num:%d\n",i)
|
||||
ch <- struct{}{}
|
||||
}(i)
|
||||
}
|
||||
|
||||
for i := 0; i < 10; i++ {
|
||||
<-ch
|
||||
}
|
||||
|
||||
fmt.Println("end")
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
num:0
|
||||
num:2
|
||||
num:1
|
||||
num:4
|
||||
num:6
|
||||
num:7
|
||||
num:5
|
||||
num:8
|
||||
num:9
|
||||
num:3
|
||||
end
|
||||
```
|
||||
我们在每个`goroutine`中,向管道里发送一条数据,这样我们在程序最后,通过`for`循环将管道里的数据全部取出,直到数据全部取出完毕才能继续后面的逻辑,这样就可以实现等待各个`goroutine`执行完。
|
||||
但是,这样使用`channel`显得并不优雅,其次,我们得知道具体循环的次数,来创建管道的大小,假设次数非常的多,则需要申请同样数量大小的管道出来,对内存也是不小的开销。
|
||||
|
||||
### 使用WaitGroup实现等待
|
||||
这里我们可以用`sync`包下的`WaitGroup`来实现,Go语言中可以使用`sync.WaitGroup`来实现并发任务的同步以及协程任务等待。
|
||||
`sync.WaitGroup`是一个对象,里面维护者一个计数器,并且通过三个方法来配合使用:
|
||||
- (wg * WaitGroup) Add(delta int) 计数器加delta
|
||||
- (wg *WaitGroup) Done() 计数器减1
|
||||
- (wg *WaitGroup) Wait() 会阻塞代码的运行,直至计数器减为0
|
||||
先看示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
var wg sync.WaitGroup
|
||||
|
||||
func myGoroutine() {
|
||||
defer wg.Done()
|
||||
fmt.Println("myGoroutine!")
|
||||
}
|
||||
|
||||
func main() {
|
||||
wg.Add(10)
|
||||
for i := 0; i < 10; i++ {
|
||||
go myGoroutine()
|
||||
}
|
||||
wg.Wait()
|
||||
fmt.Println("end!!!")
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
```
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
myGoroutine!
|
||||
end!!!
|
||||
```
|
||||
程序首先把`wg`的计数设置为10,每个`for`循环运行完毕都把计数器减1,`main`函数中执行到`wg.Wait()`会一直阻塞,直到`wg`的计数器为零。最后打印了10个`myGoroutine!`,是所有子`goroutine`任务结束后主`goroutine`才退出。
|
||||
**注意:`sync.WaitGroup`对象的计数器不能为负数,否则会panic,在使用的过程中,我们需要保证`add()`的参数值,以及执行完`Done()`之后计数器大于等于零**
|
||||
|
||||
## sync.Once
|
||||
在我们写项目的时候,程序中有很多的逻辑只需要执行一次,最典型的就是项目工程里配置文件的加载,我们只需要加载一次即可,让配置保存在内存中,下次使用的时候直接使用内存中的配置数据即可。这里就要用到`sync.Once`。
|
||||
`sync.Once`可以在代码的任意位置初始化和调用,并且线程安全。`sync.Once`最大的作用就是延迟初始化,对于一个`sync.Once`变量我们并不会在程序启动的时候初始化,而是在第一次用的它的时候才会初始化,并且只初始化这一次,初始化之后驻留在内存里,这就非常适合我们之前提到的配置文件加载场景,设想一下,如果是在程序刚开始就加载配置,若迟迟未被使用,则既浪费了内存,又延长了程序加载时间,而`sync.Once`就刚好解决了这个问题。
|
||||
使用示例:
|
||||
```go
|
||||
// 声明配置结构体Config
|
||||
type Config struct{}
|
||||
|
||||
var instance *Config
|
||||
var once sync.Once // 声明一个sync.Once变量
|
||||
|
||||
// 获取配置结构体
|
||||
func InitConfig() *Config {
|
||||
once.Do(func(){
|
||||
instance = &Config{}
|
||||
})
|
||||
return instance
|
||||
}
|
||||
```
|
||||
只有在第一次调用InitConfig()获取Config 指针的时候才会执行once.Do(func(){instance = &Config{} })语句,执行完之后instance就驻留在内存中,后面再次执行InitConfig()的时候,就直接返回内存中的instance。
|
||||
|
||||
### sync.Once与init()的区别
|
||||
有时候我们使用init()方法进行初始化,init()方法是在其所在的package首次加载时执行的,而sync.Once可以在代码的任意位置初始化和调用,是在第一次用的它的时候才会初始化。
|
||||
|
||||
## sync.Lock
|
||||
说到并发编程,就不得不谈一个老生常谈的问题,那就是资源竞争,也就是我们这节要讲的并发安全。因为一旦开启了多个`goroutine`去处理问题,那么这些`goroutine`就有可能在同一时间操作同一个系统资源,比如同一个变量,同一份文件等等,这里我们如果不加控制的话,可能会出现并发安全问题,在Go语言中,有两种方式来控制并发安全,锁和原子操作
|
||||
举个例子,看下面代码
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
var (
|
||||
num int
|
||||
wg = sync.WaitGroup{}
|
||||
)
|
||||
|
||||
func add() {
|
||||
defer wg.Done()
|
||||
num += 1
|
||||
}
|
||||
|
||||
func main() {
|
||||
var n = 10 * 10 * 10 * 10
|
||||
wg.Add(n)
|
||||
|
||||
for i := 0; i < n; i++ {
|
||||
// 启动n个goroutine去累加num
|
||||
go add()
|
||||
}
|
||||
|
||||
// 等待所有goroutine执行完毕
|
||||
wg.Wait()
|
||||
|
||||
// 不出意外的话,num应该等于n,但是,但是,但是实际上不一致!
|
||||
fmt.Println(num == n)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
false
|
||||
```
|
||||
我们用`n`(这里是10000,可以自行修改,尽量数字大一点)个`goroutine`去给`num`做累加,最后并`num`并不等于`n`,这就是并发问题,同一时间有多个`goroutine`都在对`num`做`+1`操作,但是后一个并不是在前一次执行完的基础之上运行的,可能两次运行`num`的初始相同,这样前一个`num+1`的结果就被后一个覆盖了,看起来好像只做了一个加法。为了避免类似的并发安全问题,我们一般会采用下面两种方式处理,在go语言中并发相关的都在`sync`包下面。
|
||||
|
||||
### 锁
|
||||
#### 互斥锁Mutex
|
||||
互斥锁是一种最常用的控制并发安全的方式,它在同一时间只允许一个goroutine对共享资源进行访问。
|
||||
互斥锁的声明方式如下:
|
||||
```go
|
||||
var lock sync.Mutex
|
||||
```
|
||||
互斥锁有两个方法
|
||||
```go
|
||||
func (m *Mutex) Lock() // 加锁
|
||||
func (m *Mutex) Unlock() // 解锁
|
||||
```
|
||||
一个互斥锁只能同时被一个`goroutine`锁定,其它`goroutine`将阻塞直到互斥锁被解锁才能加锁成功。`sync.Mutex`在使用的时候要注意:**对一个未锁定的互斥锁解锁将会产生运行时错误**。
|
||||
对上面的例子稍作修改,加上互斥锁:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
var (
|
||||
num int
|
||||
wg = sync.WaitGroup{}
|
||||
// 我们用锁来保证num的并发安全
|
||||
mu = sync.Mutex{}
|
||||
)
|
||||
|
||||
func add() {
|
||||
mu.Lock()
|
||||
defer wg.Done()
|
||||
num += 1
|
||||
mu.Unlock()
|
||||
}
|
||||
|
||||
func main() {
|
||||
var n = 10 * 10 * 10 * 10
|
||||
wg.Add(n)
|
||||
|
||||
for i := 0; i < n; i++ {
|
||||
// 启动n个goroutine去累加num
|
||||
go add()
|
||||
}
|
||||
|
||||
// 等待所有goroutine执行完毕
|
||||
wg.Wait()
|
||||
|
||||
fmt.Println(num == n)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
true
|
||||
```
|
||||
我们可以自行修改n的值,在我们能开启足够多的`goroutine`的情况下,他结果一定会是`true`。
|
||||
本例使用了前面介绍的`sync.WaitGroup`来等待所有协程执行结束。并且在`add`函数里使用了互斥锁来保证`num += 1`操作的并发安全,但是注意不要忘了用`mu.Unlock`来进行解锁,否则其他`goroutine`将一直等待加锁造成阻塞。
|
||||
|
||||
|
||||
#### 读写锁RWMutex
|
||||
读写锁就是将读操作和写操作分开,可以分别对读和写进行加锁,一般用在大量读操作、少量写操作的情况。
|
||||
读写锁的声明方式如下:
|
||||
```go
|
||||
var rw sync.RWMutex
|
||||
```
|
||||
读写锁有两个方法:
|
||||
```go
|
||||
func (rw *RWMutex) Lock() // 对写锁加锁
|
||||
func (rw *RWMutex) Unlock() // 对写锁解锁
|
||||
|
||||
func (rw *RWMutex) RLock() // 对读锁加锁
|
||||
func (rw *RWMutex) RUnlock() // 对读锁解锁
|
||||
```
|
||||
读写锁的使用遵循以下几个法则:
|
||||
1. 同时只能有一个 goroutine 能够获得写锁定。
|
||||
2. 同时可以有任意多个 gorouinte 获得读锁定。
|
||||
3. 同时只能存在写锁定或读锁定(读和写互斥)。
|
||||
通俗理解就是可以多个`goroutine`同时读,但是只有一个`goroutine`能写,共享资源要么在被一个或多个`goroutine`读取,要么在被一个`goroutine`写入, 读写不能同时进行。
|
||||
读写锁示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
"time"
|
||||
)
|
||||
|
||||
var cnt = 0
|
||||
|
||||
func main() {
|
||||
var mr sync.RWMutex
|
||||
for i := 1; i <= 3; i++ {
|
||||
go write(&mr, i)
|
||||
}
|
||||
for i := 1; i <= 3; i++ {
|
||||
go read(&mr, i)
|
||||
}
|
||||
|
||||
time.Sleep(time.Second)
|
||||
fmt.Println("final count:", cnt)
|
||||
}
|
||||
|
||||
func read(mr *sync.RWMutex, i int) {
|
||||
fmt.Printf("goroutine%d reader start\n", i)
|
||||
mr.RLock()
|
||||
fmt.Printf("goroutine%d reading count:%d\n", i, cnt)
|
||||
time.Sleep(time.Millisecond)
|
||||
mr.RUnlock()
|
||||
|
||||
fmt.Printf("goroutine%d reader over\n", i)
|
||||
}
|
||||
|
||||
func write(mr *sync.RWMutex, i int) {
|
||||
fmt.Printf("goroutine%d writer start\n", i)
|
||||
mr.Lock()
|
||||
cnt++
|
||||
fmt.Printf("goroutine%d writing count:%d\n", i, cnt)
|
||||
time.Sleep(time.Millisecond)
|
||||
mr.Unlock()
|
||||
|
||||
fmt.Printf("goroutine%d writer over\n", i)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
goroutine3 reader start
|
||||
goroutine3 reading count:0
|
||||
goroutine1 writer start
|
||||
goroutine2 writer start
|
||||
goroutine1 reader start
|
||||
goroutine2 reader start
|
||||
goroutine3 writer start
|
||||
goroutine3 reader over
|
||||
goroutine1 writing count:1
|
||||
goroutine1 writer over
|
||||
goroutine1 reading count:1
|
||||
goroutine2 reading count:1
|
||||
goroutine2 reader over
|
||||
goroutine2 writing count:2
|
||||
goroutine1 reader over
|
||||
goroutine2 writer over
|
||||
goroutine3 writing count:3
|
||||
goroutine3 writer over
|
||||
final count: 3
|
||||
```
|
||||
简单分析:首先`goroutine3`开始加了读锁,开始读取,读到count的值为0,然后`goroutine1`尝试写入,`goroutine2`尝试写入,但是都会阻塞,因为`goroutine3`加了读锁,不能再加写锁,在第8行`goroutine3` 读取完毕之后,`goroutine1`争抢到了锁,加了写锁,写完释放写锁之后,`goroutine1`和`goroutine2`同时加了读锁,读到count的值为1。可以看到读写锁是互斥的,写写锁是互斥的,读读锁可以一起加。
|
||||
|
||||
|
||||
#### 死锁
|
||||
提到锁,就有一个绕不开的话题:死锁。死锁就是一种状态,当两个或以上的`goroutine`在执行过程中,因争夺共享资源处在互相等待的状态,如果没有外部干涉将会一直处于这种阻塞状态,我们称这时的系统发生了死锁。思索场景一般有以下两种
|
||||
1. **Lock/Unlock不成对**。这类情况最常见的场景就是对锁进行拷贝使用
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
func main() {
|
||||
var mu sync.Mutex
|
||||
mu.Lock()
|
||||
defer mu.Unlock()
|
||||
copyMutex(mu)
|
||||
}
|
||||
|
||||
func copyMutex(mu sync.Mutex) {
|
||||
mu.Lock()
|
||||
defer mu.Unlock()
|
||||
fmt.Println("ok")
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
fatal error: all goroutines are asleep - deadlock!
|
||||
|
||||
goroutine 1 [semacquire]:
|
||||
sync.runtime_SemacquireMutex(0xc0000160ac, 0x0, 0x1)
|
||||
D:/Program Files/Go/src/runtime/sema.go:71 +0x4e
|
||||
sync.(*Mutex).lockSlow(0xc0000160a8)
|
||||
D:/Program Files/Go/src/sync/mutex.go:138 +0x10f
|
||||
sync.(*Mutex).Lock(...)
|
||||
D:/Program Files/Go/src/sync/mutex.go:81
|
||||
main.copyTest(0xc0000160a8)
|
||||
```
|
||||
会报死锁,为什么呢?有的同学可能会注意到,这里`mu sync.Mutex`当作参数传入到函数`copyMutex`,锁进行了拷贝,不是原来的锁变量了,那么一把新的锁,在执行`mu.Lock()`的时候应该没问题。这就是要注意的地方,如果将带有锁结构的变量赋值给其他变量,锁的状态会复制。所以多锁复制后的新的锁拥有了原来的锁状态,那么在`copyMutex`函数内执行`mu.Lock()`的时候会一直阻塞,因为外层的`main`函数已经`Lock()`了一次,但是并没有机会`Unlock()`,导致内层函数会一直等待`Lock()`,而外层函数一直等待`Unlock()`,这样就造成了死锁
|
||||
所以在使用锁的时候,我们应当尽量避免锁拷贝,并且保证Lock()和Unlock()成对出现,没有成对出现容易会出现死锁的情况,或者是Unlock 一个未加锁的Mutex而导致 panic。尽量养成如下使用习惯
|
||||
```go
|
||||
mu.Lock()
|
||||
defer mu.Unlock()
|
||||
```
|
||||
|
||||
2. **循环等待**
|
||||
另一个容易造成死锁的场景就是循环等待,A等B,B等C,C等A,循环等待
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"sync"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
var mu1, mu2 sync.Mutex
|
||||
var wg sync.WaitGroup
|
||||
|
||||
wg.Add(2)
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
mu1.Lock()
|
||||
defer mu1.Unlock()
|
||||
time.Sleep(1 * time.Second)
|
||||
|
||||
mu2.Lock()
|
||||
defer mu2.Unlock()
|
||||
}()
|
||||
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
mu2.Lock()
|
||||
defer mu2.Unlock()
|
||||
time.Sleep(1 * time.Second)
|
||||
mu1.Lock()
|
||||
defer mu1.Unlock()
|
||||
}()
|
||||
wg.Wait()
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
fatal error: all goroutines are asleep - deadlock!
|
||||
```
|
||||
死锁了,代码很简单,两个`goroutine`,一个`goroutine`先锁`mu1`,再锁`mu2`,另一个`goroutine`先锁`mu2`,再锁`mu1`,但是在它们进行第二次枷锁操作的时候,彼此等待对方释放锁,这样就造成了循环等待,一直阻塞,形成死锁。
|
||||
|
||||
## sync.Map
|
||||
Go语言内置的Map并不是并发安全的,在多个`goroutine`同时操作map的时候,会有并发问
|
||||
具体看下面例子
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"strconv"
|
||||
"sync"
|
||||
)
|
||||
|
||||
var m = make(map[string]int)
|
||||
|
||||
func getVal(key string) int {
|
||||
return m[key]
|
||||
}
|
||||
|
||||
func setVal(key string, value int) {
|
||||
m[key] = value
|
||||
}
|
||||
|
||||
func main() {
|
||||
wg := sync.WaitGroup{}
|
||||
wg.Add(10)
|
||||
for i := 0; i < 10; i++ {
|
||||
go func(num int) {
|
||||
defer wg.Done()
|
||||
key := strconv.Itoa(num)
|
||||
setVal(key, num)
|
||||
fmt.Printf("key=:%v,val:=%v\n", key, getVal(key))
|
||||
}(i)
|
||||
}
|
||||
wg.Wait()
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
fatal error: concurrent map writes
|
||||
```
|
||||
程序报错了,说明`map`不能同时被多个`goroutine`读写。要解决`map`的并发写问题一种方式使用我们前面学到的对`map`加锁,这样就可以了
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"strconv"
|
||||
"sync"
|
||||
)
|
||||
|
||||
var m = make(map[string]int)
|
||||
var mu sync.Mutex
|
||||
|
||||
func getVal(key string) int {
|
||||
return m[key]
|
||||
}
|
||||
|
||||
func setVal(key string, value int) {
|
||||
m[key] = value
|
||||
}
|
||||
|
||||
func main() {
|
||||
wg := sync.WaitGroup{}
|
||||
|
||||
wg.Add(10)
|
||||
for i := 0; i < 10; i++ {
|
||||
go func(num int) {
|
||||
defer func() {
|
||||
wg.Done()
|
||||
mu.Unlock()
|
||||
}()
|
||||
key := strconv.Itoa(num)
|
||||
mu.Lock()
|
||||
setVal(key, num)
|
||||
fmt.Printf("key=:%v,val:=%v\n", key, getVal(key))
|
||||
}(i)
|
||||
}
|
||||
wg.Wait()
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
key=:9,val:=9
|
||||
key=:4,val:=4
|
||||
key=:0,val:=0
|
||||
key=:1,val:=1
|
||||
key=:2,val:=2
|
||||
key=:3,val:=3
|
||||
key=:6,val:=6
|
||||
key=:7,val:=7
|
||||
key=:5,val:=5
|
||||
key=:8,val:=8
|
||||
```
|
||||
另外一种方式是使用`sync`包中提供的一个开箱即用的并发安全版`map`–`sync.Map`,在 Go 1.9 引入。`sync.Map`不用初始化就可以使用,同时`sync.Map`内置了诸如`Store`、`Load`、`LoadOrStore`、`Delete`、`Range`等操作方法。
|
||||
具体使用方法看示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
func main() {
|
||||
var m sync.Map
|
||||
// 1. 写入
|
||||
m.Store("name", "zhangsan")
|
||||
m.Store("age", 18)
|
||||
|
||||
// 2. 读取
|
||||
age, _ := m.Load("age")
|
||||
fmt.Println(age.(int))
|
||||
|
||||
// 3. 遍历
|
||||
m.Range(func(key, value interface{}) bool {
|
||||
fmt.Printf("key is:%v, val is:%v\n", key, value)
|
||||
return true
|
||||
})
|
||||
|
||||
// 4. 删除
|
||||
m.Delete("age")
|
||||
age, ok := m.Load("age")
|
||||
fmt.Println(age, ok)
|
||||
|
||||
// 5. 读取或写入
|
||||
m.LoadOrStore("name", "zhangsan")
|
||||
name, _ := m.Load("name")
|
||||
fmt.Println(name)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
18
|
||||
key is:name, val is:zhangsan
|
||||
key is:age, val is:18
|
||||
<nil> false
|
||||
zhangsan
|
||||
```
|
||||
1. 通过store方法写入两个键值对
|
||||
2. 读取key为age的值,读出来age为18
|
||||
3. 通过range方法遍历map的key和value
|
||||
4. 删除key为age的键值对,删除完之后,再次读取age,age为空,ok为false表示map里没有这个key
|
||||
5. LoadOrStore尝试读取key为name的值,读取不到就写入键值对name-zhangsan,能读取到就返回原来map里的name对应的值
|
||||
**注意:`sync.Map` 没有提供获取 map 数量的方法,需要我们在对 `sync.Map`进行遍历时自行计算,`sync.Map` 为了保证并发安全有一些性能损失,因此在非并发情况下,使用 `map` 相比使用 `sync.Map` 会有更好的性能**
|
||||
|
||||
## sync/Atomic
|
||||
除了前面介绍的锁`mutex`以外,还有一种解决并发安全的策略,就是原子操作。所谓原子操作就是这一系列的操作在`cpu`上执行是一个不可分割的整体,显然要么全部执行,要么全部不执行,不会受到其他操作的影响,也就不会存在并发问题。
|
||||
|
||||
### atomic和mutex的区别
|
||||
1. 使用方式:通常`mutex`用于保护一段执行逻辑,而`atomic`主要是对变量进行操作
|
||||
2. 底层实现:`mutex`由操作系统调度器实现,而`atomic`操作有底层硬件指令支持,保证在`cpu`上执行不中断。所以`atomic`的性能也能随`cpu`的个数增加线性提升
|
||||
|
||||
#### `atomic`提供的方法:
|
||||
```go
|
||||
func AddT(addr *T, delta T)(new T)
|
||||
func StoreT(addr *T, val T)
|
||||
func LoadT(addr *T) (val T)
|
||||
func SwapT(addr *T, new T) (old T)
|
||||
func CompareAndSwapT(addr *T, old, new T) (swapped bool)
|
||||
T的类型是int32、int64、uint32、uint64和uintptr中的任意一种
|
||||
```
|
||||
这里就不一一演示各个方法了,以`AddT`方法为例简单看一个例子
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
"sync/atomic"
|
||||
)
|
||||
|
||||
func main() {
|
||||
|
||||
var sum int32 = 0
|
||||
var wg sync.WaitGroup
|
||||
for i := 0; i < 100; i++ {
|
||||
wg.Add(1)
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
atomic.AddInt32(&sum, 1)
|
||||
}()
|
||||
}
|
||||
wg.Wait()
|
||||
fmt.Printf("sum is %d\n",sum)
|
||||
}
|
||||
```
|
||||
100个goroutine,每个goroutine都对sum+1,最后结果为100。
|
||||
|
||||
### atomic.value
|
||||
上面展示的`AddT`,`StoreT`等方法都是针对的基本数据类型做的操作,假设想对多个变量进行同步保护,即假设想对一个`struct`这样的复合类型用原子操作,也是支持的吗?也可以做支持,go语言里的`atomic.value`支持任意一种接口类型进行原子操作,且提供了`Load`、`Store`、`Swap`和`CompareAndSwap`四种方法:
|
||||
- `Load`:func (v *Value) Load() (val any),从value读出数据
|
||||
- `Store`:func (v *Value) Store(val any),向value写入数据
|
||||
- `Swap`:func (v *Value) Swap(new any) (old any),用new交换value中存储的数据,返回value原来存储的旧数据
|
||||
- `CompareAndSwap`:func (v *Value) CompareAndSwap(old, new any) (swapped bool),比较value中存储的数据和old是否相同,相同的话,将value中的数据替换为new
|
||||
代码示例
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync/atomic"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
}
|
||||
|
||||
func main() {
|
||||
st1 := Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
}
|
||||
st2 := Student{
|
||||
Name: "lisi",
|
||||
Age: 19,
|
||||
}
|
||||
st3 := Student{
|
||||
Name: "wangwu",
|
||||
Age: 20,
|
||||
}
|
||||
var v atomic.Value
|
||||
v.Store(st1)
|
||||
fmt.Println(v.Load().(Student))
|
||||
|
||||
old := v.Swap(st2)
|
||||
fmt.Printf("after swap: v=%v\n", v.Load().(Student))
|
||||
fmt.Printf("after swap: old=%v\n", old)
|
||||
|
||||
swapped := v.CompareAndSwap(st1, st3) // v中存储的和st1不相同,交换失败
|
||||
fmt.Println("compare st1 and v\n", swapped, v)
|
||||
|
||||
swapped = v.CompareAndSwap(st2, st3) // v中存储的和st2相同,交换成功,v中变为st3
|
||||
fmt.Println("compare st2 and v\n", swapped, v)
|
||||
}
|
||||
```
|
||||
运行结果
|
||||
```
|
||||
{zhangsan 18}
|
||||
after swap: v={lisi 19}
|
||||
after swap: old={zhangsan 18}
|
||||
compare st1 and v
|
||||
false {{lisi 19}}
|
||||
compare st2 and v
|
||||
true {{wangwu 20}}
|
||||
```
|
||||
|
||||
## sync.pool
|
||||
`sync.Pool`是在`sync`包下的一个内存池组件,用来实现对象的复用,避免重复创建相同的对象,造成频繁的内存分配和gc,以达到提升程序性能的目的。虽然池子中的对象可以被复用,但是是`sync.Pool`并不会永久保存这个对象,池子中的对象会在一定时间后被gc回收,这个时间是随机的。所以,用`sync.Pool`来持久化存储对象是不可取的。
|
||||
另外,`sync.Pool`本身是并发安全的,支持多个`goroutine`并发的往`sync.Pool`存取数据
|
||||
|
||||
### sync.pool使用方法
|
||||
关于`sync.Pool`的使用,一般是通过三个方法来完成的
|
||||
|
||||
| 方法 | 说明 |
|
||||
| --- | --- |
|
||||
| New() | sync.Pool的构造函数,用于指定sync.Pool中缓存的数据类型,当调用Get方法从对象池中获取对象的时候,对象池中如果没有,会调用New方法创建一个新的对象 |
|
||||
| Get() | 从对象池取对象 |
|
||||
| Put() | 往对象池放对象,下次Get的时候可以复用 |
|
||||
|
||||
下面通过例子看一下`sync.Pool`的使用方式
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
}
|
||||
|
||||
func main() {
|
||||
pool := sync.Pool{
|
||||
New: func() interface{} {
|
||||
return &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
}
|
||||
},
|
||||
}
|
||||
|
||||
st := pool.Get().(*Student)
|
||||
println(st.Name, st.Age)
|
||||
fmt.Printf("addr is %p\n", st)
|
||||
|
||||
pool.Put(st)
|
||||
|
||||
st1 := pool.Get().(*Student)
|
||||
println(st1.Name, st1.Age)
|
||||
fmt.Printf("addr1 is %p\n", st1)
|
||||
}
|
||||
```
|
||||
程序输出
|
||||
```
|
||||
zhangsan 18
|
||||
addr is 0x140000a0018
|
||||
zhangsan 18
|
||||
addr1 is 0x140000a0018
|
||||
```
|
||||
在程序中,首先初始化一个`sync.Pool`对象,初始化里面的`New`方法,用于创建对象,这里是返回一个`Student`类型的指针。第一次调用`pool.Get().(*Student)`的时候,由于池子内没有对象,所以会通过`New`方法创建一个,注意`pool.Get()`返回的是一个`interface{}`,所以我们需要断言成`*Student`类型,在我们使用完,打印出`Name`和`Age`之后,再调用`Put`方法,将这个对象放回到池子内,后面我们紧接着又调用`pool.Get()`取对象,可以看到两次去除的对象地址是同一个,说明是同一个对象,表明`sync.Pool`有缓存对象的功能。
|
||||
>注意
|
||||
>我们在第一次`pool.Get()`取出`*Student`对象打印完地址之后,put进池子的时候没有进行一个Reset的过程,这里是因为我们取出`*Student`对象之后,仅仅是读取里面的字段,并没有修改操作,假设我们有修改操作,那么这里就需要在`pool.Put(st)`之前执行`Reset`,将对象的值复原,如果不这样做,那么下一次`pool.Get()`取出的`*Student`对象就不是我们希望复用的初始对象
|
||||
|
||||
假设我们对`*Student`做修改
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
}
|
||||
|
||||
func main() {
|
||||
pool := sync.Pool{
|
||||
New: func() interface{} {
|
||||
return &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
}
|
||||
},
|
||||
}
|
||||
|
||||
st := pool.Get().(*Student)
|
||||
println(st.Name, st.Age)
|
||||
fmt.Printf("addr is %p\n", st)
|
||||
|
||||
// 修改
|
||||
st.Name = "lisi"
|
||||
st.Age = 20
|
||||
|
||||
// 回收
|
||||
pool.Put(st)
|
||||
|
||||
st1 := pool.Get().(*Student)
|
||||
println(st1.Name, st1.Age)
|
||||
fmt.Printf("addr1 is %p\n", st1)
|
||||
}
|
||||
```
|
||||
程序输出
|
||||
```
|
||||
zhangsan 18
|
||||
addr is 0x1400000c030
|
||||
lisi 20
|
||||
addr1 is 0x1400000c030
|
||||
```
|
||||
可以看到,我们第二次取出的对象虽然和第一次是同一个,地址形同,但是对象的字段值却发生了变化,不是我们初始化的对象了,我们想要一只重复使用一个相同的对象的话,显然这里有问题。所以,我们需要在`pool.Put(st)`回收对象之前,进行对象的`Reset`操作,将对象值复原,同时在每次我们`pool.Get()`取出完对象使用完毕之后,也不要忘了调用`pool.Put`方法把对象再次放入对象池,以便对象能够复用。
|
||||
|
||||
### sync.pool使用场景
|
||||
1. `sync.pool`主要是通过对象复用来降低gc带来的性能损耗,所以在高并发场景下,由于每个`goroutine`都可能过于频繁的创建一些大对象,造成gc压力很大。所以在高并发业务场景下出现 GC 问题时,可以使用 `sync.Pool` 减少 GC 负担
|
||||
2. `sync.pool`不适合存储带状态的对象,比如socket 连接、数据库连接等,因为里面的对象随时可能会被gc回收释放掉
|
||||
3. 不适合需要控制缓存对象个数的场景,因为`Pool` 池里面的对象个数是随机变化的,因为池子里的对象是会被gc的,且释放时机是随机的
|
||||
|
||||
@@ -0,0 +1,194 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- 协程池
|
||||
- 并发
|
||||
---
|
||||
|
||||
# 协程池
|
||||
Go语言虽然有着高效的GMP调度模型,理论上支持成千上万的`goroutine`,但是`goroutine`过多,对调度,gc以及系统内存都会造成压力,这样会使我们的服务性能不升反降。常用做法可以用池化技术,构造一个协程池,把进程中的协程控制在一定的数量,防止系统中`goroutine`过多,影响服务性能。
|
||||
|
||||
## 协程池模型
|
||||
协程池简单理解就是有一个池子一样的东西,里面装这个固定数量的`goroutine`,当有一个任务到来的时候,会将这个任务交给池子里的一个空闲的`goroutine`去处理,如果池子里没有空闲的`goroutine`了,任务就会阻塞等待。所以协程池有三个角色`Worker`,`Task`,`Pool`。
|
||||
|
||||
### 属性定义
|
||||
- `Worker`:用于执行任务的`goroutine`
|
||||
- `Task`: 具体的任务
|
||||
- `Pool`: 池子
|
||||
|
||||
下面看一下各个角色的定义:
|
||||
|
||||
#### Task定义
|
||||
`Task`有一个函数成员,表示这个task具体的执行逻辑:
|
||||
|
||||
```go
|
||||
type Task struct {
|
||||
f func() error // 具体的执行逻辑
|
||||
}
|
||||
```
|
||||
|
||||
#### Pool定义
|
||||
`Pool`有两个成员,`Capacity`表示池子里的worker的数量,即工作的`goroutine`的数量,`JobCh`表示任务队列用于存放任务,`goroutine`从这个`JobCh`获取任务执行任务逻辑:
|
||||
```go
|
||||
type Pool struct {
|
||||
RunningWorkers int64
|
||||
Capacity int64 // goroutine数量
|
||||
JobCh chan *Task // 用于worker取任务
|
||||
sync.Mutex
|
||||
}
|
||||
```
|
||||
|
||||
#### Worker定义
|
||||
```go
|
||||
// p为Pool对象指针
|
||||
for task := range p.JobCh {
|
||||
do ...
|
||||
}
|
||||
```
|
||||
执行任务单元,简单理解就是干活的`goroutine`,这个worker其实只做一件事情,就是不断的从任务队列里面取任务执行,而worker的数量就是协程池里协程的数量,由`Pool`的参数`WorkerNum`指定。
|
||||
|
||||
### 方法定义
|
||||
```go
|
||||
func NewTask(funcArg func() error) *Task
|
||||
```
|
||||
`NewTask`用于创建一个任务,参数是一个函数,返回值是一个`Task`类型。
|
||||
|
||||
```go
|
||||
func NewPool(Capacity int, taskNum int) *Pool
|
||||
```
|
||||
`NewPool`返回一个协程数量固定为`workerNum`协程池对象指针,其任务队列的长度为`taskNum`。
|
||||
|
||||
接下来主要介绍协程池的各个方法:
|
||||
```go
|
||||
func (p *Pool) AddTask(task *Task)
|
||||
```
|
||||
`AddTask`方法是往协程池添加任务,如果当前运行着的worker数量小于协程池worker容量,则立即启动一个协程worker来处理任务,否则将任务添加到任务队列。
|
||||
|
||||
```go
|
||||
func (p *Pool) Run()
|
||||
```
|
||||
将协程池跑起来,启动一个worker来处理任务。
|
||||
|
||||
协程池处理任务流程图:
|
||||
|
||||

|
||||
|
||||
### 协程池实现
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"sync"
|
||||
"sync/atomic"
|
||||
"time"
|
||||
)
|
||||
|
||||
type Task struct {
|
||||
f func() error // 具体的任务逻辑
|
||||
}
|
||||
|
||||
func NewTask(funcArg func() error) *Task {
|
||||
return &Task{
|
||||
f: funcArg,
|
||||
}
|
||||
}
|
||||
|
||||
type Pool struct {
|
||||
RunningWorkers int64 // 运行着的worker数量
|
||||
Capacity int64 // 协程池worker容量
|
||||
JobCh chan *Task // 用于worker取任务
|
||||
sync.Mutex
|
||||
}
|
||||
|
||||
func NewPool(capacity int64, taskNum int) *Pool {
|
||||
return &Pool{
|
||||
Capacity: capacity,
|
||||
JobCh: make(chan *Task, taskNum),
|
||||
}
|
||||
}
|
||||
|
||||
func (p *Pool) GetCap() int64 {
|
||||
return p.Capacity
|
||||
}
|
||||
|
||||
func (p *Pool) incRunning() { // runningWorkers + 1
|
||||
atomic.AddInt64(&p.RunningWorkers, 1)
|
||||
}
|
||||
|
||||
func (p *Pool) decRunning() { // runningWorkers - 1
|
||||
atomic.AddInt64(&p.RunningWorkers, -1)
|
||||
}
|
||||
|
||||
func (p *Pool) GetRunningWorkers() int64 {
|
||||
return atomic.LoadInt64(&p.RunningWorkers)
|
||||
}
|
||||
|
||||
func (p *Pool) run() {
|
||||
p.incRunning()
|
||||
go func() {
|
||||
defer func() {
|
||||
p.decRunning()
|
||||
}()
|
||||
for task := range p.JobCh {
|
||||
task.f()
|
||||
}
|
||||
}()
|
||||
}
|
||||
|
||||
// AddTask 往协程池添加任务
|
||||
func (p *Pool) AddTask(task *Task) {
|
||||
// 加锁防止启动多个 worker
|
||||
p.Lock()
|
||||
defer p.Unlock()
|
||||
|
||||
if p.GetRunningWorkers() < p.GetCap() { // 如果任务池满, 则不再创建 worker
|
||||
// 创建启动一个 worker
|
||||
p.run()
|
||||
}
|
||||
|
||||
// 将任务推入队列, 等待消费
|
||||
p.JobCh <- task
|
||||
}
|
||||
|
||||
func main() {
|
||||
// 创建任务池
|
||||
pool := NewPool(3, 10)
|
||||
|
||||
for i := 0; i < 20; i++ {
|
||||
// 任务放入池中
|
||||
pool.AddTask(NewTask(func() error {
|
||||
fmt.Printf("I am Task\n")
|
||||
return nil
|
||||
}))
|
||||
}
|
||||
|
||||
time.Sleep(1e9) // 等待执行
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
I am Task
|
||||
```
|
||||
程序创建了一个`WorkerNum`为3,任务队列长度为10的协程池,往里面添加了20个任务,可以看到输出,一直只有3个`worker`在做任务,起到了控制`goroutine`数量的作用。
|
||||
@@ -0,0 +1,866 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- 反射
|
||||
---
|
||||
|
||||
# 反射
|
||||
|
||||
## 什么是反射
|
||||
反射可以认为是程序在运行时的一种能力,反射可以在程序运行时访问、检测和修改它本身状态,比如在程序运行时可以检查变量的类型和值,调用它们的方法,甚至修改它们的值。使用反射可以增加程序的灵活性,简单来说,反射就是程序在运行时能够检测自身和修改自身的一种能力。
|
||||
|
||||
## Go语言反射
|
||||
对于很多的高级语言都实现了反射,像Java,Python。在Go语言中,反射在Go语言内置的`reflect`包下实现。Go语言中的反射建立在Go的类型系统之上,并且与接口密切相关。通过前面的学习我们知道Go语言的空接口包含类型(`Type`)和值(`Value`)两个部分,在反射里,也要用到类型(`Type`)和值(`Value`)。
|
||||
`reflect`包中定义了`reflect.Type`和`reflect.Value`,正好对应我们前面所说的`Type`和`Value`。要注意的是`reflect.Type`是一个接口而`reflect.Value`是一个具体的结构体。在`reflect.Type`接口中定义了很多跟类型相关的方法,而`reflect.Value`则是绑定了很多跟值相关的方法。
|
||||
|
||||
### reflect.TypeOf()
|
||||
由于`reflect.Type`是一个接口,所以只有当某个类型实现了这个接口,我们才能获取到它的类型,同时,在`reflect`包内,类型描述符是未导出类型,所以我们只能通过`reflect.TypeOf()`方法获取`reflect.Type`类型的值。
|
||||
我们首先看一个例子,看下`reflect.TypeOf()`的常用用法:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
}
|
||||
|
||||
func main() {
|
||||
var num int64 = 100
|
||||
t1 := reflect.TypeOf(num)
|
||||
fmt.Println(t1.String())
|
||||
|
||||
st := Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
}
|
||||
t2 := reflect.TypeOf(st)
|
||||
fmt.Println(t2.String())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
int64
|
||||
main.Student
|
||||
```
|
||||
可以看到对于基础类型和`struct`类型通过调用`reflect.TypeOf()`都打印出了对应的类型信息。注意`reflect.TypeOf`返回的是一个`reflect.Type`接口类型,我们通过调用这个接口的`String()`方法,得到最终的字符串信息。
|
||||
|
||||
在前面学习`interface`的章节中,我们知道一个具体的数据类型是可以赋值给一个`interface`类型的,反过来则不行,要用到`interface`的断言。在一个`interface`赋值之后,其实是对应了两个类型,一个是静态类型,就是在程序编译期就确定的类型,`interface`的静态类型就是接口`interface`,同时当`interface`赋值之后,他还有一个动态类型,就是被赋值的那个数据的具体类型,假设在上例中,我们将`st`赋值给一个空`interface`,那么这个`interface`的动态类型就是`Student`。
|
||||
|
||||
对一个数据对象进行反射操作,其实是首先将具体对象类型转化为一个`interface`类型,然后再将`interface`类型转化为`reflect`包下的反射类型,反射类型里的类型信息和值信息其实就是对应着这个中间类型`interface`的类型和值。
|
||||
|
||||
|
||||
|
||||
`reflect.TypeOf()`方法获取的就是这个`interface{}`中的类型部分。
|
||||
|
||||
### reflect.ValueOf()
|
||||
同理,`reflect.ValueOf()`方法自然就是获取接口中的值部分,`reflect.ValueOf()`的返回值其实就是一个`reflect.Value`结构。
|
||||
```go
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
}
|
||||
|
||||
func main() {
|
||||
var num int64 = 100
|
||||
v1 := reflect.ValueOf(num)
|
||||
fmt.Println(v1)
|
||||
fmt.Println(v1.String())
|
||||
|
||||
st := Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
}
|
||||
v2 := reflect.ValueOf(st)
|
||||
fmt.Println(v2)
|
||||
fmt.Println(v2.String())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
100
|
||||
<int64 Value>
|
||||
{zhangsan 18}
|
||||
<main.Student Value>
|
||||
```
|
||||
注意到这里`fmt.Println(v1)`和`fmt.Println(v1.String())`打印的不一样,上面说了`reflect.ValueOf()`的返回值就是一个`reflect.Value`结构,但是`fmt.Println(v1)`却打印出了具体的值,这是因为`fmt.Println`的参数是一个接口类型,在执行过程中有一些类型转换,对`reflect.Value`结构做了特殊处理。
|
||||
|
||||
### Go语言数据种类
|
||||
在Go语言中常用的数据类型有26种,以枚举的方式定义在`src/reflect/type.go`文件中:
|
||||
|
||||
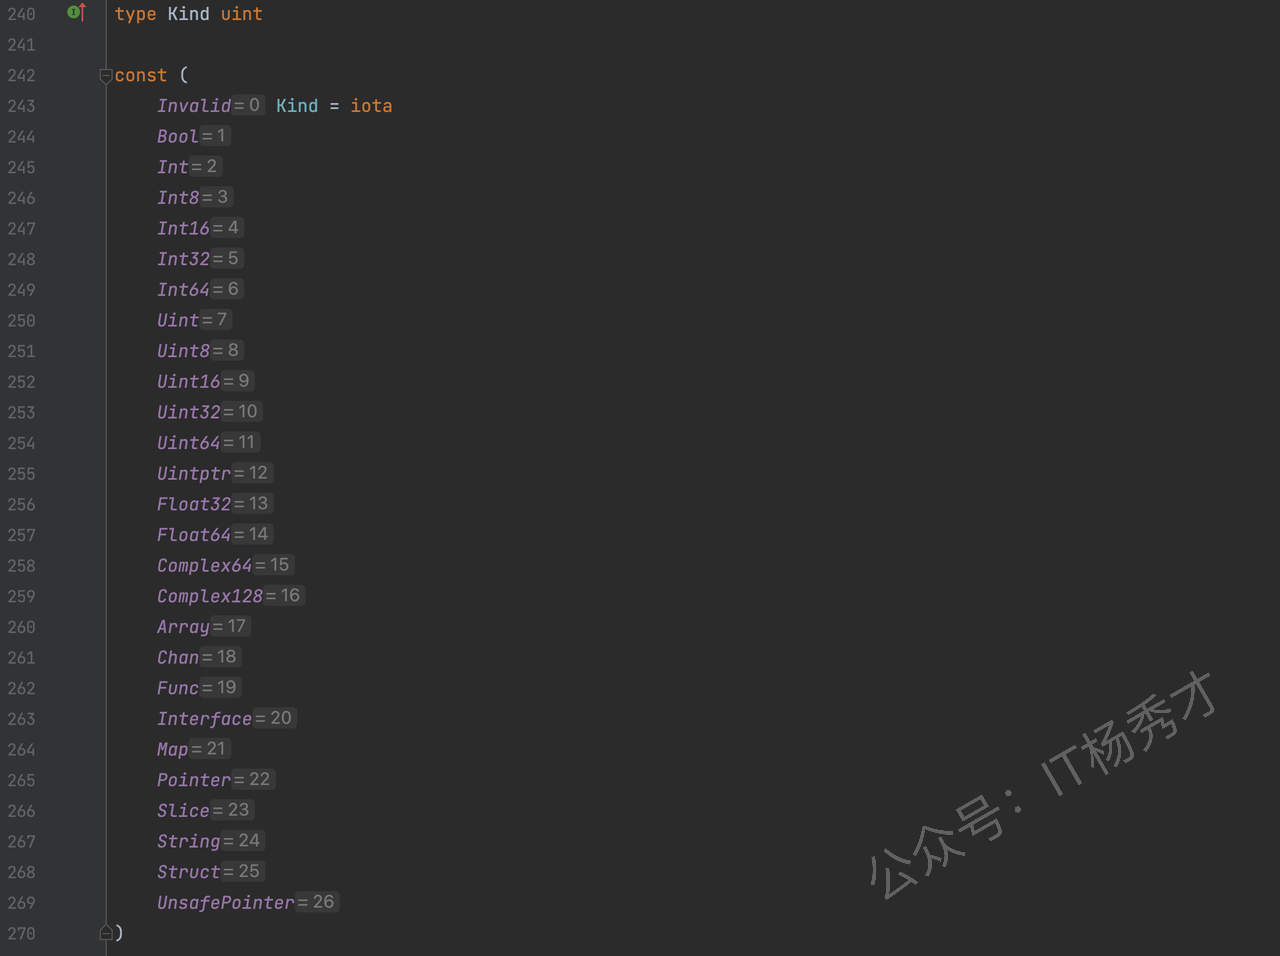
|
||||
|
||||
这些类型中包含`int`,`bool`之类的基础数据类型,也包含`Struct`,`Array`,`Map`等复合类型,有了这些类型,我们用`type struct`自定义的任何类型都可以由他们组合完成。
|
||||
看个`type struct`定义的数据类型使用反射的例子:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type WrapInt int
|
||||
|
||||
func main() {
|
||||
var num1 int = 100
|
||||
var num2 WrapInt = 1000
|
||||
|
||||
num1 = int(num2) // 不同类型的type赋值,这里要强转
|
||||
|
||||
typeNum1 := reflect.TypeOf(num1)
|
||||
fmt.Printf("type of num1 is %s\n", typeNum1.String())
|
||||
|
||||
typeNum2 := reflect.TypeOf(num2)
|
||||
fmt.Printf("type of num2 is %s\n", typeNum2.String())
|
||||
|
||||
fmt.Printf("kind of num1 is %v\n", typeNum1.Kind())
|
||||
fmt.Printf("kind of num2 is %v\n", typeNum2.Kind())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
type of num1 is int
|
||||
type of num2 is main.WrapInt
|
||||
kind of num1 is int
|
||||
kind of num2 is int
|
||||
```
|
||||
通过`WrapInt`的定义可以看到,`WrapInt`其实就是用`type`给`int`去了个别名,二者底层其实都是`int`类型,但是通过`reflect.TypeOf`获取到各自的`type`其实是不一样的,不同`type`之间的变量赋值是需要类型强制转换的,但是深层次的去分析`type`的种类,即`Kind`确是一样的。
|
||||
|
||||
## 反射使用
|
||||
|
||||
### 值对象
|
||||
`reflect`包下跟值对象相关的常用函数或方法:
|
||||
|
||||
| 函数/方法 | 说明 |
|
||||
|----------|------|
|
||||
| `reflect.TypeOf()` | 获取某个对象的反射类型实现(`reflect.Type`) |
|
||||
| `reflect.ValueOf()` | 获取某个对象的反射值对象(`reflect.Value`) |
|
||||
| `reflect.Value.NumField()` | 获取结构体的反射值对象中的字段个数,只对结构体类型有效 |
|
||||
| `reflect.Value.Field(i)` | 获取结构体的反射值对象中的第i个字段,只对结构体类型有效 |
|
||||
| `reflect.Kind()` | 从反射值对象中获取该值的种类 |
|
||||
| `reflect.Value.MapKeys()` | 对map的每个键的`reflect.Value`对象组成的一个切片 |
|
||||
| `reflect.Value.MapIndex(i)` | 根据map的某个键的`reflect.Value`对象,返回值的`reflect.Value`对象 |
|
||||
| `reflect.Value.Len()` | 对切片或数组的反射对象求切片或数组的长度 |
|
||||
| `reflect.Value.Index(i)` | 返回切片或数组第i个元素的`reflect.Value`值 |
|
||||
| `reflect.Int()/reflect.Uint()/reflect.String()/reflect.Bool()` | 从反射的值对象中取出对应值,注意`reflect.Int()/reflect.Uint()`方法对种类做了合并处理,它们只返回相应的最大范围的类型,`Int()`返回`Int64`类型,`Uint()`返回`Uint64`类型 |
|
||||
|
||||
#### 获取struct反射值
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
|
||||
st := Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 95.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
fmt.Printf("the field num of Student is %d\n", v.NumField())
|
||||
fmt.Printf("field1 type is %v, value is %s\n", v.Field(0).Type().Name(), v.Field(0).String())
|
||||
fmt.Printf("field2 type is %v, value is %d\n", v.Field(1).Type().Name(), v.Field(1).Int())
|
||||
fmt.Printf("field2 type is %v, value is %f\n", v.Field(2).Type().Name(), v.Field(2).Float())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
the field num of Student is 3
|
||||
field1 type is string, value is zhangsan
|
||||
field2 type is int, value is 18
|
||||
field2 type is float64, value is 95.500000
|
||||
```
|
||||
`v := reflect.ValueOf(st)`,`v`是一个`Student`类型的反射值对象,通过`v.NumField()`可以得出`Student`类型的字段个数,然后`v.Field(i).Type().Name()`打印出各个字段值的类型,`v.Field(i)`打印出各个字段值
|
||||
注意:`NumField()`和`Field()`方法只有原对象是结构体时才能调用,否则会panic
|
||||
|
||||
#### 获取map反射值
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
func main() {
|
||||
m := map[int]uint32{
|
||||
1: 100,
|
||||
2: 200,
|
||||
}
|
||||
v := reflect.ValueOf(m)
|
||||
for _, k := range v.MapKeys() {
|
||||
field := v.MapIndex(k)
|
||||
fmt.Printf("key type is %v, key = %d; value type is %v, value = %d\n", k.Type().Name(), k.Int(), field.Type().Name(), field.Uint())
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
key type is int, key = 1; value type is uint32, value = 100
|
||||
key type is int, key = 2; value type is uint32, value = 200
|
||||
```
|
||||
`v := reflect.ValueOf(m)`对map类型的对象m进行反射,通过`v.MapKeys()`的到m中所有key的`reflect.Value`对象k,然后通过`v.MapIndex(k)`的到对应key反射值对象的value反射值对象,然后通过`reflect.Value`的`Type().Name()`方法获取map中key,value的类型,然后打印出对应值
|
||||
|
||||
#### 获取slice反射值
|
||||
```go
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
func main() {
|
||||
slice := []int{1, 2, 3}
|
||||
v1 := reflect.ValueOf(slice)
|
||||
for i := 0; i < v1.Len(); i++ {
|
||||
elem := v1.Index(i)
|
||||
fmt.Printf("%v ", elem.Interface())
|
||||
}
|
||||
|
||||
fmt.Println()
|
||||
|
||||
nums := [3]int{4, 5, 6}
|
||||
v2 := reflect.ValueOf(nums)
|
||||
for i := 0; i < v2.Len(); i++ {
|
||||
elem := v2.Index(i)
|
||||
fmt.Printf("%v ", elem.Interface())
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
1 2 3
|
||||
4 5 6
|
||||
```
|
||||
`v1`,`v2`分别是切片和数组的反射值对象,通过`Len()`获取到数组或切片中的元素个数,然后通过`v.Index(i)`获取对应元素的`reflect.value`对象,打印出其值
|
||||
> **注意:`Len()`和`Index(i)`方法只能在原对象是切片,数组或字符串时才能调用,其他类型会panic**。
|
||||
|
||||
### 类型对象
|
||||
reflect包下跟类型相关的常用函数或方法
|
||||
|
||||
| 函数/方法 | 说明 |
|
||||
|----------|------|
|
||||
| `reflect.Value.NumField()` | 获取结构体的反射值对象中的字段个数,只对结构体类型有效 |
|
||||
| `reflect.Value.Field(i)` | 获取结构体的反射值对象中的第i个字段,只对结构体类型有效 |
|
||||
| `reflect.Value.Elem()` | 根据指针获取对应的具体类型 |
|
||||
| `reflect.Value.NumIn()` | 获取函数反射类型的参数个数 |
|
||||
| `reflect.Value.In(i)` | 获取函数反射类型的第i个参数 |
|
||||
| `reflect.Value.NumOut()` | 获取函数反射类型的返回值个数 |
|
||||
| `reflect.Value.Out(i)` | 获取函数反射类型的第i个返回值 |
|
||||
| `reflect.Value.NumMethod()` | 获取struct上绑定的方法个数 |
|
||||
| `reflect.Value.Method(i)` | 获取struct上绑定的第i个方法 |
|
||||
|
||||
#### struct反射类型
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
t := reflect.TypeOf(st)
|
||||
fmt.Println(t.Name())
|
||||
fmt.Println(t.Kind())
|
||||
fmt.Println(t.NumField())
|
||||
for i := 0; i < t.NumField(); i++ {
|
||||
fmt.Printf("field1 name is %s, field1 type is %s\n", t.Field(i).Name, t.Field(i).Type.String())
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
Student
|
||||
struct
|
||||
3
|
||||
field1 name is Name, field1 type is string
|
||||
```
|
||||
通过`reflect.Type`的`Name()`方法可以获取对应的`Type`类型,`Kind()`方法获取底层的数据种类,即`kind`,跟`reflect.Value`一样,`reflect.Type`也提供了`NumField()`方法用于获取结构体对象中的字段个数,通过`t.Field(i).Name`可以获取对应字段的名字。同样,`Field(i)`和`NumField()`也只能对结构体反射使用
|
||||
|
||||
#### 指针反射类型
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
t := reflect.TypeOf(st)
|
||||
|
||||
fmt.Println(t.Kind())
|
||||
fmt.Println(t.Elem().Name()) // 这里一定要加Elem(),根据指针获取到具体类型后,才能或者具体的type名
|
||||
fmt.Println(t.Elem().NumField()) // 这里一定要加Elem(),根据指针获取到具体类型后,才能字段个数
|
||||
for i := 0; i < t.Elem().NumField(); i++ {
|
||||
fmt.Printf("field1 name is %s, field1 type is %s\n", t.Elem().Field(i).Name, t.Elem().Field(i).Type.String())
|
||||
}
|
||||
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
ptr
|
||||
Student
|
||||
3
|
||||
field1 name is Name, field1 type is string
|
||||
field2 name is Age, field2 type is int
|
||||
field3 name is Score, field3 type is float64
|
||||
```
|
||||
可以看到,跟上面直接获取`struct`有一点点小小的区别,那就是`fmt.Println(t.Kind())`打印出的是一个`ptr`指针类型,而不再是`struct`类型,正是因为这里是一个`ptr`,所以我们不能直接在这个`ptr`上调用.Name()以及其他的.NumField()之类的方法,要根据`ptr`的.Elem()获取到具体类型之后,才能用这些方法,否则程序就回报`panic`,这点一定要注意
|
||||
|
||||
#### 函数反射类型
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
func Add(num1, num2 int) (int, error) {
|
||||
return num1 + num2, nil
|
||||
}
|
||||
|
||||
func main() {
|
||||
|
||||
fmt.Println("input:")
|
||||
t := reflect.TypeOf(Add)
|
||||
for i := 0; i < t.NumIn(); i++ {
|
||||
tIn := t.In(i)
|
||||
fmt.Print(tIn.Name())
|
||||
fmt.Printf(" ")
|
||||
}
|
||||
fmt.Printf("\n--------------------------------")
|
||||
|
||||
fmt.Println("output:")
|
||||
for i := 0; i < t.NumOut(); i++ {
|
||||
tOut := t.Out(i)
|
||||
fmt.Print(tOut.Name())
|
||||
fmt.Print(" ")
|
||||
}
|
||||
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
input:
|
||||
int int
|
||||
--------------------------------
|
||||
output:
|
||||
int error
|
||||
```
|
||||
`t := reflect.TypeOf(Add)`获取到Add函数的`type`类型,然后通过`NumIn()`方法获得Add函数的参数个数,依次打印出参数的类型。通过`NumOut()`方法获得Add函数的返回值个数,依次打印出返回值的类型
|
||||
|
||||
#### 3.2.4 反射获取struct方法
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func (s *Student) GetName() string {
|
||||
return s.Name
|
||||
}
|
||||
|
||||
func (s *Student) SetName(name string) {
|
||||
s.Name = name
|
||||
}
|
||||
|
||||
func (s *Student) GetAge() int {
|
||||
return s.Age
|
||||
}
|
||||
|
||||
func (s *Student) SetAge(age int) {
|
||||
s.Age = age
|
||||
}
|
||||
|
||||
func (s *Student) GetScore() float64 {
|
||||
return s.Score
|
||||
}
|
||||
|
||||
func (s *Student) SetScore(score float64) {
|
||||
s.Score = score
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
t := reflect.TypeOf(st)
|
||||
|
||||
for i := 0; i < t.NumMethod(); i++ {
|
||||
m := t.Method(i)
|
||||
fmt.Printf("%+v\n", m)
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
{GetName func(*main.Student) string}
|
||||
{SetName func(*main.Student, string)}
|
||||
{GetAge func(*main.Student) int}
|
||||
{SetAge func(*main.Student, int)}
|
||||
{GetScore func(*main.Student) float64}
|
||||
{SetScore func(*main.Student, float64)}
|
||||
```
|
||||
- `reflect.Type.NumMethod()`:返回struct所绑定的的方法个数
|
||||
- `reflect.Type.Method(i)`:返回第i个方法的`reflect.Method`对象
|
||||
|
||||
`reflect.Method`定义在`src/reflect/type.go`文件:
|
||||
```go
|
||||
type Method struct {
|
||||
Name string // 方法名
|
||||
PkgPath string
|
||||
Type Type // 方法类型(
|
||||
Func Value // 方法值(方法的接收器作为第一个参数)
|
||||
Index int // 是结构体中的第几个方法
|
||||
}
|
||||
```
|
||||
所以,通过`reflect.Method`对象,我们可以获取到`struct`所绑定的对应方法的方法名,方法类型等信息
|
||||
|
||||
### 通过反射调用方法
|
||||
在上一小节我们知道了`reflect.Type.Method(i)`可以获取到`struct`所绑定的具体的方法对象`reflect.Method`,通过这个对象,我们不仅可以获取方法的详细信息,还可以动态的调用方法。
|
||||
其实在`reflect.Value`里我们也可以使用`NumMethod()`/`Method(i)`方法获取到对应的方法信息,不同的是`reflect.Value.Method(i)`返回的使一个`reflect.Value`对象,但是同样可以根据这个对象来动态调用方法,只是两者调用方法的方式有所区别
|
||||
请看具体例子:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func (s *Student) GetName() string {
|
||||
return s.Name
|
||||
}
|
||||
|
||||
func (s *Student) SetName(name string) {
|
||||
s.Name = name
|
||||
}
|
||||
|
||||
func (s *Student) GetAge() int {
|
||||
return s.Age
|
||||
}
|
||||
|
||||
func (s *Student) SetAge(age int) {
|
||||
s.Age = age
|
||||
}
|
||||
|
||||
func (s *Student) GetScore() float64 {
|
||||
return s.Score
|
||||
}
|
||||
|
||||
func (s *Student) SetScore(score float64) {
|
||||
s.Score = score
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
fmt.Printf("st === %+v\n", st)
|
||||
|
||||
t := reflect.TypeOf(st)
|
||||
v := reflect.ValueOf(st)
|
||||
|
||||
m1, ok := t.MethodByName("SetName") // 获取SetName方法
|
||||
fmt.Printf("t get func by name:%t\n", ok)
|
||||
|
||||
argsV1 := make([]reflect.Value, 0)
|
||||
argsV1 = append(argsV1, v)
|
||||
argsV1 = append(argsV1, reflect.ValueOf("lisi"))
|
||||
m1.Func.Call(argsV1) //
|
||||
fmt.Printf("st === %+v\n", st)
|
||||
|
||||
m2 := v.MethodByName("SetName") // 获取SetName方法
|
||||
argsV2 := make([]reflect.Value, 0)
|
||||
argsV2 = append(argsV2, reflect.ValueOf("wangwu"))
|
||||
m2.Call(argsV2)
|
||||
fmt.Printf("st === %+v\n", st)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
st === &{Name:zhangsan Age:18 Score:90.5}
|
||||
t get func by name:true
|
||||
st === &{Name:lisi Age:18 Score:90.5}
|
||||
st === &{Name:wangwu Age:18 Score:90.5}
|
||||
```
|
||||
可以看到通过`reflect.Type.MethodByName()`方法获取到的`reflect.Method`对象和`reflect.Value.MethodByName()`方法获取到的`reflect.Method`获取到的`reflect.Value`对象都可以在程序运行时动态的调用方法修改结构本身,`student`的`name`由`zhangsan`------>`lisi`------>`wangwu`。
|
||||
但是二者的调用存在一个区别:通过`reflect.Method`调用方法,必须使用`Func`字段,而且要传入接收器的`reflect.Value`作为第一个参数
|
||||
```go
|
||||
m1.Func.Call(argsV1)
|
||||
```
|
||||
`reflect.Value.MethodByName()`返回一个`reflect.Value`对象,它不需要接收器的`reflect.Value`作为第一个参数,而且直接使用`Call()`发起方法调用:
|
||||
```go
|
||||
m2.Call(argsV2)
|
||||
```
|
||||
|
||||
### 通过反射设置值
|
||||
在介绍通过反射设置或者说是修改值的方法之前,首先介绍一个概念,反射寻址。简单的说,可寻址就是可以根据地址找到值,在反射里面,`reflect.Value`由`reflect.ValueOf()`方法得到,根据命名就可以知道`reflect.ValueOf()`是得到一个值对象,显然他不能得到这个值的地址。所以通过`reflect.ValueOf()`方法得到的`reflect.Value`都是不可寻址的。在`reflect`包下有一个`CanAddr()`方法可以用于验证一个对象是否可寻址
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
fmt.Println(v.CanAddr())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
false
|
||||
```
|
||||
尽管这里`st`是一个`Student`类型的指针,但是经过`reflect.ValueOf()`之后得到的对象`v`,仍然是不能寻址的,他只能反映出当前指针指向的具体元素的地址,而当前指针自身所在的内存地址是无从得知的
|
||||
经过前面学习指针反射类型的学习,我们知道了假设`reflect.ValueOf()`返回的是一个指针的`reflect.Value`对象,那么我们可以调用`reflect.Value.Elem()`方法得到具体的类型,而此时得到的这个反射具体类型就是可寻址的,我们可以知道他的地址,道理很简单,因为`reflect.Value.Elem()`获取到的值,记录了根据指针获取到值这个获取路径,显然我们可以根据值追溯到地址
|
||||
|
||||
1. reflect.Value.Elem()方法得到具体的类型可寻址
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
fmt.Println(v.Elem().CanAddr())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
true
|
||||
```
|
||||
可以看到,通过`reflect.Value.Elem()`方法得到具体的类型之后,这个具体的类型就是可寻址的,所以`CanAddr()`方法返回`true`
|
||||
|
||||
2. 对切片进行反射时,通过reflect.Value.Index(i)获取到的reflect.Value对象是可以寻址的
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
slice := []int{1, 2, 3, 4, 5}
|
||||
v := reflect.ValueOf(slice)
|
||||
fmt.Println(v.Index(0).CanAddr())
|
||||
fmt.Println(v.Index(1).CanAddr())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
true
|
||||
true
|
||||
```
|
||||
可以看到,通过`reflect.Value.Index(i)`获取到的`reflect.Value`对象是可以寻址的,所以`CanAddr()`方法返回`true`。但是对数组`reflect.Value.Index(i)`获取到的`reflect.Value`对象是不可寻址的
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
nums := [3]int{1, 2, 3}
|
||||
v1 := reflect.ValueOf(nums)
|
||||
fmt.Println(v1.Index(0).CanAddr())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
false
|
||||
```
|
||||
可以看到,对数组`reflect.Value.Index(i)`获取到的`reflect.Value`对象是不可寻址的
|
||||
通过`reflect.ValueOf`的到的其实是原始数据的一份拷贝,切片底层实现其实是一个`stuct`类型,`struct`里包含一个执行具体数组的指针,对切片拷贝,虽然拷贝了这个`struct`,自然`struct`里的指针也拷贝了一份,但是两个指针执行同一个内存区域,所以修改拷贝的切片,也会影响原值
|
||||
|
||||
3. 通过结构体的指针获取到的字段也是可寻址的
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
f := v.Elem().Field(0)
|
||||
fmt.Println(f.CanAddr())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
true
|
||||
```
|
||||
可以看到,通过结构体的指针获取到的字段也是可寻址的。通过上面分析,可寻址就是可以找到数据本身,而不是找到数据的副本,既然我们找到了数据本身,那么就可以对原数据修改,即设置值了吗?
|
||||
大体上是这样,但是条件可能还要更严格一些,刚是可寻址还不够,比如当`struct`里含有未导出字段时,这个未导出字段时不可设置的。所以,在`reflect`包下有一个专门的方法用于判断这个值是否可修改:`CanSet()`
|
||||
假设我们将`Student`的`score`字段改为未导出的,然后运行以下代码:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
score: 90.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
f := v.Elem().Field(0)
|
||||
fmt.Println(f.CanSet())
|
||||
f2 := v.Elem().Field(2)
|
||||
fmt.Println(f2.CanSet())
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
true
|
||||
false
|
||||
```
|
||||
可以看到,可导出字段`Name`是可设置的,而不可导出字段`score`是不可设置的。当我们判定一个值是可设置之后,接下来要怎么修改这个值呢?
|
||||
`reflect.Value`为基础类型提供了一系列特殊的`Set`方法:`SetInt`、`SetUint`、`SetFloat`等在反射的时候修改对应类型值。
|
||||
下面看个具体例子:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
f := v.Elem().Field(0)
|
||||
f.SetString("lisi")
|
||||
fmt.Printf("st = %+v\n", st)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
st = &{Name:lisi Age:18 Score:90.5}
|
||||
```
|
||||
可以看到,通过调用第一个字段`reflect.value`的`SetString`方法,将`st`对象的`Name`改为了`lisi`。
|
||||
|
||||
## 结构体标签
|
||||
|
||||
|
||||
当我们判定一个值是可设置之后,接下来要怎么修改这个值呢?
|
||||
|
||||
`reflect.Value`为基础类型提供了一系列特殊的`Set`方法:`SetInt`、`SetUint`、`SetFloat`等在反射的时候修改对应类型值。
|
||||
|
||||
下面看个具体例子:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string
|
||||
Age int
|
||||
Score float64
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
v := reflect.ValueOf(st)
|
||||
f := v.Elem().Field(0)
|
||||
f.SetString("lisi")
|
||||
fmt.Printf("st = %+v\n", st)
|
||||
}
|
||||
```
|
||||
|
||||
运行结果:
|
||||
```
|
||||
st = &{Name:lisi Age:18 Score:90.5}
|
||||
```
|
||||
|
||||
可以看到,通过调用第一个字段`reflect.value`的`SetString`方法,将`st`对象的`Name`改为了`lisi`。
|
||||
|
||||
### 结构体标签
|
||||
我们在定义结构体的时候,可以为每个字段后面加一个标签,即`StructTag`,标签其实就是一组键值对,每个键值对用空格分开,这些标签信息可以通过反射获取:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"reflect"
|
||||
)
|
||||
|
||||
type Student struct {
|
||||
Name string `json:"name"`
|
||||
Age int `json:"age"`
|
||||
Score float64 `json:"score"`
|
||||
}
|
||||
|
||||
func main() {
|
||||
st := &Student{
|
||||
Name: "zhangsan",
|
||||
Age: 18,
|
||||
Score: 90.5,
|
||||
}
|
||||
t := reflect.TypeOf(st).Elem()
|
||||
for i := 0; i < t.NumField(); i++ {
|
||||
f := t.Field(i)
|
||||
fmt.Println(f.Tag)
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
json:"name"
|
||||
json:"age"
|
||||
json:"score"
|
||||
```
|
||||
|
||||
## 反射的优缺点
|
||||
优点:
|
||||
- 可以提升程序代码的灵活性,根据条件在程序运行时灵活的调用函数,并且修改源代码结构
|
||||
|
||||
缺点:
|
||||
- 主要是性能影响,反射过程中会有大量的内存开辟和gc过程,导致程序的性能降低
|
||||
@@ -0,0 +1,253 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- 定时器
|
||||
- 并发
|
||||
---
|
||||
|
||||
# 定时器
|
||||
在我们项目中,常常会有这样的场景,比如到了未来某一时刻,需要某个逻辑或者某个任务执行一次,或者是周期性的的执行多次,有点类似定时任务。这种场景就需要用到定时器,Go语言中也内置了定时器的实现,`timer`和`ticker`。
|
||||
|
||||
## Timer
|
||||
`Timer`是一种一次性时间定时器,即在未来某个时刻,触发的事件只会执行一次。
|
||||
|
||||
### Timer的结构定义
|
||||
```go
|
||||
type Timer struct {
|
||||
C <-chan Time
|
||||
r runtimeTimer
|
||||
}
|
||||
```
|
||||
`Timer`结构里有一个`Time`类型的管道`C`,主要用于事件通知。在未到达设定时间的时候,管道内没有数据写入,一直处于阻塞状态,到达设定时间后,会向管道内写入一个系统时间,触发事件。
|
||||
|
||||
### 创建Timer
|
||||
```go
|
||||
func NewTimer(d Duration) *Timer
|
||||
```
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
timer := time.NewTimer(2 * time.Second) //设置超时时间2s
|
||||
<-timer.C
|
||||
fmt.Println("after 2s Time out!")
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
after 2s Time out!
|
||||
```
|
||||
程序在`2s`后打印`"after 2s Time out!"`,因为创建了一个定时器`timer`,设置了超时时间为`2s`,执行`<-timer.C`会一直阻塞,直到`2s`后,程序继续执行。
|
||||
|
||||
### 停止Timer
|
||||
```go
|
||||
func (t *Timer) Stop() bool
|
||||
```
|
||||
返回值:
|
||||
- `true`:执行`stop()`时`timer`还没有到达超时时间,即超时时间内停止了`timer`
|
||||
- `false`:执行`stop()`时`timer`到达了超时时间,过了超时时间才停止`timer`
|
||||
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
timer := time.NewTimer(2 * time.Second) //设置超时时间2s
|
||||
res := timer.Stop()
|
||||
fmt.Println(res)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
true
|
||||
```
|
||||
|
||||
### 重置Timer
|
||||
|
||||
```go
|
||||
func (t *Timer) Reset(d Duration) bool
|
||||
```
|
||||
|
||||
对于已经过期或者是已经停止的`timer`,可以通过重置方法激活使其继续生效。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
timer := time.NewTimer(time.Second * 2)
|
||||
|
||||
<-timer.C
|
||||
fmt.Println("time out1")
|
||||
|
||||
res1 := timer.Stop()
|
||||
fmt.Printf("res1 is %t\n", res1)
|
||||
|
||||
timer.Reset(time.Second * 3)
|
||||
|
||||
res2 := timer.Stop()
|
||||
fmt.Printf("res2 is %t\n", res2)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
time out1
|
||||
res1 is false
|
||||
res2 is true
|
||||
```
|
||||
程序2s之后打印"time out1",此时`timer`已经过期了,所以`res1`的值为`false`,接下来执行`timer.Reset(time.Second * 3)`又使`timer`生效了,并且重设超时时间为3s,但是紧接着执行了`timer.Stop()`,还未到超时时间,所以`res2`的值为`true`。
|
||||
|
||||
### time.AfterFunc
|
||||
方法定义:
|
||||
```go
|
||||
func AfterFunc(d Duration, f func()) *Timer
|
||||
```
|
||||
`time.AfterFunc`参数为超时时间`d`和一个具体的函数`f`,返回一个`Timer`的指针,作用在创建出`timer`之后,在当前`goroutine`,等待一段时间`d`之后,将执行`f`。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
duration := time.Duration(1) * time.Second
|
||||
|
||||
f := func() {
|
||||
fmt.Println("f has been called after 1s by time.AfterFunc")
|
||||
}
|
||||
|
||||
timer := time.AfterFunc(duration, f)
|
||||
defer timer.Stop()
|
||||
|
||||
time.Sleep(2 * time.Second)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
f has been called after 1s by time.AfterFunc
|
||||
```
|
||||
1s之后打印语句。
|
||||
|
||||
### time.After
|
||||
方法定义:
|
||||
```go
|
||||
func After(d Duration) <-chan Time {
|
||||
return NewTimer(d).C
|
||||
}
|
||||
```
|
||||
根据函数定义可以看到,`after`函数会返回`timer`里的管道,并且这个管道会在经过时段`d`之后写入数据,调用这个函数,就相当于实现了定时器。一般`time.After`会配合`select`一起使用,使用示例如下:
|
||||
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func main() {
|
||||
ch := make(chan string)
|
||||
|
||||
go func() {
|
||||
time.Sleep(time.Second * 3)
|
||||
ch <- "test"
|
||||
}()
|
||||
|
||||
select {
|
||||
case val := <-ch:
|
||||
fmt.Printf("val is %s\n", val)
|
||||
case <-time.After(time.Second * 2):
|
||||
fmt.Println("timeout!!!")
|
||||
}
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
timeout!!!
|
||||
```
|
||||
程序创建了一个管道`ch`,并且在主`goroutine`用`select`监听两个管道,一个是刚刚创建的`ch`,一个是`time.After`函数返回的管道`c`,`ch`管道3s之后才会有数据写入,而`time.After`函数是2s超时,所以2s后就会有数据写入,这样`select`会先收到管道`c`里的数据,执行`timeout`退出。
|
||||
|
||||
## Ticker
|
||||
|
||||
### Ticker创建
|
||||
方法定义如下:
|
||||
```go
|
||||
func NewTicker(d Duration) *Ticker
|
||||
```
|
||||
`NewTicker`用于返回一个`Ticker`对象。
|
||||
|
||||
### Ticker对象定义
|
||||
```go
|
||||
type Ticker struct {
|
||||
C <-chan Time // The channel on which the ticks are delivered.
|
||||
r runtimeTimer
|
||||
}
|
||||
```
|
||||
`Ticker`对象的字段和`Timer`是一样的,也包含一个通道字段,并会每隔时间段`d`就向该通道发送当时的时间,根据这个管道消息来触发事件,但是`ticker`只要定义完成,就从当前时间开始计时,每隔固定时间都会触发,只有关闭`Ticker`对象才不会继续发送时间消息。
|
||||
使用示例:
|
||||
```go
|
||||
package main
|
||||
|
||||
import (
|
||||
"fmt"
|
||||
"time"
|
||||
)
|
||||
|
||||
func Watch() chan struct{} {
|
||||
ticker := time.NewTicker(1 * time.Second)
|
||||
|
||||
ch := make(chan struct{})
|
||||
go func(ticker *time.Ticker) {
|
||||
defer ticker.Stop()
|
||||
for {
|
||||
select {
|
||||
case <-ticker.C:
|
||||
fmt.Println("watch!!!")
|
||||
case <-ch:
|
||||
fmt.Println("Ticker Stop!!!")
|
||||
return
|
||||
}
|
||||
}
|
||||
}(ticker)
|
||||
return ch
|
||||
}
|
||||
|
||||
func main() {
|
||||
ch := Watch()
|
||||
time.Sleep(5 * time.Second)
|
||||
ch <- struct{}{}
|
||||
close(ch)
|
||||
}
|
||||
```
|
||||
运行结果:
|
||||
```
|
||||
watch!!!
|
||||
watch!!!
|
||||
watch!!!
|
||||
watch!!!
|
||||
watch!!!
|
||||
Ticker Stop!!!
|
||||
```
|
||||
`Watch`函数里创建一个`ticker`,将它传递到子`goroutine`函数,每隔1s打印"watch!!!",主函数创建一个管道`ch`,通过`ch`来控制`go func()`函数的退出,在5s之后主函数发送一个信号到`ch`,`watch`函数`select`收到`ch`信号,将`return`,在`return`之前将执行`defer ticker.Stop()`语句关闭`ticker`。在这5s之间,`select`将每个1s收到`ticker.C`管道里的消息,打印"watch!!!"。
|
||||
|
||||
> 注意:调用`ticker.Stop()`只会停止`ticker`,但并不会关闭`ticker.C`这个管道,所以我们需要用这个`channel`来控制`watch`函数中的`goroutine`能够退出。
|
||||
@@ -0,0 +1,33 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go基础语法
|
||||
- 并发概述
|
||||
---
|
||||
|
||||
# 并发概述
|
||||
|
||||
## 进程与线程
|
||||
谈到并发或者并行一个绕不开的话题就是进程和线程,弄清楚进程与线程的本质是并发编程的前提,那么究竟什么是进程,什么是线程呢?
|
||||
可以这样理解:
|
||||
- 进程就是运行着的程序,它是程序在操作系统的一次执行过程,是一个程序的动态概念,进程是操作系统分配资源的基本单位
|
||||
- 线程可以理解为一个进程的执行实体,它是比进程粒度更小的执行单元,也是真正运行在cpu上的执行单元,线程是CPU调度资源的基本单位
|
||||
进程中可以包含多个线程,需要记住进程和线程一个是操作系统分配资源的基本单位(进程),一个是操作系统调度资源的基本单位(线程)
|
||||
|
||||
## 协程
|
||||
协程可以理解为用户态线程,是更微量级的线程。区别于线程,协程的调度在用户态进行,不需要切换到内核态,所以不由操作系统参与,由用户自己控制。在一些支持协程高级语言中,往往这些语言都实现了自己的协程调度器,比如go语言就有自己的协程调度器,这个会在后面专门讲协程调度原理的时候讲。
|
||||
- 协程有独立的栈空间,但是共享堆空间。
|
||||
- 一个进程上可以跑多个线程,一个线程上可以跑多个协程
|
||||
|
||||
## 并发与并行
|
||||
很多时候大家对于并行和并发的概念还比较模糊,其实只需要根据一点来判断即可,能不能同时运行。两个任务能同时运行就是并行,不能同时运行,而是每个任务执行一小段,交叉执行,这种模式就是并发。
|
||||
|
||||

|
||||
|
||||

|
||||
|
||||
如图(并行)所示,两个任务一直运行,切实同时运行着,这就是并行模式,要注意并行的话一定要有多个核的支持,因为只有一个cpu的话,同一时间只能跑一个任务,如图(并发)所示,两个任务,每次只执行一小段,这样交叉的执行,就是并发模式,并发模式在单核cpu上是可以完成的
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,345 @@
|
||||
---
|
||||
tags:
|
||||
- Go
|
||||
- golang
|
||||
- go进阶
|
||||
- 泛型
|
||||
---
|
||||
|
||||
# 泛型
|
||||
在Go 1.18版本中,泛型特性被引入,这是Go语言自发布以来最重要的更新之一。
|
||||
|
||||
## 什么是泛型
|
||||
泛型允许开发者在编写代码时不必立即指定具体的数据类型,而是在使用时再确定。换句话说,泛型使得我们可以编写适用于多种数据类型的通用代码。
|
||||
泛型是一种编写与具体类型无关的代码的方法,它使得我们可以创建适用于多种类型的函数和数据结构。
|
||||
|
||||
## 为什么需要泛型
|
||||
假设我们需要实现一个函数来计算切片中元素的总和:
|
||||
```go
|
||||
func sumInts(numbers []int) int {
|
||||
total := 0
|
||||
for _, num := range numbers {
|
||||
total += num
|
||||
}
|
||||
return total
|
||||
}
|
||||
|
||||
fmt.Println(sumInts([]int{1, 2, 3, 4})) // 10
|
||||
```
|
||||
然而,这个函数只能处理`[]int`类型的切片。如果我们想支持`[]float64`类型的切片,就需要再定义一个类似的函数:
|
||||
```go
|
||||
func sumFloats(numbers []float64) float64 {
|
||||
total := 0.0
|
||||
for _, num := range numbers {
|
||||
total += num
|
||||
}
|
||||
return total
|
||||
}
|
||||
```
|
||||
如果我们还需要支持其他类型的切片,就需要再定义相应的函数。这种重复的代码显然是低效的,因为计算总和的逻辑并不依赖于具体的元素类型。
|
||||
|
||||
在Go 1.18之前,我们可以通过反射来解决这个问题,但反射会降低代码的执行效率,并且失去了编译期的类型检查,同时大量的反射代码也会让程序变得难以理解。
|
||||
|
||||
类似这样的场景非常适合使用泛型。从Go 1.18开始,我们可以使用泛型来编写一个适用于所有元素类型的通用`sum`函数:
|
||||
|
||||
```go
|
||||
func sumGeneric[T int | float64](numbers []T) T {
|
||||
var total T
|
||||
for _, num := range numbers {
|
||||
total += num
|
||||
}
|
||||
return total
|
||||
}
|
||||
```
|
||||
|
||||
## 泛型语法
|
||||
泛型为Go语言引入了三个重要的新特性:
|
||||
|
||||
1. 支持在函数和类型定义中使用类型参数,使其更加通用。
|
||||
2. 扩展了接口的概念,使其可以表示一组类型的集合,不再局限于方法集。
|
||||
3. 引入智能类型推导机制,在很多场景下可以省略显式的类型参数。
|
||||
|
||||
### 类型参数
|
||||
|
||||
#### 类型形参和类型实参
|
||||
|
||||
函数在使用上需要在函数定义时指定形参,函数调用时需要传入实参。
|
||||
|
||||

|
||||
|
||||
在引入范型后,Go语言的函数和类型现在可以包含类型参数。类型参数列表的语法类似于普通参数列表,但使用方括号(`[]`)而不是圆括号(`()`)。
|
||||
|
||||

|
||||
|
||||
借助泛型,我们可以声明一个适用于**一组类型**的`max`函数。
|
||||
|
||||
```go
|
||||
func max[T int | float64](a, b T) T {
|
||||
if a > b {
|
||||
return a
|
||||
}
|
||||
return b
|
||||
}
|
||||
```
|
||||
|
||||
#### 类型实例化
|
||||
|
||||
这次定义的`max`函数同时支持`int`和`float64`两种类型,也就是说当调用`max`函数时,我们既可以传入`int`类型的参数。
|
||||
|
||||
```go
|
||||
m1 := max[int](3, 5) // 5
|
||||
```
|
||||
|
||||
也可以传入`float64`类型的参数。
|
||||
|
||||
```go
|
||||
m2 := max[float64](2.5, 3.5) // 3.5
|
||||
```
|
||||
|
||||
向 `max` 函数提供类型参数(在本例中为`int`和`float64`)称为实例化( _instantiation_ )。
|
||||
|
||||
类型实例化分两步进行:
|
||||
|
||||
1. 首先,编译器在整个泛型函数或类型中将所有类型形参(type parameters)替换为它们各自的类型实参(type arguments)。
|
||||
2. 其次,编译器验证每个类型参数是否满足相应的约束。
|
||||
|
||||
在成功实例化之后,我们将得到一个非泛型函数,它可以像任何其他函数一样被调用。例如:
|
||||
|
||||
```go
|
||||
fmax := max[float64] // 类型实例化,编译器生成T=float64的max函数
|
||||
m2 = fmax(1.2, 2.3) // 2.3
|
||||
```
|
||||
|
||||
`max[float64]`得到的是类似我们之前定义的`maxFloat64`函数——`fmax`,我们可以在函数调用中使用它。
|
||||
|
||||
#### 类型参数的使用
|
||||
|
||||
除了函数中支持使用类型参数列表外,类型也可以使用类型参数列表。
|
||||
|
||||
```go
|
||||
type List[T any] []T
|
||||
|
||||
type Pair[K comparable, V any] struct {
|
||||
Key K
|
||||
Value V
|
||||
}
|
||||
|
||||
type Node[T any] struct {
|
||||
next *Node[T]
|
||||
value T
|
||||
}
|
||||
```
|
||||
|
||||
在上述泛型类型中,`T`、`K`、`V`都属于类型形参,类型形参后面是类型约束,类型实参需要满足对应的类型约束。
|
||||
|
||||
泛型类型可以有方法,例如为上面的`Node`实现一个添加元素的`Add`方法。
|
||||
|
||||
```go
|
||||
func (n *Node[T]) Add(value T) {
|
||||
newNode := &Node[T]{value: value}
|
||||
n.next = newNode
|
||||
}
|
||||
```
|
||||
|
||||
要使用泛型类型,必须进行实例化。`Node[string]`是使用类型实参`string`实例化 `Node` 的示例。
|
||||
|
||||
```go
|
||||
var stringNode Node[string]
|
||||
```
|
||||
|
||||
#### 类型约束
|
||||
|
||||
普通函数中的每个参数都有一个类型;该类型定义一系列值的集合。例如,我们上面定义的非泛型函数`maxFloat64`那样,声明了参数的类型为`float64`,那么在函数调用时允许传入的实际参数就必须是可以用`float64`类型表示的浮点数值。
|
||||
|
||||
类似于参数列表中每个参数都有对应的参数类型,类型参数列表中每个类型参数都有一个**类型约束**。类型约束定义了一个类型集——只有在这个类型集中的类型才能用作类型实参。
|
||||
|
||||
Go语言中的类型约束是接口类型。
|
||||
|
||||
就以上面提到的`max`函数为例,我们来看一下类型约束常见的两种方式。
|
||||
|
||||
类型约束接口可以直接在类型参数列表中使用。
|
||||
|
||||
```go
|
||||
// 类型约束字面量,通常外层interface{}可省略
|
||||
func max[T interface{ int | float64 }](a, b T) T {
|
||||
if a > b {
|
||||
return a
|
||||
}
|
||||
return b
|
||||
}
|
||||
```
|
||||
|
||||
作为类型约束使用的接口类型可以事先定义并支持复用。
|
||||
|
||||
```go
|
||||
// 事先定义好的类型约束类型
|
||||
type Number interface {
|
||||
int | float64
|
||||
}
|
||||
func max[T Number](a, b T) T {
|
||||
if a > b {
|
||||
return a
|
||||
}
|
||||
return b
|
||||
}
|
||||
```
|
||||
|
||||
在使用类型约束时,如果省略了外层的`interface{}`会引起歧义,那么就不能省略。例如:
|
||||
|
||||
```go
|
||||
type PtrSlice[T *int] []T // T*int ?
|
||||
|
||||
type PtrSlice[T *int,] []T // 只有一个类型约束时可以添加`,`
|
||||
type PtrSlice[T interface{ *int }] []T // 使用interface{}包裹
|
||||
```
|
||||
|
||||
### 类型集
|
||||
|
||||
**从Go1.18版本开始,接口类型的定义发生了变化,不再仅仅定义方法集(method set),而是定义类型集(type set)。** 这意味着接口类型不仅可以作为值的类型,还可以作为类型约束使用。
|
||||
|
||||

|
||||
|
||||
将接口类型视为类型集而不是方法集的一个好处是:我们可以显式地向类型集中添加类型,从而以新的方式控制类型集。
|
||||
|
||||
事实上,Go语言扩展了接口类型的语法,使我们能够在接口中添加类型。例如
|
||||
|
||||
```go
|
||||
type Value interface {
|
||||
int | string | bool
|
||||
}
|
||||
```
|
||||
上述的代码定义了一个包含 `int`、 `string` 和 `bool` 类型的类型集。
|
||||
|
||||

|
||||
|
||||
自 Go 1.18 起,接口不仅可以嵌入其他接口,还可以嵌入任意类型、类型的联合或具有相同底层类型的无限类型集合。当接口用作类型约束时,其定义的类型集会精确地指定允许作为相应类型参数的类型。
|
||||
|
||||
1. `|`符号
|
||||
使用`|`运算符可以将多个类型组合成一个类型集合,例如`T1 | T2`表示一个包含类型T1和T2的类型集。下面的`Numeric`接口就定义了一个由`Integer`和`Float`类型组成的类型集。
|
||||
```go
|
||||
type Numeric interface {
|
||||
Integer | Float
|
||||
}
|
||||
```
|
||||
|
||||
2. `~`符号
|
||||
`~T`运算符用于匹配所有以T为底层类型的类型集合。比如`~string`不仅匹配string类型本身,还会匹配所有以string为底层类型的自定义类型。
|
||||
```go
|
||||
type CustomString string // CustomString的底层类型是string
|
||||
```
|
||||
**注意:**`~`符号后面只能是基本类型。
|
||||
接口作为类型集合的新机制为Go语言带来了强大的类型约束能力。需要注意的是,目前这种使用新语法定义的接口类型仅限于作为类型约束使用,不能作为普通的接口类型使用。
|
||||
|
||||
#### any接口
|
||||
Go 1.18版本中引入了一个新的预声明标识符`any`,它是空接口类型`interface{}`的别名。这个别名的引入可以在类型参数列表中使用时提供更简洁的语法。
|
||||
```go
|
||||
// src/builtin/builtin.go
|
||||
type any = interface{}
|
||||
```
|
||||
|
||||
由此,我们可以使用如下代码:
|
||||
|
||||
```go
|
||||
func process[S ~[]E, E any](data S) {
|
||||
// 处理数据
|
||||
}
|
||||
```
|
||||
|
||||
### 类型推断
|
||||
|
||||
类型推断可以让编译器自动推导出类型参数的具体类型,从而简化泛型函数的调用语法。虽然类型推断的实现机制比较复杂,但它极大地提升了泛型代码的使用体验,让开发者可以更自然地编写和调用泛型函数。
|
||||
|
||||
#### 函数参数类型推断
|
||||
|
||||
在使用泛型函数时,如果每次都需要显式指定类型参数会比较麻烦。以我们以之前的 `max` 函数为例:
|
||||
```go
|
||||
func max[T int | float64](a, b T) T {
|
||||
if a > b {
|
||||
return a
|
||||
}
|
||||
return b
|
||||
}
|
||||
```
|
||||
在这个函数中,`T`是一个类型形参,它定义了`a`和`b`参数的类型。调用这个函数时,我们可以明确指定类型实参:
|
||||
```go
|
||||
var x, y, result float64
|
||||
result = max[float64](x, y) // 显式指定类型实参
|
||||
```
|
||||
|
||||
在大多数情况下,编译器能够根据传入的参数自动推导出类型参数 `T` 的具体类型。这种类型推导机制让我们可以省略显式的类型参数声明,使代码更加简洁优雅。
|
||||
|
||||
```go
|
||||
var x, y, result float64
|
||||
result = max(x, y) // 无需指定类型实参
|
||||
```
|
||||
这种类型推断机制被称为函数实参类型推断,它可以根据传入的实参自动推导出函数的类型参数。但需要注意的是,这种推断只对函数参数中使用的类型参数有效,对于那些仅在返回值或函数体内部使用的类型参数则无法推断。比如对于 `CreateT[T any]() T` 这样的函数,由于类型参数 `T` 只用在返回值中,编译器就无法进行类型推断。
|
||||
|
||||
#### 约束类型推断
|
||||
|
||||
Go 语言还提供了一种称为_约束类型推断_的机制。为了更好地理解这个概念,让我们通过一个处理整数缩放的示例来说明:
|
||||
|
||||
```go
|
||||
// MultiplyEach 返回切片中每个元素都乘以factor的副本切片
|
||||
func MultiplyEach[E constraints.Integer](s []E, factor E) []E {
|
||||
result := make([]E, len(s))
|
||||
for i, v := range s {
|
||||
result[i] = v * factor
|
||||
}
|
||||
return result
|
||||
}
|
||||
```
|
||||
|
||||
上面的泛型函数可以处理任何整数类型的切片数据。
|
||||
|
||||
让我们来看一个具体的应用场景。假设我们需要处理一个表示多维坐标的 `Vector` 类型。从本质上说,`Vector` 就是一个存储坐标值的整数切片。为了方便使用,我们为这个类型添加了一些额外的功能,比如一个用于格式化输出的 `String` 方法。
|
||||
|
||||
```go
|
||||
type Vector []int32
|
||||
|
||||
func (v Vector) String() string {
|
||||
b, _ := json.Marshal(v)
|
||||
return string(b)
|
||||
}
|
||||
```
|
||||
|
||||
因为`Vector`类型本质上是一个整数切片,所以我们可以尝试直接使用之前定义的`MultiplyEach`函数来处理它:
|
||||
|
||||
```go
|
||||
func MultiplyAndDisplay(v Vector) {
|
||||
result := MultiplyEach(v, 3)
|
||||
fmt.Println(result.String()) // 编译失败
|
||||
}
|
||||
```
|
||||
|
||||
这段代码在编译时会失败,错误信息为`result.String undefined (type []int32 has no field or method String`。
|
||||
|
||||
这个问题的根源在于泛型函数`MultiplyEach`的返回值类型。该函数返回一个`[]E`类型的切片,其中`E`是切片元素的类型。当我们传入`Vector`类型(底层是`[]int32`)时,函数返回的是一个普通的`[]int32`切片,而不是我们期望的`Vector`类型。这导致返回值无法调用`Vector`类型特有的`String`方法。
|
||||
|
||||
要修复这个问题,我们需要修改`MultiplyEach`函数的定义,让它能够保持输入切片的具体类型。我们需要为切片本身引入一个新的类型参数。
|
||||
|
||||
```go
|
||||
func MultiplyEach[S ~[]E, E constraints.Integer](s S, factor E) S {
|
||||
result := make(S, len(s))
|
||||
for i, v := range s {
|
||||
result[i] = v * factor
|
||||
}
|
||||
return result
|
||||
}
|
||||
```
|
||||
|
||||
我们添加了一个新的类型参数`S`,它代表切片的具体类型。通过约束`~[]E`,我们指定了`S`必须是一个元素类型为`E`的切片类型。函数返回值类型也改为`S`,这样就能保持输入切片的原始类型。在函数实现中,唯一的变化是使用`S`而不是`[]E`来创建结果切片。
|
||||
|
||||
这样修改后的`MultiplyEach`函数既可以处理普通的整数切片,也可以处理`Vector`这样的自定义切片类型。
|
||||
|
||||
这里有一个有趣的问题:为什么我们可以直接调用`MultiplyEach(v, 3)`而不需要显式指定类型参数,即不需要写成`MultiplyEach[Vector, int32](v, 3)`?
|
||||
|
||||
`MultiplyEach`函数定义了两个类型参数:`S`和`E`。当我们调用`MultiplyEach(v, 3)`时,编译器通过函数参数类型推断可以确定`S`的类型是`Vector`。但对于类型参数`E`,由于`3`是一个无类型常量,仅通过参数类型推断无法确定其具体类型(它可能被推断为默认的`int`类型,这与`Vector`的底层类型`[]int32`不匹配)。这时,编译器会使用一种叫做**约束类型推断**的机制。
|
||||
|
||||
约束类型推断是指编译器根据类型参数的约束关系来推导类型参数。当一个类型参数的约束是基于另一个类型参数定义的,并且其中一个类型参数已知时,就可以通过约束关系推断出另一个类型参数。
|
||||
|
||||
在我们的例子中,`S`的约束是`~[]E`,这表明`S`必须是一个元素类型为`E`的切片类型。当编译器知道`S`是`Vector`(即`[]int32`)时,就可以通过这个约束关系推断出`E`必须是`int32`。这就是为什么我们可以省略显式的类型参数。
|
||||
|
||||
## 小结
|
||||
泛型的引入为Go语言带来了更强大的抽象能力。当我们在项目中遇到需要为不同类型编写相似逻辑的场景时,泛型可以帮助我们优雅地解决这个问题。它不仅可以减少代码重复,还能保持类型安全。
|
||||
|
||||
泛型和接口各有其适用场景。接口更适合定义对象的行为规范,而泛型则更适合处理与具体类型无关的通用算法和数据结构。两者结合使用,可以让我们的代码更加简洁、安全和可维护。
|
||||
Reference in New Issue
Block a user