🔄Update: Redis
This commit is contained in:

@@ -0,0 +1,19 @@
|
||||
# 主从复制
|
||||
|
||||
**第一次同步**
|
||||
|
||||
1. 建立连接、协商同步
|
||||
2. 数据同步
|
||||
3. 新操作同步
|
||||
|
||||
**命令传播**
|
||||
|
||||
- 完成第一次同步后双方维护 TCP 长连接
|
||||
|
||||
**小问题**
|
||||
|
||||
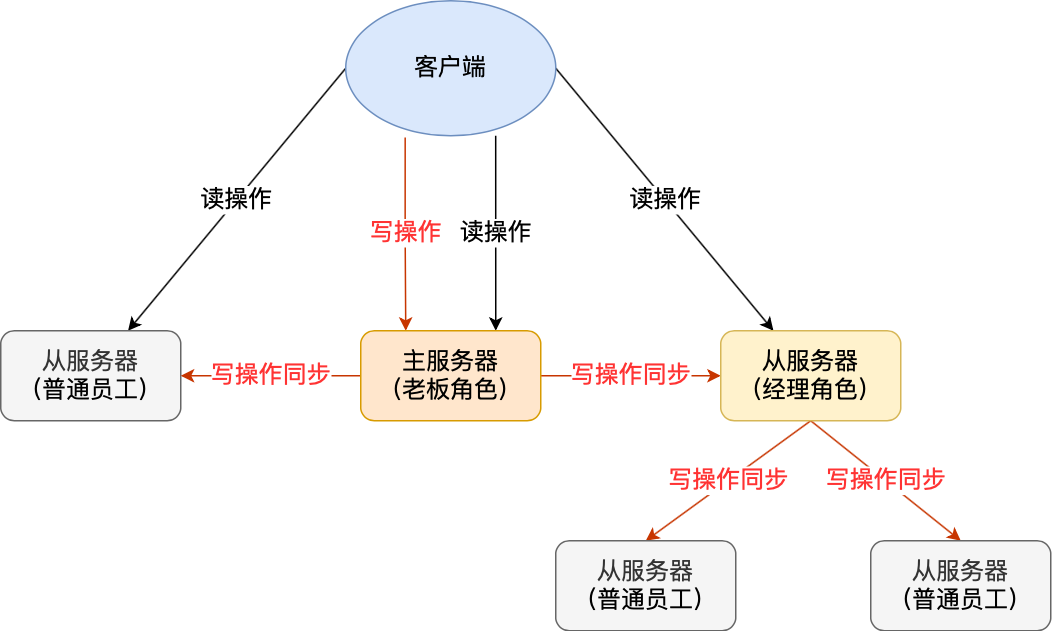
> 如果有很多从节点需要辅助主节点数据,那么生成 RDB 以及命令传播的压力会积累在主节点上,容易影响主线程任务。
|
||||
|
||||
=> 分级机制
|
||||
|
||||
|
||||
@@ -0,0 +1,34 @@
|
||||
# 缓存异常
|
||||
|
||||
**缓存雪崩**
|
||||
|
||||
> “雪崩”:多
|
||||
|
||||
- 大量缓存数据在同一时期过期 or Redis 故障宕机
|
||||
- 数据库压力骤增
|
||||
|
||||
*解决方案——*
|
||||
- 随机数
|
||||
- 互斥锁
|
||||
- 缓存预热/后台线程通知更新
|
||||
|
||||
**缓存击穿**
|
||||
|
||||
> “击穿”:强度
|
||||
|
||||
- 某个热点数据过期
|
||||
|
||||
*解决方案——*
|
||||
- 互斥锁
|
||||
- 缓存预热/后台线程通知更新
|
||||
|
||||
**缓存穿透**
|
||||
|
||||
> “穿透”:主观、有目的
|
||||
|
||||
- 用户访问的数据,既不在缓存中,也不在数据库中
|
||||
|
||||
*解决方案——*
|
||||
- 限制非法请求
|
||||
- 缓存空值或者默认值
|
||||
- 布隆过滤器判断数据是否存在
|
||||
@@ -0,0 +1,112 @@
|
||||
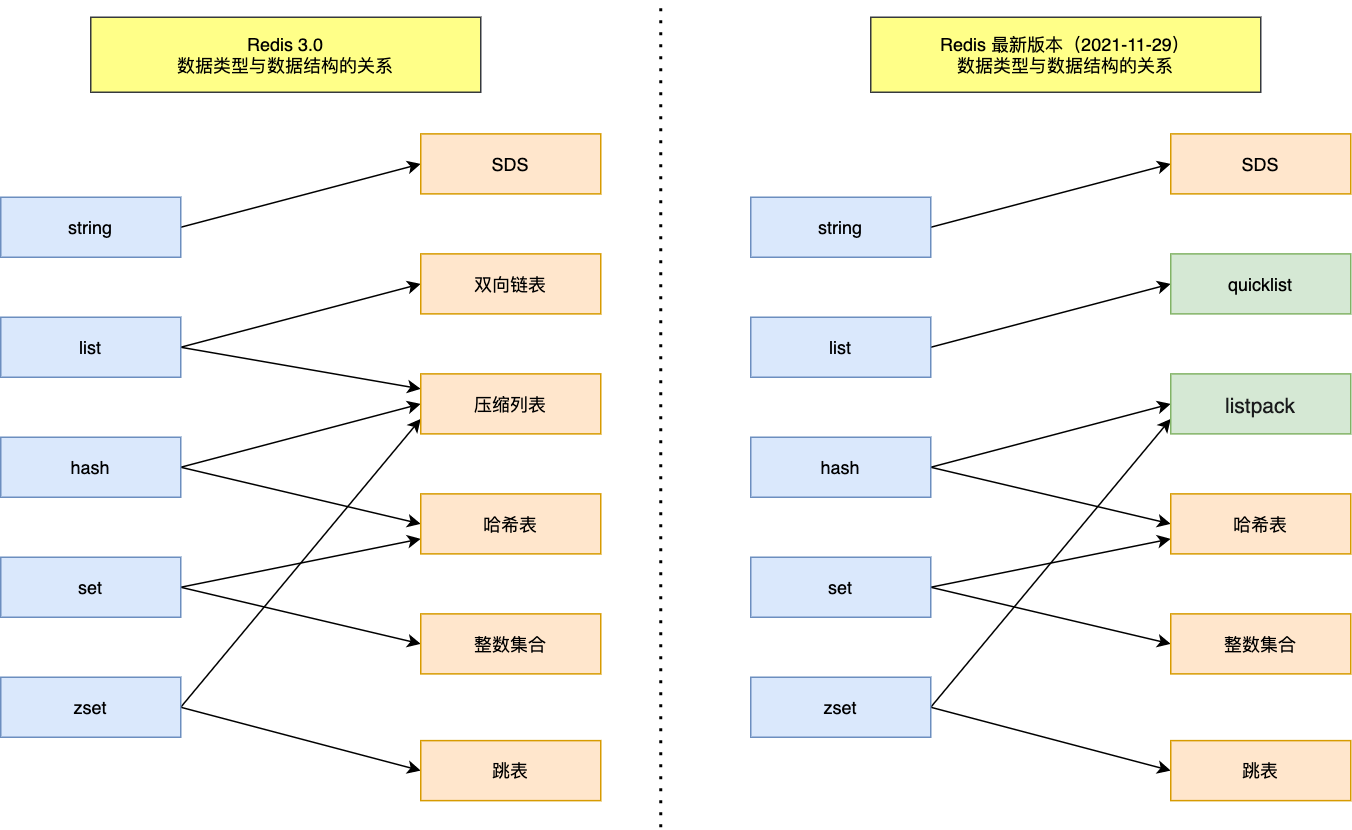
# 数据类型与数据结构
|
||||
|
||||
|
||||
|
||||
## SDS
|
||||
|
||||
- 基于 C 语言
|
||||
- 改进 C 字符串
|
||||
- C 字符串缺陷
|
||||
- 长度统计慢
|
||||
- 无法存二进制数据 `\0`提前结束
|
||||
- 新设计
|
||||
- `len` 字符串长度
|
||||
- `alloc` 分配空间长度
|
||||
- `flags` sds 类型
|
||||
- `buf[]` 字节数组
|
||||
- 扩容机制
|
||||
- `<1MB` 翻倍
|
||||
- `>=1MB` +1MB
|
||||
- 应用场景
|
||||
- Redis 中字符串值的底层实现
|
||||
- 用于存储键名和字符串值
|
||||
- 用于实现 Redis 的各种命令,如 GET、SET、APPEND 等
|
||||
- 优势
|
||||
- 高效的字符串拼接操作
|
||||
- 避免缓冲区溢出
|
||||
- 支持二进制数据存储
|
||||
- 高效的长度获取和内存管理
|
||||
|
||||
## quicklist
|
||||
|
||||
- 结构组成
|
||||
- 由多个 listpack 组成的双向链表
|
||||
- 每个 listpack 保存一定数量的元素
|
||||
- 设计目的
|
||||
- 结合了链表和数组的优点
|
||||
- 减少内存碎片
|
||||
- 提高内存使用效率
|
||||
- 应用场景
|
||||
- Redis 中 list 类型的底层实现
|
||||
- 用于存储有序列表数据
|
||||
- 优势
|
||||
- 内存使用更紧凑
|
||||
- 支持快速的头尾插入和删除操作
|
||||
- 可以通过配置控制 listpack 的大小和数量
|
||||
|
||||
## listpack
|
||||
|
||||
- 定义
|
||||
- 一种紧凑的、内存优化的数据结构
|
||||
- 用于存储键值对的列表
|
||||
- 特点
|
||||
- 以连续内存块的形式存储数据
|
||||
- 每个元素包含长度和数据部分
|
||||
- 通过偏移量访问元素
|
||||
- 应用场景
|
||||
- Redis 中 list 类型的底层实现
|
||||
- 用于存储小规模的列表数据
|
||||
- 优势
|
||||
- 内存使用效率高
|
||||
- 适合存储小规模数据集
|
||||
- 读写性能较好
|
||||
|
||||
## 哈希表
|
||||
|
||||
- 定义
|
||||
- 一种基于键值对存储的数据结构
|
||||
- 通过哈希函数计算键的哈希值,确定数据存储位置
|
||||
- 结构组成
|
||||
- 哈希表数组(bucket array)
|
||||
- 每个 bucket 可能包含多个键值对
|
||||
- 链表或树结构处理哈希冲突
|
||||
- 应用场景
|
||||
- Redis 中 hash 类型的底层实现
|
||||
- 用于存储对象属性或配置信息
|
||||
- 优势
|
||||
- 平均时间复杂度为 O(1) 的查找、插入和删除操作
|
||||
- 适合存储键值对数据
|
||||
- 支持动态扩容和缩容
|
||||
|
||||
## 整数集合
|
||||
|
||||
- 定义
|
||||
- 一种专门用于存储整数的有序数据结构
|
||||
- 通过有序数组实现
|
||||
- 特点
|
||||
- 存储的元素都是整数类型
|
||||
- 元素按升序排列
|
||||
- 支持快速查找和范围查询
|
||||
- 应用场景
|
||||
- Redis 中 set 类型的底层实现(当元素都是整数时)
|
||||
- 用于存储有序的整数集合
|
||||
- 优势
|
||||
- 内存使用效率高
|
||||
- 支持高效的查找和范围操作
|
||||
- 适合存储整数数据集
|
||||
|
||||
## 跳表
|
||||
|
||||
- 定义
|
||||
- 一种多层链表结构,通过在链表上添加多级索引提高查找效率
|
||||
- 结构组成
|
||||
- 多层链表结构
|
||||
- 每一层的节点数量递减
|
||||
- 通过概率算法决定节点的层数
|
||||
- 应用场景
|
||||
- Redis 中 sorted set 类型的底层实现
|
||||
- 用于存储有序集合数据
|
||||
- 优势
|
||||
- 平均时间复杂度为 O(log n) 的查找、插入和删除操作
|
||||
- 实现相对简单
|
||||
- 支持范围查询和有序遍历
|
||||
@@ -0,0 +1,23 @@
|
||||
# 过期删除
|
||||
|
||||
**设置过期时间**
|
||||
|
||||
```sh
|
||||
expire <key> <n>
|
||||
pexpire <key> <n>
|
||||
expireat <key> <n>
|
||||
pexpireat <key> <n>
|
||||
|
||||
set <key> <value> ex <n>
|
||||
set <key> <value> px <n>
|
||||
setex <key> <n> <value>
|
||||
```
|
||||
|
||||
**过期删除策略**
|
||||
|
||||
- 定时删除
|
||||
- 手动指定定时事件
|
||||
- 惰性删除
|
||||
- 访问时检查是否过期
|
||||
- 定期删除
|
||||
- 每隔一段时间随机取出检查
|
||||
@@ -0,0 +1,8 @@
|
||||
# 内存淘汰
|
||||
|
||||
*即使键没有过期,也有可能根据设置的策略被淘汰。(但是 Redis 默认不开启,内存超限禁止写入)*
|
||||
|
||||
- LRU
|
||||
- 最近最少使用
|
||||
- LFU
|
||||
- 最近最不常用
|
||||
Reference in New Issue
Block a user